October 9, 2026
Qwen срещу ChatGPT: Кой AI модел превежда по-добре?
Текущото поколение на ChatGPT и Qwen са част от набора от модели, които MachineTranslation.com използва при всеки превод, а не двама външни претенденти, оценявани спрямо самата платформа. Пуснете един и същ текст през двата модела на идентични сегменти и ChatGPT печели по-големия дял от езиковите двойки като цяло. Разделете резултатите по посока и картината рязко се стеснява на едно конкретно място: преводът към английски, където двата модела са почти наравно.
Има ли AI, по-добър от ChatGPT за превод?
Общият интерес към алтернативи на ChatGPT нарасна с подобряването на конкурентните модели, въпреки че причините варират значително в зависимост от конкретния случай на употреба и няма едно-единствено обяснение. Специално за превода по-полезният въпрос е кой модел всъщност се справя по-добре при дадена езикова двойка – въпрос, който подлежи на проверка, а не е въпрос на лично усещане.
През последните 28 дни от трафика на MachineTranslation.com и двата модела са превели идентичен изходен текст в 98 езикови двойки. ChatGPT постигна по-висок резултат в 77 от тези двойки; Qwen постигна по-висок резултат в 21. Претегленият среден резултат за съпоставимите преводи поставя ChatGPT на 9.10 от 10, а Qwen на 8.98 – реална, но умерена разлика средно, която крие много по-рязко разминаване, щом се отчете посоката на превод.
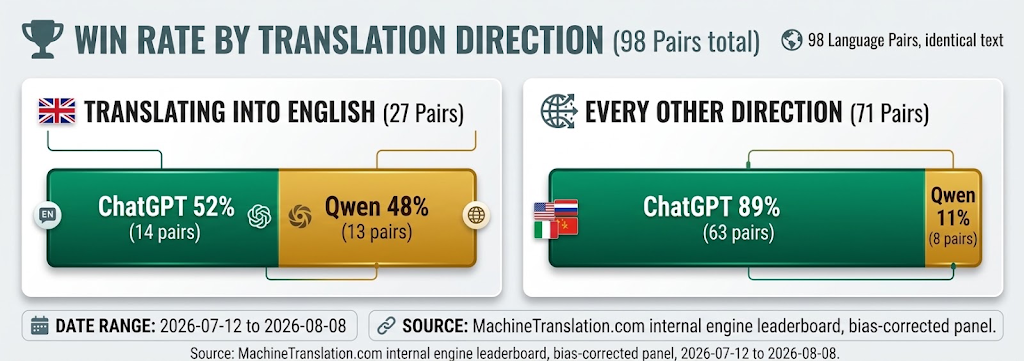
Към английски двата модела са почти наравно. Във всяка друга посока ChatGPT печели голямото мнозинство от тестваните двойки.
| ChatGPT | Qwen | |
|---|---|---|
| Процент оценени резултати | 54.76% | 42.6% |
| Среден резултат | 8.89 / 10 | 8.87 / 10 |
| Най-ниски 10% от резултатите | 7.8 | 7.6 |
| Процент победи, към английски | 52% | 48% |
| Процент победи, във всяка друга посока | 89% | 11% |
Защо разликата почти изчезва при превод към английски?
Данните показват къде се появява разделението, а не защо. Ясно е обаче, че конкурентоспособността на Qwen не е разпределена равномерно. От 27 двойки, при които целевият език е английски, Qwen печели 13 – на практика хвърляне на монета. От останалите 71 двойки, както при превод от английски, така и между два неанглийски езика, ChatGPT печели 63, или 89% от тях. Екип, който приема, че представянето на Qwen към английски се пренася и върху изходящия превод или превода между езикови двойки без английски, би си извадил погрешен извод от грешната посока.
Китайска компания ли е Qwen и има ли това значение за превода?
Qwen е разработен от Alibaba Cloud, базирана в Китай. Само по себе си това не променя колко добре моделът превежда дадено изречение – данните по-горе отразяват действителното качество на резултата, независимо къде е създаден моделът. Където това може да е от значение, е обработката на данни: бизнесите, превеждащи регулирано или чувствително съдържание (договори, медицински досиета, лична информация), трябва да третират въпроса къде доставчикът на AI обработва и съхранява това съдържание като реален въпрос на надлежна проверка (due diligence), отделен от самото качество на превода. Това важи за всеки доставчик на AI, а не конкретно за Qwen, и е част от причината MachineTranslation.com да публикува директно собствените си практики за обработка на данни и сигурност, вместо да оставя въпроса без отговор.
По-надежден ли е някой от двата модела за правен и бизнес превод?
Не постоянно, а и разминаването не винаги се свежда до това кой модел има по-висок резултат. Тестовете на MachineTranslation.com с реални договорни текстове установиха два отделни случая, които си струва да се знаят, преди да се доверите на който и да е от двата модела за правен текст. При идиоматичния език понякога се наблюдава обратна тенденция: отделен пряк тест установи, че ChatGPT превежда немски идиом буквално и неправилно, докато Qwen намира правилното идиоматично значение – напомняне, че цялостното предимство на нито един от моделите в обобщените данни не важи изречение по изречение.
| Тестов казус | ChatGPT | Qwen |
|---|---|---|
| „At-will employment“ на немски | Използваема, функционална формулировка | Използва несвързана правна концепция |
| Клауза за ограничаване на отговорността на испански | „que surjan de“ | „derivados de“ (разлика, променяща обхвата) |
| „Ich verstehe nur Bahnhof“ (немски идиом) | Преведено буквално, неправилно | Правилно идиоматично значение |
Нито един от моделите не печели последователно в тези три случая: обобщеният резултат на даден модел не предсказва поведението му при конкретен термин или фраза. Това е и причината правните и договорните текстове да изискват етап на проверка от човек, независимо кой модел е създал първоначалния вариант.
Как стои въпросът с езиковото покритие?
Нито ChatGPT, нито Qwen публикува проверен, независимо потвърден списък с езикови двойки, при които качеството на превода спада. И двата са модели с общо предназначение с широко многоезично обучение, което е различно твърдение от измерената производителност на превода за конкретен набор от езици. MachineTranslation.com тества и оценява качеството на превода за 330+ езика директно, вместо да разчита на общите езикови възможности на даден модел като показател за това колко добре всъщност превежда той.
Какво не трябва да поставяте в ChatGPT или Qwen за бизнес преводи?
Нито ChatGPT, нито Qwen е създаден като специализирана платформа за превод, а поставянето на чувствително бизнес съдържание директно в чат интерфейс с общо предназначение носи същите въпроси относно обработката на данни, както и поставянето му във всеки друг потребителски AI инструмент: къде се обработва въведеното съдържание, дали се съхранява и кой има достъп до него. Договори, медицински досиета, имиграционни документи и финансови отчети са точно онзи тип съдържание, при което си струва да се отговори на този въпрос преди превода, а не след това. Това е реална причина специализирана платформа за превод с публикувани и проверими практики за обработка на данни да бъде различно предложение от чат интерфейс с общо предназначение, независимо кой модел стои зад всеки от тях.
Как MachineTranslation.com всъщност използва и двата модела
MachineTranslation.com пуска ChatGPT, Qwen и повече от 20 други AI модела при всеки превод, след което извежда версията, за която тези модели постигат най-голямо съгласие. Предвид това колко рязко се разделя производителността на Qwen и ChatGPT според посоката на превод, избирането на един модел като постоянен избор по подразбиране би означавало грешен избор за предвидим дял от езиковите двойки. Същият зависим от посоката модел се проявява и в сравнението Qwen срещу DeepSeek на MachineTranslation.com. За пълна представа за това как съвременните модели се тестват един спрямо друг, вижте пълното сравнително тестване на модели на MachineTranslation.com.
Често задавани въпроси
1. Qwen или ChatGPT е по-добър за превод?
При 98 езикови двойки, тествани върху идентичен изходен текст, ChatGPT постигна по-висок резултат в 77 от тях. Най-силното представяне на Qwen е при превод към английски, където двата модела са почти наравно. Във всяка друга посока ChatGPT печели голямото мнозинство от двойките, така че честният отговор зависи в голяма степен от това в каква посока се движи съдържанието.
2. ChatGPT или Qwen поддържа повече езици?
И двата са AI модели с общо предназначение без проверен, публикуван списък със специфични за отделните езици ограничения. Нито един от тях не публикува независимо потвърдени данни за покритието на езиковите двойки, което е различно от платформа, която тества и оценява качеството на превода за 330+ езика директно, вместо да разчита на общи твърдения за многоезично обучение.
3. Qwen или ChatGPT е по-добър за правни и бизнес преводи?
Нито един от двата не е надеждно по-добър във всяко отношение. При тестване на термин от германското трудово право DeepSeek и ChatGPT предложиха използваема функционална формулировка, докато Claude и Qwen използваха несвързана правна концепция, което показва, че разликата зависи от термина и контекста, а не от това кой модел е като цяло по-силен.
4. Конкурира ли се MachineTranslation.com с ChatGPT и Qwen?
Не. MachineTranslation.com пуска ChatGPT, Qwen и повече от 20 други AI модела при всеки превод и извежда версията, за която тези модели постигат най-голямо съгласие. Платформата тества и комбинира подобни модели, вместо да действа като отделен, конкуриращ се собствен модел.
5. Кой модел да избера за голям проект за локализация?
Нито един от двата самостоятелно не е надежден избор по подразбиране, когато съдържанието преминава през множество езици в двете посоки. Специфичната за посоката разлика, документирана тук, означава, че модел, който се справя добре при превод към английски, може да се представи по съвсем различен начин при превод от него за десетки езикови двойки едновременно.
6. Кой модел на Qwen е най-добър за превод?
Тази информация все още не е налична. Проследяването в MachineTranslation.com в момента отчита Qwen като един енджин без обозначение за версия на модела, за разлика от други доставчици, така че не съществуват данни за качеството по отделни под-версии, които да бъдат докладвани. След като това бъде коригирано, ще бъде възможна реална разбивка между Qwen3.8-Max и Qwen3.8-27B; за момента това е същинска празнина, а не просто неизмерен детайл.