June 5, 2026
Същият ИИ, различен модел — и преводите не биха могли да бъдат по-различни
Правя вътрешни тестове на нещо, за което не говорим достатъчно в преводаческата индустрия: не дали различните AI системи превеждат по различен начин, а дали различни версии на един и същ AI превеждат по различен начин — и с колко.
Миналата седмица пуснах един испански идиом през пет версии на ChatGPT едновременно на вътрешната тестова платформа на MachineTranslation.com. Това, което се върна, ме спря.
Две версии произведоха превод, който е, наистина, безсмислица на английски език. Три версии произведоха правилни идиоматични преводи. А трите верни не се съгласяваха помежду си.
Всичките пет са ChatGPT. Всичките пет са OpenAI. Същият ИИ, различен модел — и резултатите не биха могли да бъдат по-различни.
Споделям това сега, защото смятам, че е важно, а не защото имам ясни отговори. Не. Но наблюдението е достатъчно интересно, за да бъде представено на света. Съдържание Тестът:
- Един испански идиом, пет GPT версии
- Защо този идиом е добър тестов случай
- Какво ни казва разделението от буквално към идиоматично за начина, по който тези модели са били обучени
- Импликацията, за която никой сякаш не говори
- Дори правилните преводи не бяха съгласни помежду си
- Какво още не знам
- Два изследователски въпроса, върху които си струва да се замислим
Тестът: Един испански идиом, пет GPT версии
Фразата, която тествах, беше llevarse el gato al agua.
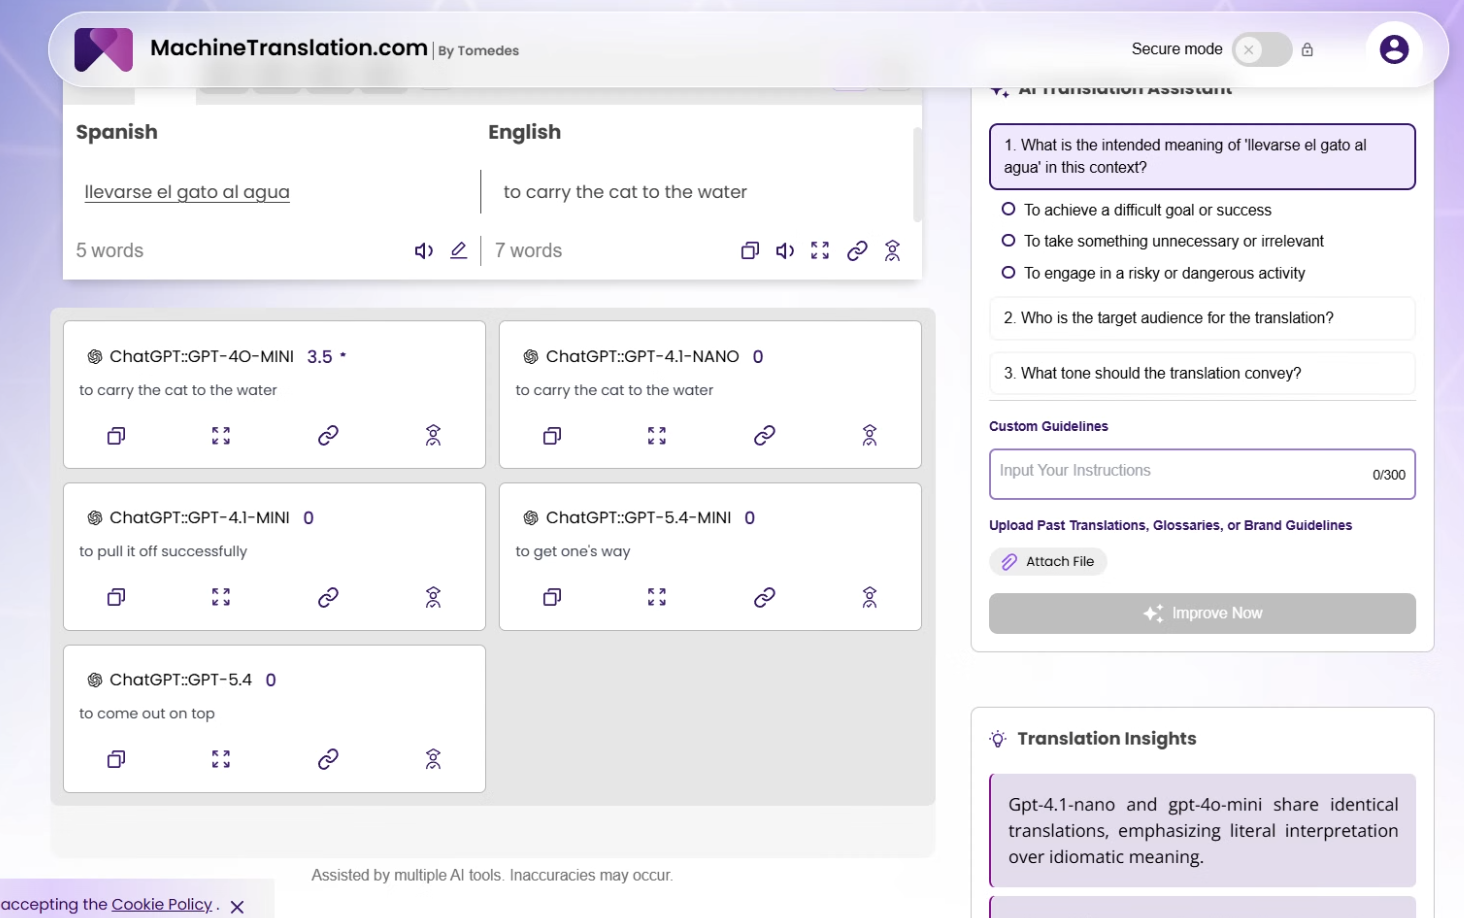
Ето какво произведе всяка версия:
| Модел | Изход | Идиоматично? |
|---|---|---|
| ChatGPT::GPT-4o-MINI | да занесеш котката до водата | ❌ Буквално |
| ChatGPT::GPT-4.1-NANO | да занесеш котката до водата | ❌ Буквално |
| ChatGPT::GPT-4.1-MINI | да го направиш успешно | ✅ Правилно |
| ChatGPT::GPT-5.4-MINI | да постигнеш своето | ✅ Частично |
| ChatGPT::GPT-5.4 | да излезеш на върха | ✅ Правилно |
Фразата означава да постигнеш нещо трудно въпреки шансовете, да извоюваш трудна победа. Няма нищо общо с котки или вода. Буквален превод не е превод. Това е буквално транскрипция на фраза, която моделът не успя да разпознае като идиом.
GPT-4o-MINI и GPT-4.1-NANO произведоха идентични резултати. Не сходни, идентични. Нашите преводически прозрения маркираха това директно: GPT-4.1-nano и GPT-4o-mini споделят идентични преводи, наблягайки на буквален превод пред идиоматично значение.
GPT-4.1-MINI, GPT-5.4-MINI и GPT-5.4 всеки произведе нещо разпознаваемо правилно — но не и същото като другите.
Защо този идиом е добър тестов случай
Искам да бъда точен защо llevarse el gato al agua е полезен тестов вход, а не подбран такъв.
Това е утвърден идиом. Среща се в литературата, журналистиката и ежедневната реч. Не е неясно. Всеки модел, обучен на разумен корпус от испански текст, би трябвало да го е срещал. Въпросът не е дали моделът е видял фразата. Въпросът е какво прави с него.
Най-лошият сценарий на провал при превод на идиоми не е получаването на лош превод. Той произвежда буквален превод, който изглежда приемлив за някой, който не знае целевия език.
„Да занесеш котката до водата“ е граматически правилен английски език. Това е правилно оформено. Звучи като нещо, което би могло да означава нещо. Потребител, който не говори испански, може да го прочете, да кимне и да продължи напред — никога не знаейки, че оригиналното значение е изгубено изцяло.
Това е режимът на отказ, който ме интересува. Не очевидната грешка. Невидимият. Какво ни казва разделението от буквално към идиоматично за това как са обучени тези модели
Моделът тук не е случаен. Двата модела, които произведоха буквални преводи (GPT-4o-MINI и GPT-4.1-NANO), са по-малки, по-леки модели, оптимизирани за скорост и ценова ефективност. Трите модела, които произведоха идиоматични преводи (GPT-4.1-MINI, GPT-5.4-MINI, GPT-5.4), представляват различно поколение или мащаб на параметрите.
Това предполага нещо, което според мен е недостатъчно проучено: идиоматичната компетентност при превода се мащабира с капацитета на модела по начини, които не се виждат в общите бенчмаркове.
Общите езикови бенчмаркове тестват разсъждение, знания, кодиране, математика. Те обикновено не тестват дали един модел може да идентифицира , че падат като из ведро не е свързано с метеорологичните условия, или че llevarse el gato al agua не е свързано с хидратирането на котка. Идиомите се намират на пресечната точка на културното познание, контекстуалното заключение и разпознаването на модели — и тази пресечна точка изглежда изисква праг на капацитета на модела, който по-малките модели не постоянно достигат.
Какво не твърдя: че по-големите модели винаги са по-добри преводачи. Нямам доказателства за това като общо правило. Това, което наблюдавам: че за идиоматично съдържание конкретно, разликата между версиите в рамките на семейството беше по-голяма, отколкото очаквах.
Изводът, за който никой сякаш не говори
Повечето потребители, които използват инструмент за AI превод, не знаят коя версия на този AI използват. Те отварят продукт, избират езикова двойка и получават резултат. Маршрутизацията на модела е невидима за тях.
Това има значение в голям мащаб. MachineTranslation.com обработи над стотици хиляди превода от английски на испански за период от 90 дни. Ако значителна част от тези работни места са били свързани с идиоматично съдържание (маркетингови текстове, правен език, литературен текст, ежедневна комуникация) и инструментът, който е насочвал тези работни места, е насочвал потребителите към по-малък модел без тяхно знание, тогава да занесеш котката до водата се е появявало в реални резултати, в реални документи, за реални хора, които са се доверили на резултата. Преводаческата индустрия е прекарала години в сравняване на AI доставчици. DeepL срещу Google.
Клод срещу ЧатДжиПиТи. Тези сравнения са полезни. Но в рамките на един доставчик, разликата във версиите може да бъде също толкова значителна — и това е разлика, която повечето рамки за сравнение не измерват, защото не тестват на ниво модел-версия. Когато някой каже „Използвам ChatGPT за превод“, това изречение не е достатъчно конкретно, за да бъде смислено.
Кой ChatGPT? Нано? 4o-мини? 4.1-мини? 5.4? Отговорът променя изхода по начини , които не са тривиални, поне за идиоматично съдържание.
Дори „правилните“ преводи не бяха съгласни помежду си
Това е частта, която намирам за най-интересна и все още не съм напълно разбрал какво да правя с нея.
Трите модела, които произведоха идиоматични преводи, дадоха три различни:
- GPT-4.1-MINI: to pull it off successfully
- GPT-5.4-MINI: to get one's way
- GPT-5.4: to come out on top
И трите са защитими английски преводи на llevarse el gato al agua. Но те не са еквивалентни.
Да се справиш набляга на изпълнението спрямо трудността, ти си направил нещо трудно и то е проработило. Да си постигнеш своетонабляга на постигането на желания резултат, с по-малко ударение върху трудността. „Излизам на върха“ подчертава конкурентна победа, печелене спрямо другите.
Оригиналният испански идиом е най-близък до първия от тях. Фразата носи конотацията за преодоляване на съпротива, а не просто предпочитане на един изход и неговото осъществяване. Но „да постигнеш своето“ и „да излезеш победител“ не са грешни, те просто са неточни в различни посоки. Това повдига въпрос, който намирам за наистина труден: когато три модела произведат правилен, но различен идиоматичен превод, как оценявате кой е
най-добрият? BLEU резултатите се сравняват с a референтен превод — но кой е написал референцията и кой от тези три би избрал?
Нашият AI преводачески агент, за негова чест, зададе правилния въпрос преди да се ангажира с какъвто и да е изход: Какво е предвиденото значение на „llevarse el gato al agua“ в този контекст? Предложени бяха три възможности — да се постигне трудна цел, да се вземе нещо ненужно или да се предприеме рискована дейност. Този въпрос не е декоративен. Това е механизмът, чрез който контекстуалната двусмислица се разрешава, преди преводът да бъде финализиран.
Но въпросът остава: три верни отговора, три различни нюанса на значението. Инструментите за оценка на превода не са създадени за подобна нюансираност.
Това, което все още не знам
искам да бъда честен относно ограниченията на това, което този тест показва.
Един идиом, една езикова двойка, един ден вътрешно тестване. Това не е проучване. Това е наблюдение. Не знам дали този модел (по-малките модели по подразбиране са буквални, по-големите модели постигат идиоматичност) се задържа последователно в:
- Други испански идиоми
- Други езикови двойки с богати идиоматични традиции (араби, японски, руски всички идват на ум)
- Неидиоматично съдържание, където разликата не се прилага
- Крайни случаи, при които по-малък модел разбира идиома правилно, а по-голям го пропуска
Също така не знам дали това е стабилно свойство на тези модели или нещо, което се променя с актуализации и фина настройка. Доставчиците на модели не публикуват регистри за промени, специфични за превода. Версия на модел, която днес обработва llevarse el gato al agua правилно , може да бъде актуализирана следващия месец и ние няма да имаме начин да разберем.
Това, което знам: този тест даде резултат, достатъчно интересен , че искам да проведа още такива, по-систематично, в повече езикови двойки и типове съдържание. Когато имам повече да споделя, ще го направя.
Два изследователски въпроса, върху които си струва да се замислим
Ще завърша с двата въпроса, които този тест ми остави. Няма да им отговоря, все още нямам данните за това. Но мисля, че това са правилните въпроси, които трябва да се зададат.
Първо: при какъв праг на параметри идиоматичната компетентност става надеждна?
Преходът от GPT-4o-MINI и GPT-4.1-NANO (и двете буквални) към GPT-4.1-MINI (идиоматичен) предполага, че съществува праг някъде в диапазона на параметрите между тези размери на моделите, където разпознаването на идиоми се включва. Съвместимо ли е? Прилага ли се за идиоми във всички езици, или зависи от това колко добре е представен даден език в данните за обучение? Не знам. Но знанието би било полезно за всеки, който изгражда работни процеси за превод.
Второ: каква е цената на непрозрачността на версиите на модела за потребителите в голям мащаб?
Ако потребител препраща 1000 документа на месец през инструмент, който не разкрива коя версия на модела се използва (а някои от тези документи съдържат идиоматично съдържание), колко често буквалният провал се случва невидимо? Как биха могли да знаят? Каква е цената, в реални измерения, никога да не разберем?
Мисля, че това е по-важен въпрос от повечето от сравненията кой ИИ е най-добър за превод, които в момента циркулират. Отговорът не е „използвайте най-големия модел“ . Отговорът може да бъде: знайте какво използвате, направете свои собствени тестове върху собственото си съдържание и не предполагайте, че името на един доставчик е гаранция за последователно поведение в целия му модел обхват.
Това, поне, е това, което аз извличам от този тест.
Изследователски въпроси
1. Дали размерът на модела надеждно предсказва качеството на идиоматичния превод?
Въз основа на този единствен тест: по-малки, оптимизирани за ефективност модели от същото AI семейство по подразбиране превеждаха буквално утвърден испански идиом, докато по-големи/по-нови версии на същия модел произведоха правилни идиоматични преводи. Дали това важи за категориите идиоми и езиковите двойки е следващият въпрос. Ще направя още тестове.
2. Защо три „правилни“ идиоматични превода доведоха до три смислено различни резултата?
GPT-4.1-MINI, GPT-5.4-MINI и GPT-5.4 преведоха llevarse el gato al agua идиоматично — но в различни английски изрази с фино различни конотации. Това предполага , че качеството на идиоматичния превод има поне две измерения: дали моделът разпознава идиома изобщо и кой еквивалентен израз избира от наличните опции на целевия език. Стандартните показатели за качество на превода не разграничават ясно тези две измерения. Мисля, че трябва.
Тази публикация се основава на вътрешно тестване на платформата за разработка на MachineTranslation.com. Мултимоделното тестване на версии, показано тук, все още не е публично достъпно. Споделям откритието, защото смятам, че наблюдението е полезно, независимо къде извършвате преводите си.