May 15, 2026
Claude vs. Qwen per a la traducció: On condueix realment cada model
El juliol de 2025, Alibaba va llançar Qwen3-MT — un model de traducció automàtica creat específicament per a la traducció, no un LLM de propòsit general adaptat per a això. Entrenat amb bilions de tokens multilingües i de traducció mitjançant aprenentatge per reforç, admet 92 llengües i aconsegueix puntuacions BLEU competitives en comparació amb GPT-4.1 i Gemini 2.5 Pro en el banc de proves multilingüe WMT24, alhora que supera GPT-4.1-mini i Gemini 2.5 Flash en els conjunts de proves de xinès-anglès i anglès-alemany. Font: Alibaba Qwen, qwenlm.github.io, juliol de 2025.
Claude, desenvolupat per Anthropic, no té cap variant específica de traducció. És un gran model de llenguatge de propòsit general que gestiona la traducció juntament amb el raonament, la programació, l'anàlisi i l'escriptura. La seva qualitat de traducció és sòlida (demostrada en parells de llengües europees en una avaluació independent), però no va ser creat des de zero per a la traducció com ho va ser Qwen3-MT.
Aquesta asimetria defineix la comparació el 2026. Qwen aporta dos actius diferents: el LLM general de Qwen amb un entrenament profund d'origen xinès, i un model de traducció dissenyat específicament. Claude aporta una excel·lència documentada en la qualitat de les llengües europees i la precisió tonal. Entendre cap a on porta cadascun significa comprendre les famílies lingüístiques i els tipus de contingut on es mostren els seus avantatges estructurals.
Què és Qwen i què ha canviat des del 2025?
Qwen és la família de grans models de llenguatge d'Alibaba Cloud, amb una fortalesa específica en el processament del xinès i de les llengües asiàtiques que reflecteix el seu origen d'entrenament i el seu context de desplegament comercial.
La família Qwen s'ha expandit significativament des que es va publicar la versió original d'aquest article. A data de maig de 2026:
Qwen 3.5 (març de 2026) — l'actual LLM Qwen de propòsit general, que abasta mides de paràmetres des de 0,5B fins a més de 397B. Entrenat amb més de 20 bilions de tokens amb un vocabulari xinès i una profunditat semàntica excepcionals, lidera els benchmarks en xinès, japonès i coreà i està desplegat en més de 90.000 empreses. L'anàlisi del desenvolupador confirma: Cap model de codi obert iguala Qwen per al processament de text en xinès, japonès i coreà. Font: AI Magicx, març de 2026.
Qwen3-MT (juliol de 2025) — el model específic de traducció d'Alibaba, construït sobre l'arquitectura Qwen3 amb una xarxa troncal lleugera de mescla d'experts. Entrenat específicament per a la traducció en 92 idiomes amb aprenentatge per reforç, aconsegueix un rendiment competitiu en comparació amb GPT-4.1 i Gemini 2.5 Pro en els benchmarks multilingües de WMT24 — amb un cost computacional significativament menor. Això converteix Qwen en un dels pocs proveïdors d'IA amb un model creat exclusivament per a la traducció. Font: Marktechpost, juliol de 2025.
El Qwen utilitzat al sistema SMART de MachineTranslation.com és el Qwen LLM general, específicament les variants Qwen 2.5 72B Instruct Turbo i QwQ 32B segons la documentació del sistema de 2025 d'Intento.
Claude es troba actualment a Sonnet 4.6 i Opus 4.6 (febrer de 2026). Claude no té cap variant específica de traducció; tota la capacitat de traducció prové del seu entrenament de propòsit general. Claude 4 continua la trajectòria establerta per Claude 3.5 i 3.7 — fort en parells de llengües europees, precisió tonal i comprensió contextual per a contingut professional.
On té Qwen un avantatge estructural per a la traducció?
L'avantatge de Qwen és estructural i està profundament arrelat en el seu origen d'entrenament: El contingut en xinès, japonès i coreà és on la profunditat de Qwen es mostra més clarament.
Processament de la llengua xinesa. Qwen va ser entrenat des de zero per Alibaba, amb el xinès com a llengua principal en lloc de secundària. La majoria dels LLM d'origen occidental (incloent-hi Claude) estan entrenats amb dades predominantment en anglès, amb altres llengües afegides. El corpus d'entrenament de Qwen reflecteix tota la profunditat de la llengua escrita xinesa a través de registres, àmbits i períodes històrics. Per a la traducció de negocis al xinès, la traducció del xinès a l'anglès i el contingut en llengua xinesa amb expressions arrelades culturalment, la profunditat d'entrenament de Qwen produeix un resultat més natural i amb menys aparença de traducció.
L'avaluació de 2025 d'Intento va revelar que el xinès simplificat va assolir un rendiment excepcional, sense que es detectés cap error greu o crític en les solucions avaluades, en part perquè els models amb millor rendiment per al xinès inclouen sistemes amb un entrenament profund en xinès. Qwen3-MT aconsegueix específicament puntuacions BLEU líders en els conjunts de proves de xinès-anglès, superant GPT-4.1-mini i Gemini 2.5 Flash per a aquest parell. Font: Blog oficial de Qwen, juliol de 2025.
japonès i coreà. El grup CJK (xinès, japonès, coreà) més ampli presenta reptes de traducció estructuralment diferents dels de les llengües europees — diferents sistemes d'escriptura, un ordre de paraules diferent, diferents sistemes d'honorífics i de registre. L'entrenament de Qwen inclou una cobertura profunda del japonès i el coreà juntament amb el xinès. Per als equips de desenvolupadors que creen productes multilingües orientats als mercats asiàtics, el rendiment de Qwen en CJK significa menys postedició en les parelles estructuralment més complexes.
Accessibilitat de codi obert i cost. Els models de pesos oberts de Qwen es poden desplegar localment o en una infraestructura personalitzada. Això dona a les organitzacions sensibles a les dades (aquelles que tradueixen documents confidencials, historials mèdics o contingut empresarial propietari) l'opció d'executar Qwen completament dins del seu propi entorn sense que les dades surtin de la seva infraestructura. Claude és un model de codi tancat exclusiu d'API; no hi ha cap opció d'autoallotjament.
Entrenament específic per a traducció amb Qwen3-MT. L'existència d'un model de traducció dissenyat específicament dona a Qwen una opció que Claude no ofereix: un model en què cada decisió d'entrenament es va prendre específicament per a la qualitat de la traducció en lloc de per a una capacitat de propòsit general. Per als equips que creen fluxos de treball on la traducció és prioritària, l'enfocament d'aprenentatge per reforç de Qwen3-MT (optimitzant directament la fidelitat de la traducció en lloc de la qualitat lingüística general) pot produir resultats més consistents en contingut professional estàndard.
On té Claude un avantatge estructural per a la traducció?
L'avantatge de Claude es troba en la qualitat de les llengües europees, la precisió del to i del registre, i el rendiment documentat en contingut professional i literari.
Parells de llengües europees. Claude (Opus 4 i Sonnet 3.7) apareix a la categoria millor per a l'anglès a l'alemany, l'anglès a l'italià, l'anglès al neerlandès, l'anglès al francès i l'anglès a l'àrab en l'avaluació humana LQA del 2025 d'Intento. Aquestes són avaluacions independents, puntuades per humans —no pas punts de referència autoinformats. Qwen no està en el grup de primer nivell per a parells de llengües europees en la mateixa avaluació. Per al contingut professional europeu, la trajectòria de Claude és més sòlida en les avaluacions independents.
Precisió tonal i registre. L'entrenament de Claude posa un fort èmfasi en l'equivalència del llenguatge natural i la fidelitat tonal. La prova independent de 200 frases duta a terme per AI Tool Clash (febrer de 2026) va concloure que Claude va obtenir una puntuació global de 8,3/10 enfront del 7,9 de ChatGPT, amb significativament menys errors literals en expressions idiomàtiques (8% enfront del 34%) i una millor preservació del to i el registre literaris. Tot i que aquesta comparació és Claude vs. ChatGPT en lloc de Claude vs. Qwen directament, reflecteix l'avantatge documentat de comprensió contextual de Claude per al contingut on el to no és secundari.
Contingut professional i formal en contextos occidentals. Per a continguts en què el registre empresarial occidental, la formalitat legal o el context cultural europeu són importants (contractes en alemany, contingut de màrqueting per al públic francès, comunicacions corporatives en italià), l'entrenament d'origen occidental de Claude li proporciona una profunditat de context cultural que Qwen no prioritza.
Coherència en documents llargs sobre el contingut tonal. La finestra de context de 200K tokens de Claude Sonnet 4.6 i la finestra beta d'1M de tokens de Claude Opus 4.6 permeten el processament de documents complets sense fragmentació. Per a contingut narratiu, campanyes de màrqueting o informes llargs on s'ha de mantenir una veu coherent a tot el document, la gestió del context de Claude manté el registre i la coherència tonal a un nivell adequat per a una revisió professional.
Com es comparen per a tipus de contingut específics?
| Tipus de contingut | Opció més sòlida | Motiu |
|---|---|---|
| Xinès-anglès / anglès-xinès | Qwen | Profunditat d'entrenament nativa; model específic de traducció Qwen3-MT; constatació d'excel·lència en xinès d'Intento |
| Contingut en japonès i coreà | Qwen | Profunditat d'entrenament en CJK; cap LLM d'origen occidental s'iguala a Qwen per al processament de CJK |
| Llengües europees (alemany, italià, neerlandès, francès) | Claude | Nivell superior d'Intento 2025 per a l'alemany, l'italià i el neerlandès; posició d'avaluació independent |
| Traducció literària i sensible al to | Claude | AI Tool Clash 8,3/10 global; 9,2/10 en passatge literari; forta preservació del registre |
| Text d'origen ambigu | Claude | Mostra ambdues interpretacions en lloc de comprometre's amb una de sola |
| Fluxos de treball confidencials / autoallotjats | Qwen | Desplegament de pes obert; sense dependència de l'API; les dades romanen a les instal·lacions |
| Fluxos de treball d'API orientats a la traducció | Qwen3-MT | Model de traducció dissenyat específicament; optimitzat per RL per a la fidelitat; 92 idiomes |
| Contingut professional europeu general | Qualsevol dels dos | Ambdós cobreixen parells europeus de recursos alts a nivells de qualitat comparables |
El patró entre els tipus de contingut reflecteix la diferència d'entrenament estructural: Qwen per a llengües asiàtiques i desplegament específic per a traducció, Claude per a la qualitat de les llengües europees i contingut dependent de la precisió tonal. Per al contingut que no es troba en cap dels dos extrems (comunicació professional general en llengües amb molts recursos), la diferència entre tots dos té menys rellevància que la diferència entre qualsevol dels dos models i un resultat de consens verificat.
Què cal fer servir quan tots dos formen part del mateix sistema
Tant Qwen com Claude es troben entre els 22 models del sistema SMART de MachineTranslation.com. SMART executa els 22 simultàniament (incloent-hi tant Qwen (Qwen 2.5 72B Instruct Turbo, QwQ 32B) com Claude (nivell equivalent a Sonnet 4.6)) i retorna el resultat en què la majoria està d'acord, juntament amb una Puntuació de Qualitat de la Traducció.
Específicament per al contingut de xinès a anglès o d'anglès a xinès, el sistema SMART combina la profunditat CJK de Qwen amb la comprensió tonal de Claude, l'ampli corpus de xinès de Google i 19 models més. Quan la sortida de Qwen entrenada en xinès coincideix amb la interpretació contextual de Claude del mateix passatge, aquesta coincidència és un fort senyal de qualitat. Quan divergeixen (cosa que és més probable en passatges ambigus o contingut culturalment arrelat que en un text estàndard clar), MachineTranslation.com mostra aquesta incertesa en lloc de proporcionar una resposta errònia amb seguretat.
En els benchmarks interns de MachineTranslation.com, els models individuals de primer nivell, inclosos Claude i Qwen, arriben a 93–94 sobre 100 en qualitat de traducció. El consens de 22 models arriba a 98,5/100.
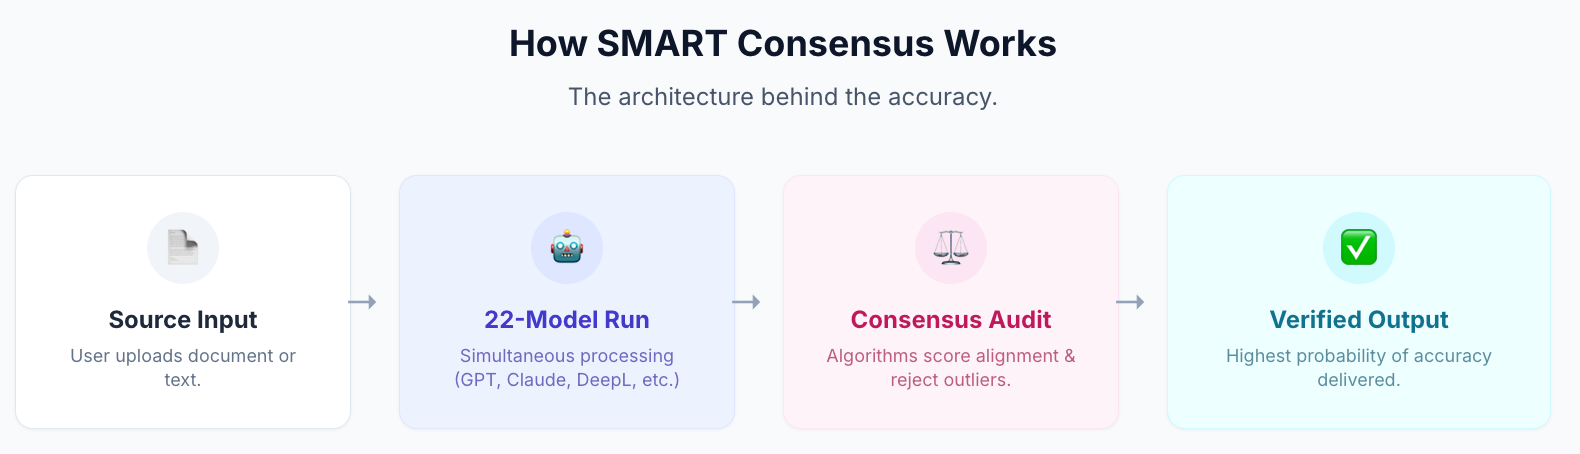
Per a continguts d'alt risc (presentacions legals, documentació clínica, materials regulats), la Verificació Humana escala el consens a un revisor professional certificat dins de la mateixa plataforma. 100% de precisió garantida.
Tradueix amb Qwen, Claude i 20 models més a MachineTranslation.com — gratuït, sense necessitat de registrar-se.
Preguntes freqüents
1. És Qwen millor que Claude per a la traducció de xinès?
Per a la traducció de xinès a anglès i d'anglès a xinès, Qwen té un avantatge estructural: va ser entrenat des de zero amb dades en llengua xinesa per Alibaba, amb el xinès com a llengua d'entrenament principal en lloc de secundària. Alibaba també va llançar Qwen3-MT el juliol de 2025 — un model específic de traducció que assoleix puntuacions BLEU capdavanteres en conjunts de proves de xinès-anglès, superant GPT-4.1-mini i Gemini 2.5 Flash. Específicament per a la traducció al xinès, Qwen és l'opció documentada més sòlida.
2. És Claude millor que Qwen per a les llengües europees?
Sí, segons una avaluació independent. Claude Opus 4 i Sonnet 3.7 apareixen a la categoria superior de 2025 d'Intento per a l'anglès a l'alemany, l'italià, el neerlandès i el francès en l'avaluació LQA humana. Qwen no apareix en el grup capdavanter per a parells de llengües europees en la mateixa avaluació. Per al contingut professional europeu on el registre i el to importen, la posició de Claude en les avaluacions independents és més forta.
3. Què és Qwen3-MT?
Qwen3-MT (qwen-mt-turbo) és un model de traducció automàtica llançat per Alibaba el juliol de 2025, basat en l'arquitectura Qwen3. A diferència dels LLM de propòsit general, es va dissenyar i entrenar específicament per a la traducció — utilitzant una arquitectura base lleugera de barreja d'experts i aprenentatge per reforç optimitzat per a la fidelitat de la traducció. Admet 92 idiomes, assoleix un rendiment competitiu respecte a GPT-4.1 i Gemini 2.5 Pro en els benchmarks de WMT24, i inclou opcions de personalització avançades, com ara la intervenció terminològica i els prompts de domini.
4. Es pot executar Qwen localment per a traduccions confidencials?
Sí. Els models de pesos oberts de Qwen es poden desplegar en la infraestructura local sense enviar dades a API externes. Això fa de Qwen una opció per a organitzacions amb requisits estrictes de sobirania de dades — proveïdors d'atenció sanitària, equips jurídics i institucions financeres que tradueixen documents confidencials. Claude és un model de codi tancat exclusiu d'API sense opció d'autoallotjament.
5. Quin és millor per a la traducció de japonès i coreà?
Qwen. L'anàlisi dels desenvolupadors identifica de manera consistent Qwen com el model obert més potent per al processament de CJK (xinès, japonès, coreà). La seva profunditat d'entrenament en llengües asiàtiques reflecteix el context de desplegament comercial d'Alibaba a més de 90.000 empreses dels mercats asiàtics. Cap model de codi obert d'origen occidental iguala Qwen en el processament de text CJK en els bancs de proves actuals.
6. Estan disponibles tant Qwen com Claude a MachineTranslation.com?
Sí. Tots dos es troben entre els 22 models del sistema SMART de MachineTranslation.com. Cada traducció SMART executa Qwen, Claude i 20 models més simultàniament, retornant el resultat en què coincideix la majoria. Específicament per al contingut en llengua xinesa, tenir tant la profunditat CJK de Qwen com la comprensió contextual de Claude en el mateix consens és especialment valuós.
7. Com han canviat els dos models des de la comparació original (Claude 3.7 vs. Qwen 2.5)?
Claude ha avançat a Sonnet 4.6 i Opus 4.6 (febrer de 2026), amb millores en el seguiment d'instruccions, el raonament i la capacitat multilingüe. Qwen ha avançat fins a Qwen 3.5 (març de 2026) per al model general, i també ha llançat Qwen3-MT (juliol de 2025) — un model específic de traducció que no existia en el moment de la comparació original. L'avantatge estructural que té cada model (Qwen per a CJK, Claude per a l'europeu) s'ha mantingut constant al llarg de les generacions.