May 8, 2026
Grok vs. Claude per a la traducció: què mostren els benchmarks (2026)
Grok (xAI) i Claude (Anthropic) són ambdues eines de traducció d'IA competents, però tenen punts forts estructuralment diferents. Per a la majoria de tasques de traducció general, no notareu cap diferència significativa entre ells. Per a dos escenaris específics (traduir contingut sobre esdeveniments recents i traduir documents formals que requereixen precisió), la diferència és real i es basa en com es va construir cada model.
Aquest article tracta sobre el que ofereix realment cada model per a la traducció, on els situen els benchmarks independents i què cal fer servir quan el resultat de qualsevol dels dos models per si sol no és suficient.
Com es comparen Grok i Claude pel que fa a la qualitat de la traducció?
La resposta curta: Claude lidera els benchmarks de traducció professional independents. L'avantatge específic de Grok és l'accés al coneixement en temps real, no la qualitat global de la traducció.
En els benchmarks interns de MachineTranslation.com, Claude (nivell 3.5 Sonnet) obté una puntuació de 93.8 sobre 100 en qualitat de traducció — precisió, terminologia i estil combinats. Grok no apareix entre les 14 millors solucions del State of Translation Automation 2025 d'Intento, que va avaluar 46 motors de traducció automàtica i LLMs en 11 parells d'idiomes. Claude Opus 4 i Claude Sonnet 3.7 apareixen tots dos al top 14. Font: Benchmarks interns de MachineTranslation.com; Intento State of Translation Automation 2025.
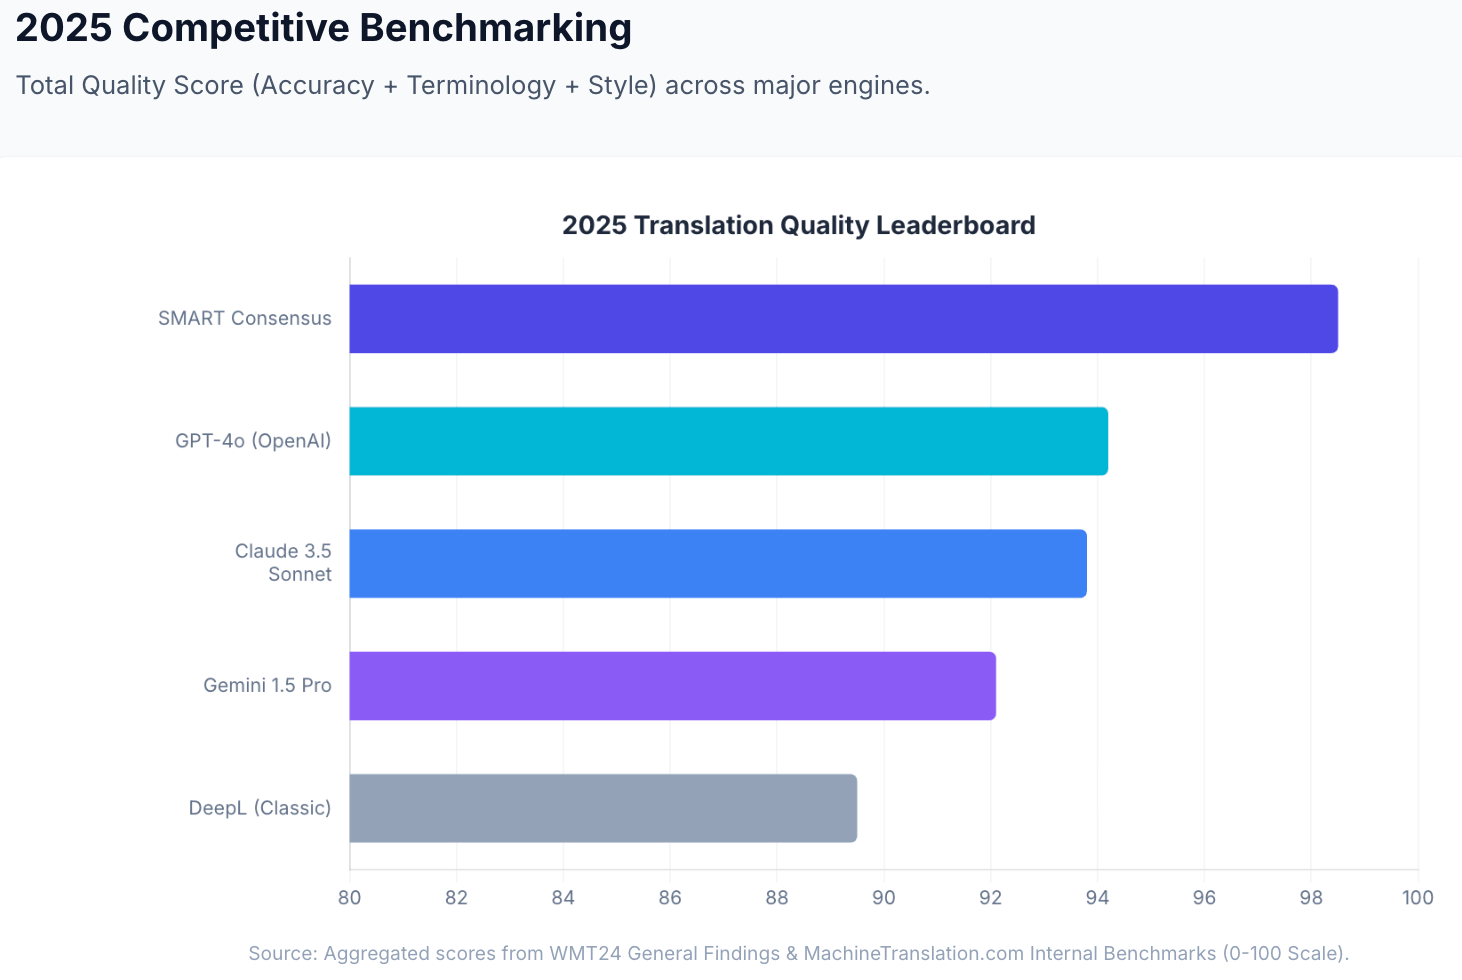
A WMT24 (la principal competició independent de benchmarks del sector de la traducció), Claude 3.5 va ocupar el primer lloc en 9 d'11 parells de llengües, per davant de GPT-4 i de motors de MT neuronal dedicats. En l'estudi a cegues de 2025 de Lokalise realitzat per traductors professionals, el 78% de les traduccions de Claude 3.5 van ser qualificades de bones —el percentatge més alt de qualsevol LLM provat.
Grok no ha estat avaluat a WMT24 ni en l'avaluació LQA independent d'Intento a un nivell comparable. La Slator Pro Guide (2025) inclou Grok com un dels LLMs de propòsit general utilitzats per a la traducció en entorns professionals, juntament amb GPT i Claude, però no el situa per sobre de cap dels dos.
| Benchmark | Grok | Claude |
|---|---|---|
| puntuació de qualitat interna de MachineTranslation.com | No mesurat a nivell de benchmark | 93.8/100 (nivell 3.5 Sonnet) |
| les 14 millors solucions d'Intento 2025 | No inclòs | Claude Opus 4 i Sonnet 3.7, tots dos inclosos |
| parells lingüístics de WMT24 | No avaluat | 1r en 9/11 parells lingüístics |
| estudi a cegues de Lokalise 2025 | No avaluat | 78% bo (el més alt de qualsevol LLM) |
Font: benchmarks interns de MachineTranslation.com; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
On té Grok un autèntic avantatge?
Traducció en temps real i de temes d'actualitat. La característica arquitectònica definidora de Grok és la seva integració amb les dades de la plataforma X (anteriorment Twitter) i la cerca a internet en temps real. A diferència de Claude i de la majoria dels altres LLMs, que estan entrenats amb conjunts de dades estàtics amb dates de tall de coneixement fixes, Grok incorpora informació en temps real als seus resultats. Per a tasques de traducció relacionades amb esdeveniments recents, productes llançats recentment, terminologia política emergent, notícies d'actualitat o contingut que fa referència a fets que han passat durant les últimes setmanes, Grok té accés a un context que Claude no té.
Això és especialment important per a: traduir articles de notícies sobre esdeveniments recents, localitzar anuncis de productes per a mercats que evolucionen ràpidament, gestionar terminologia de nova creació o argot posterior a les dades d'entrenament d'altres models, i qualsevol contingut on el significat depengui de saber què ha passat recentment.
Terminologia emergent i en evolució. Els camps tècnics, les indústries i els contextos culturals produeixen contínuament nova terminologia. Per a tasques de traducció que impliquin termes de creació recent, nou llenguatge regulador o nova nomenclatura de productes, l'entrenament actualitzat i la cerca en temps real de Grok li donen accés a patrons d'ús que les instantànies de dades d'entrenament més antigues no capten.
Finestra de context i raonament de Grok 4.1. Grok 4.1 (a finals de 2025) compta amb una finestra de context de 131K tokens i capacitats de raonament millorades, fet que el fa capaç de treballar amb documents complexos i de múltiples capes on les relacions entre clàusules i la coherència lògica importen.
On té Claude un autèntic avantatge?
Qualitat de traducció en benchmarks independents. L'avantatge de Claude està documentat per una avaluació professional independent, més que no pas per afirmacions autodeclarades. WMT24 va classificar Claude 3.5 en primer lloc en 9 d'11 parells de llengües davant de tot el conjunt de competidors. L'estudi a cegues de Lokalise del 2025 va revelar que els traductors professionals preferien els resultats de Claude 3.5 amb un percentatge de bo del 78% — superior al de GPT-4, DeepL i Google Translate en la mateixa avaluació. Aquestes són avaluacions cegues: traductors professionals van avaluar el resultat sense saber quin model l'havia produït.
Parells de llengües específics segons Intento 2025. Claude Opus 4 i Sonnet 3.7 apareixen a la categoria best per a l'anglès a l'alemany, l'anglès al japonès, l'anglès a l'italià, l'anglès al coreà, l'anglès al neerlandès, l'anglès a l'àrab i l'anglès al francès a l'avaluació LQA humana d'Intento. Per a aquests parells, Claude és l'opció documentada més sòlida d'entre les dues.
Precisió del to i contingut matisat. Els traductors professionals de l'estudi de Lokalise van preferir els resultats de Claude amb la taxa més alta de qualsevol LLM —cosa que reflecteix la fortalesa documentada de Claude a l'hora de preservar el registre, la veu de l'autor i el significat contextual. Per a la traducció literària, els documents jurídics, les comunicacions formals i els textos de màrqueting on la manera com es diu una cosa importa tant com el que es diu, Claude ofereix de manera consistent un bon rendiment en avaluacions independents.
Coherència en documents llargs. Claude 4.6 Sonnet admet una finestra de context de 200K tokens, mentre que Claude Opus 4.6 n'admet 1M en beta. Per a documents formals llargs (contractes, manuals tècnics, informes d'assajos clínics), Claude pot processar el document sencer en una sola passada, mantenint la coherència terminològica al llarg de tot el document. Els documents processats per fragments mostren una taxa d'inconsistència terminològica un 28% més alta en comparació amb el processament de documents complets. Font: Dades internes de MachineTranslation.com.
Com es comparen en suport lingüístic i preus?
Suport lingüístic: Tant Grok 4.1 com Claude 4.6 admeten la traducció en la majoria de les principals llengües del món. Claude ha estat avaluat de manera independent en parells de llengües europees i de l'Àsia oriental amb resultats excel·lents. El suport multilingüe de Grok ha millorat al llarg de les versions successives. Per a llengües de pocs recursos, ambdós models perden qualitat — la revisió humana és adequada per al contingut en parells de llengües de pocs recursos, independentment de quin model s'utilitzi.
Preus:
| Pla | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Consumidor (mensual) | SuperGrok: $30/mes | Claude Pro: $20/mes |
| Entrada de l'API (per M tokens) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| Sortida de l'API (per M tokens) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Nivell gratuït | Sí (amb límit de freqüència mitjançant X/Grok.com) | Sí (amb límit de freqüència mitjançant claude.ai) |
En el nivell de consumidor, Claude Pro ($20/month) is cheaper than SuperGrok ($30/mes). A nivell d'API, Grok 4.1 té un lleuger avantatge de cost respecte a Claude Sonnet 4.6 per a fluxos de treball de traducció amb un gran volum d'entrada.
Quin és millor per a tipus de contingut específics?
| Tipus de contingut | Model recomanat | Motiu | |||
|---|---|---|---|---|---|
| Notícies recents / actualitat | Grok | Accés a dades en temps real; els models entrenats de manera estàtica no tenen context actual | |||
| Terminologia emergent / llançaments de nous productes | Grok | La integració de cerca en viu capta els patrons d'ús recents | |||
| Documents jurídics formals | Claude | Avaluació independent de WMT24 i Lokalise 2025; precisió del to | Contingut mèdic / clínic | Claude | Posició en comparatives independents; preservació del registre |
| Textos de màrqueting / contingut creatiu | Claude | Preferència en l'estudi a cegues de Lokalise 2025; matís tonal | |||
| Documentació tècnica (llarga) | Claude | Finestra de context de 200K-1M; consistència terminològica al llarg del text | |||
| Xarxes socials / contingut conversacional | Qualsevol dels dos | Tots dos gestionen bé els parells conversacionals de recursos alts | |||
| Integració per a desenvolupadors / API | Qualsevol dels dos | Tots dos ofereixen accés a l'API; Grok és lleugerament més barat en tokens d'entrada |
Què utilitzar quan un model no és suficient
Tant Grok com Claude són eines de model únic. Cada model d'IA individual (independentment de com de capaç sigui) produeix errors que no pot detectar en el seu propi output. Una traducció fluida i segura de Grok o de Claude encara pot ser semànticament incorrecta, i sense una comprovació encreuada no hi ha manera de saber-ho.
Tant Grok com Claude es troben entre els 22 models del sistema SMART de MachineTranslation.com. SMART executa tots els 22 models simultàniament (incloent-hi Grok i Claude) i retorna la sortida en què coincideix la majoria.
El que això significa per a la qüestió Grok vs. Claude: La fortalesa en temps real de Grok i la profunditat contextual de Claude contribueixen totes dues al mateix consens. Quan coincideixen, aquesta coincidència és un senyal de qualitat fort.
En els benchmarks interns de MachineTranslation.com, els models individuals de primer nivell obtenen una puntuació de 93-94 sobre 100 en qualitat de traducció. La sortida de consens de SMART arriba a 98.5/100. Font: Benchmarks interns de MachineTranslation.com i conclusions de WMT24 General Machine Translation.
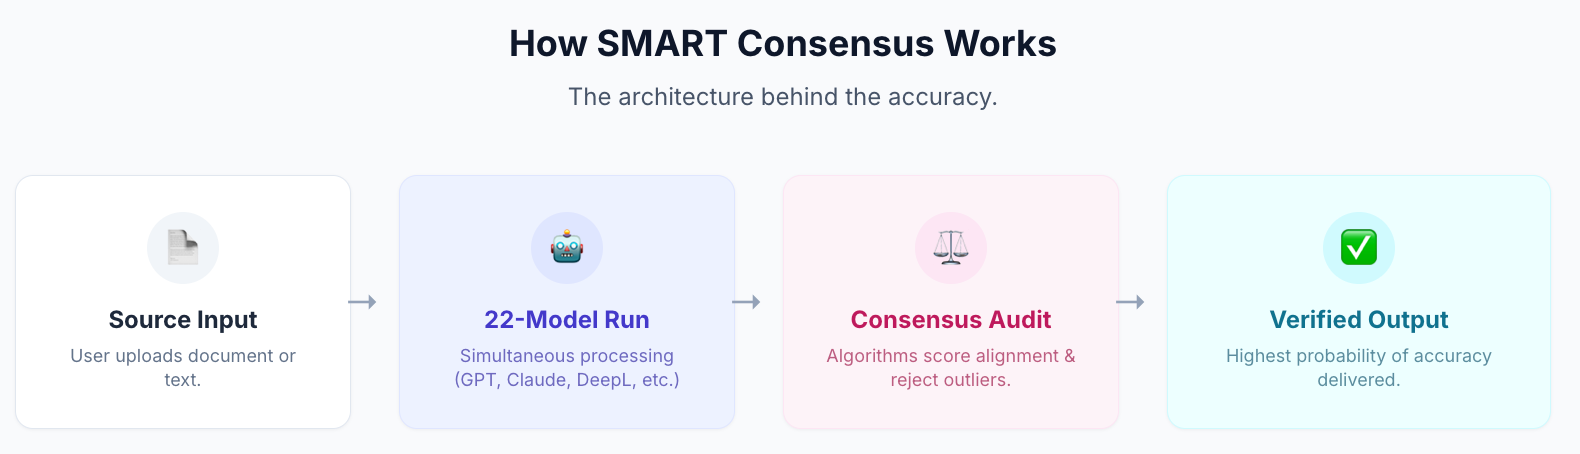
Els usuaris que van canviar de la traducció de motor únic a SMART van dedicar un 27% menys de temps a verificar i corregir els resultats. Font: Dades internes de MachineTranslation.com.
Per a contingut crític (documents legals, tràmits reguladors, instruccions mèdiques), Human Verification escala el SMART consensus a un revisor professional certificat dins de la mateixa plataforma. Cap agència externa. Precisió del 100% garantida.
Tradueix amb Grok, Claude i 20 models més a MachineTranslation.com — gratuït, sense registre.
Preguntes freqüents
1. És Grok millor que Claude per a la traducció?
Per a la majoria de tasques de traducció estàndard, Claude lidera els benchmarks independents: primer en 9 d'11 parelles de llengües a WMT24, una valoració de bo del 78% en l'estudi a cegues de 2025 de Lokalise i 93.8/100 en els benchmarks de qualitat interns de MachineTranslation.com. L'avantatge específic de Grok és per al contingut que requereix coneixements d'actualitat, el seu accés a dades en temps real li dona un context que els models entrenats de manera estàtica, incloent-hi Claude, no tenen. Per a notícies recents, terminologia emergent i contingut sensible al factor temps, Grok és l'opció més sòlida.
2. Quin és l'avantatge de Grok respecte a Claude per a la traducció?
Grok integra dades en temps real de X (anteriorment Twitter) i cerca a internet en directe. A diferència de Claude i de la majoria d'altres LLMs entrenats amb conjunts de dades estàtics, Grok pot accedir a informació sobre esdeveniments recents, terminologia de nova creació i el context actual quan genera traduccions. Això fa que sigui específicament més potent per traduir contingut de notícies, productes llançats recentment i qualsevol material on el significat depengui d'esdeveniments o patrons lingüístics de les darreres setmanes.
3. Quin és l'avantatge de Claude sobre Grok per a la traducció?
L'avantatge de Claude està documentat mitjançant una avaluació professional independent. Claude 3.5 va ocupar el primer lloc en 9 d'11 parells de llengües al WMT24, i els traductors professionals de l'estudi a cegues de 2025 de Lokalise van preferir els seus resultats amb una taxa de bo del 78% —la més alta de qualsevol LLM provat. Claude també apareix a les 14 millors solucions d'Intento en diversos parells d'idiomes en l'avaluació LQA humana, mentre que Grok no. Per a tasques de traducció formals, professionals i de gran transcendència, la posició de Claude en els benchmarks independents és el factor diferenciador documentat.
4. Quin és millor per a la traducció jurídica, Grok o Claude?
Claude és l'opció més sòlida per a la traducció jurídica segons una avaluació independent. Claude 3.5 va ocupar el primer lloc en la majoria de parells de llengües europees de recursos alts al WMT24 i va rebre les valoracions de preferència més altes en estudis a cegues per part de traductors professionals. Per a contingut legal que requereix una precisió certificada, cap dels dos models per si sol és suficient — la Verificació Humana de MachineTranslation.com proporciona una precisió del 100% per part d'un revisor professional certificat dins de la mateixa plataforma, sense necessitat de cap proveïdor extern.
5. Estan disponibles tant Grok com Claude a MachineTranslation.com?
Sí. Tots dos es troben entre els 22 models del sistema SMART de MachineTranslation.com. Cada traducció SMART executa Grok, Claude i uns altres 20 models simultàniament, retornant la sortida en què la majoria està d'acord. En lloc de triar entre ells, rebeu el consens de tots els models d'IA.
6. Com es comparen Grok i Claude pel que fa al preu?
En el nivell de consum, Claude Pro costa $20/month versus SuperGrok at $30/mes. A nivell d'API, Grok 4.1 és lleugerament més barat en tokens d'entrada ($2/M vs. $3/M per a Claude Sonnet 4.6) i de sortida ($10/M vs. $15/M). El pla gratuït de MachineTranslation.com inclou els dos models com a part del consens de 22 models de SMART, sense necessitat de registrar-se.
7. Quin model d'IA és el millor per traduir articles de notícies?
Per traduir articles de notícies, Grok té un avantatge estructural: la seva integració de dades en temps real significa que té context actual sobre els esdeveniments que es descriuen, cosa que els models entrenats de manera estàtica poden no tenir. Per a la traducció de notícies generals on la recència no és crítica, el rendiment de referència de Claude és superior. Per a la traducció de notícies de gran volum on tant l'actualitat com la precisió importen, SMART de MachineTranslation.com executa els dos models i en retorna el resultat de consens.