September 9, 2026
Qwen vs DeepSeek: Quin model d'IA tradueix millor?
En passar els mateixos 12,000 segments de traducció per Qwen i DeepSeek, DeepSeek guanya en la majoria de parells d'idiomes. Però aquesta no és tota la història. Si dividim els resultats per direcció, apareix un patró específic: Qwen redueix gairebé del tot la diferència i, a vegades, pren la davantera, especialment quan l'idioma de destinació és l'anglès. En traduir de l'anglès a qualsevol altre idioma, DeepSeek guanya gairebé sempre.
Aquesta divisió és més important que un únic guanyador global si tradueixes contingut en desenes d'idiomes en lloc d'un sol parell de llengües.
Què són Qwen i DeepSeek?
Qwen és la família de models de llenguatge grans d'Alibaba. La generació actual és Qwen3.8, llançada l'agost de 2026: Qwen3.8-Max és el model insígnia tancat, exclusiu per a API, amb 2.4 bilions de paràmetres, mentre que Qwen3.8-27B és un model de pesos oberts més petit, llançat sota Apache 2.0 uns dies després, adreçat a equips que volen autoallotjar-lo.
DeepSeek és un laboratori d'IA xinès conegut per models de mescla d'experts que igualen el rendiment capdavanter a una fracció del cost d'inferència. La seva generació actual, DeepSeek V4, es va llançar l'abril de 2026 en dues variants: V4 Pro (1.6 bilions de paràmetres totals, uns 49 mil milions d'actius per token) per a feines centrades en la qualitat, i V4 Flash (284 mil milions totals, uns 13 mil milions d'actius) per a càrregues de treball sensibles a la latència. Tots dos es distribueixen com a pesos oberts amb llicència MIT.
Com es comparen realment Qwen i DeepSeek en traducció, i no només en bancs de proves?
La majoria de comparacions entre Qwen i DeepSeek citen bancs de proves de propòsit general: programació, matemàtiques, raonament. Cap d'aquests no mesura directament la qualitat de la traducció, i executar cada model sobre textos d'origen diferents fa que sigui impossible aïllar qualsevol diferència de precisió del que exigia el text mateix.
El trànsit de traducció propi de MachineTranslation.com dels últims 28 dies dona una resposta més neta, perquè tots dos models van traduir el mateix text d'origen. En 98 parells de llengües i més de 12.000 segments emparellats, DeepSeek va obtenir una puntuació més alta en 83 parells; Qwen va obtenir una puntuació més alta en 15. Si ens limitem als 27 parells en què la llengua de destinació és l'anglès, la diferència es redueix dràsticament: DeepSeek guanya en el 63% d'aquests (17 de 27), Qwen guanya en el 37% (10 de 27). En els 71 parells restants, on l'anglès no és la llengua de destinació, DeepSeek guanya el 92% (66 de 71).
Taxa de victòries per direcció de traducció (98 parells de llengües, text idèntic)
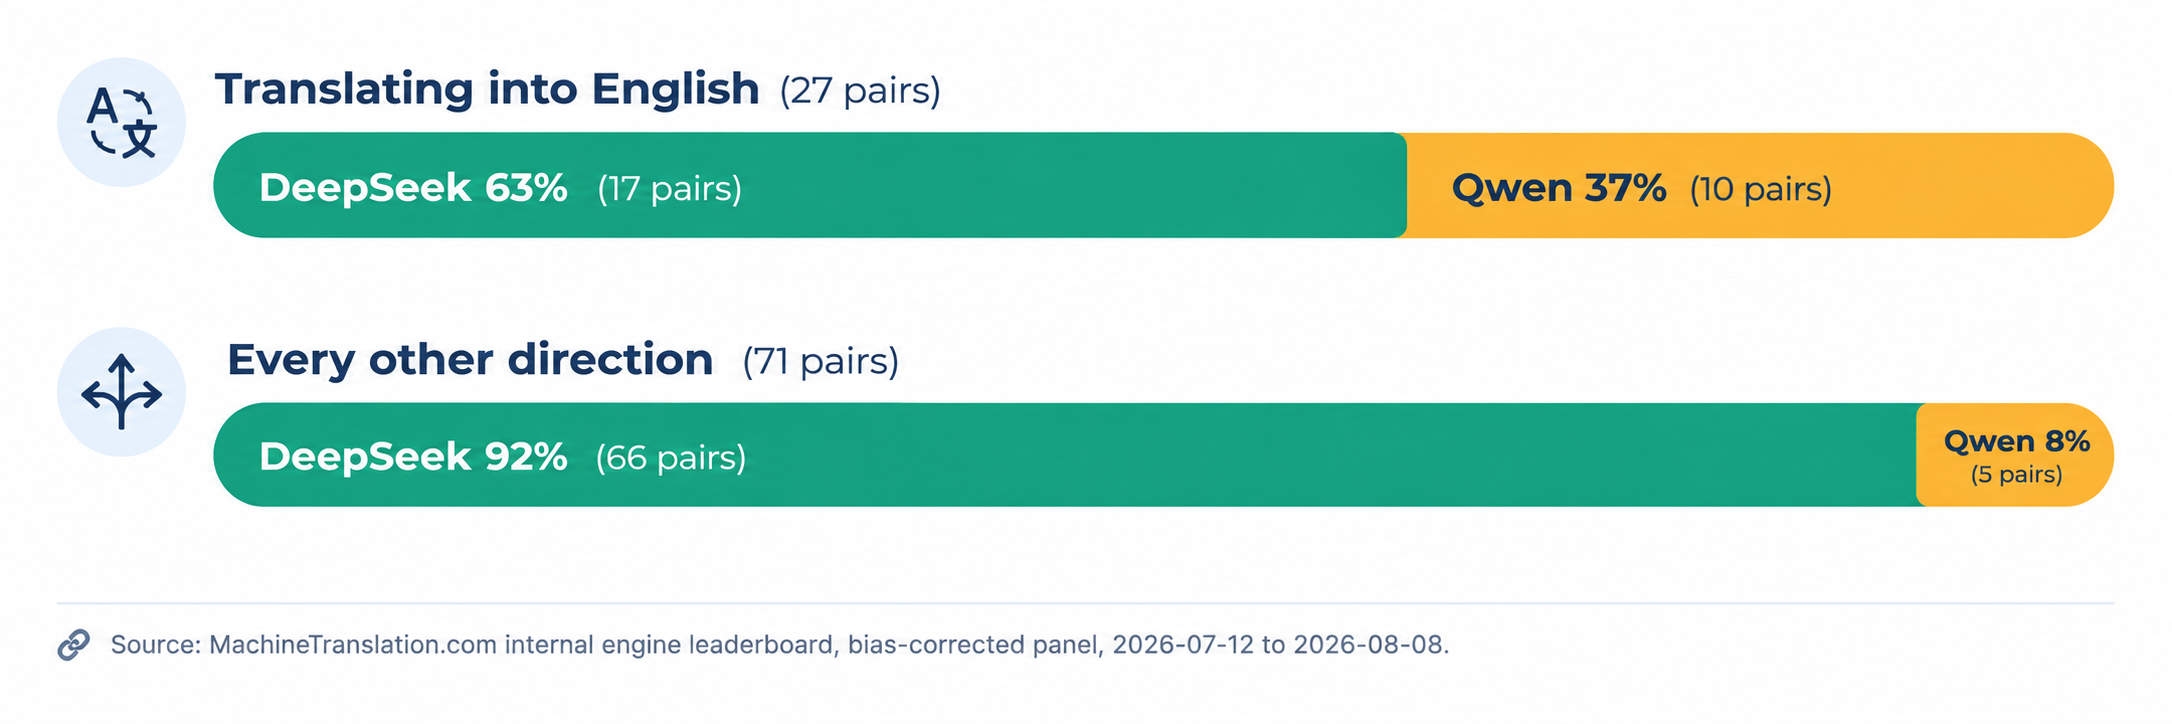
DeepSeek guanya la gran majoria dels parells de llengües en general. El marge de competitivitat de Qwen és estret però real: traduint a l'anglès, on s'emporta més d'un terç dels parells. Dades: Classificació interna de motors de MachineTranslation.com, panell corregit per biaix, del 12 de juliol al 8 d'agost de 2026.
La mitjana ponderada de tots els segments emparellats situa DeepSeek en 9.13 sobre 10 i Qwen en 8.98. Es tracta d'una diferència real, per bé que no està distribuïda de manera uniforme, la qual cosa és la dada més útil si el vostre contingut es mou en més d'una direcció. Aquest és el mateix enfocament de comparació directa que utilitza MachineTranslation.com en les seves proves de comparació completa de models, no només per a aquest parell.
Les xifres agregades també es mantenen en els casos de prova individuals. En provar la frase en francès "Elle est directrice adjointe du département commercial", DeepSeek i Qwen van coincidir en la mateixa traducció a l'anglès, "deputy director of commercial department". Podeu comprovar aquest resultat de la prova en viu directament. En provar "as soon as possible" traduït a l'espanyol, DeepSeek es va desmarcar del consens dels quatre models amb "esté hecho" en lloc de "se haga", la qual cosa és un cas de divergència real que reflecteix una distinció gramatical entre procés i resultat, no pas un error.
Per què Qwen ho fa millor traduint a l'anglès específicament?
Les dades no expliquen per què, només on. Alguns dels parells més forts de Qwen cap a l'anglès són el tàmil, el xinès, el polonès, l'italià i l'hebreu, que són llengües d'origen amb corpus d'entrenament en anglès grans i ben documentats que, en general, estan a disposició dels creadors de models. Outside d'aquesta única direcció, l'avantatge de DeepSeek es manté gairebé a tot arreu: des de l'anglès i també entre parells de llengües que no inclouen l'anglès.
El que això descarta és tractar qualsevol dels dos models com una opció predeterminada universal. Un equip que tradueixi llistats de productes de l'espanyol a sis idiomes i esperi la mateixa classificació de rendiment que va veure en traduir un tiquet de suport en xinès a l'anglès estaria aplicant la lliçó equivocada de la direcció equivocada, que és la mateixa asimetria que apareix al desglossament de models d'espanyol a anglès de MachineTranslation.com , on els models líders no són els mateixos que lideren en la direcció inversa.
Són Qwen i DeepSeek gratuïts i de codi obert?
La llicència es divideix de manera diferent per a cadascun. DeepSeek llicencia tant V4 Pro com V4 Flash sota MIT, un dels termes de codi obert més permissius disponibles, de manera que tots dos es poden autoallotjar de franc i sense restriccions. Qwen està dividit: Qwen3.8-27B es distribueix sota Apache 2.0 i es pot autoallotjar de franc, però el model insígnia Qwen3.8-Max continua sent tancat, només disponible per API i sota la llicència personalitzada d'Alibaba.
A la pràctica, això significa que existeix una opció amb pesos completament oberts i llicència MIT per part de DeepSeek en ambdós nivells de qualitat. Pel que fa a Qwen, optar pels pesos oberts significa renunciar al model insígnia.
Quin cost té fer funcionar Qwen i DeepSeek a gran escala?
Després de la reducció permanent de preus de DeepSeek al maig de 2026, les seves tarifes de l'API publicades actualment són de $0.435 per million input tokens (cache miss) and $0.87 per milió de tokens de sortida per a V4 Pro, amb un preu més baix per a V4 Flash en el seu nivell optimitzat per a la latència.
Per als equips que autoallotgen qualsevol dels dos models en lloc d'utilitzar una API allotjada, la comparació de costos es desplaça completament cap a la infraestructura de GPU i es converteix en una funció del recompte de paràmetres i de l'eficiència dels paràmetres actius, més que no pas en una tarifa per token.
És algun dels dos models prou segur per a continguts legals, mèdics o regulats?
Cap dels dos models publica certificacions de seguretat específiques per a traducció, i els bancs de proves de seguretat de propòsit general no avaluen els modes de fallada que importen en el contingut regulat: una dosi mal traduïda, una clàusula de responsabilitat alterada o un terme jurídic incoherent. Les proves pròpies de MachineTranslation.com han trobat exactament aquest tipus de divergència entre models en el llenguatge jurídic i mèdic, inclosos casos en què els models utilitzaven termes legals diferents amb abasts diferents malgrat que tots dos obtenien una bona puntuació en les mètriques de qualitat general.
Per a contractes, documents d'immigració o contingut clínic, aquest és el motiu per associar el resultat de qualsevol dels dos models amb un pas de verificació humana en lloc de confiar cegament en un sol resultat d'IA, independentment de quin model l'hagi produït.
Què significa això si esteu localitzant a molts idiomes alhora?
Una comparació basada en un sol parell de llengües no diu gairebé res sobre el parell número quaranta. La divisió cap a l'anglès/des de l'anglès documentada aquí es va mantenir en una mostra de 98 parells precisament perquè es va provar a aquesta escala: una única prova d'anglès a espanyol, que és el que fan la majoria de les comparacions entre Qwen i DeepSeek, hauria mostrat DeepSeek clarament per davant i no hauria dit res sobre què passa un cop entren en joc el tàmil, el polonès o l'hebreu.
Aquest és l'argument pràctic per no restringir per defecte un gran programa de localització als resultats d'un sol model. MachineTranslation.com executa tant Qwen com DeepSeek, juntament amb més de 20 models més, a cada traducció i mostra la versió en què aquests models coincideixen més, de manera que un desplegament en 68 idiomes no depèn de quin model hagi guanyat el primer parell que s'hagi provat. Podeu comprovar exactament quins models han coincidit o divergit en qualsevol traducció en el desglossament de models per traducció que mostra la plataforma per a cada resultat.
Cada traducció es verifica amb una gamma de models més àmplia de la que poden oferir Qwen o DeepSeek per si sols, la qual cosa és la resposta directa a què passa quan el vostre contingut deixa de moure's en una sola direcció.
Preguntes freqüents
1. És millor Qwen o DeepSeek per a la traducció?
En 98 parells de llengües provats amb un text d'origen idèntic, DeepSeek va obtenir una puntuació més alta en 83 d'ells. Les victories de Qwen es concentren en una direcció específica: la traducció cap a l'anglès, on guanya aproximadament un terç de les vegades. En qualsevol altra direcció, DeepSeek guanya més del 90% de les vegades.
2. És gratuït utilitzar Qwen?
Qwen3.8-27B és de pesos oberts sota Apache 2.0 i es pot autoallotjar de franc. El model insígnia Qwen3.8-Max és tancat i només està disponible a través de l'API de pagament d'Alibaba Cloud.
3. És gratuït utilitzar DeepSeek?
Sí. Tant DeepSeek V4 Pro com V4 Flash es distribueixen amb pesos oberts sota llicència MIT, de manera que podeu autoallotjar qualsevol dels dos sense cap cost de llicència. DeepSeek també ofereix una API de pagament per a equips que no volen gestionar la seva pròpia infraestructura.
4. Quin és més ràpid, Qwen o DeepSeek?
DeepSeek V4 Flash està dissenyat específicament per a una baixa latència, amb 13.000 milions de paràmetres actius per token enfront dels 49.000 milions del V4 Pro. L'opció equivalent més lleugera de Qwen, Qwen3.8-27B, és densa en lloc de mixture-of-experts, la qual cosa generalment la fa més lenta per token a una qualitat comparable.
5. Puc utilitzar Qwen i DeepSeek junts per a la traducció?
Sí. MachineTranslation.com executa tots dos models, a més de més de 20 altres, en cada traducció i mostra la versió en què coincideixen més, de manera que no us quedeu atrapats havent de triar un sol model amb l'esperança que sigui l'opció més sòlida per a aquell parell de llengües específic.
6. Quina és la diferència entre les llicències de Qwen i DeepSeek?
DeepSeek llicencia ambdues variants de V4 sota MIT, una de les llicències de codi obert més permissives disponibles. Qwen divideix la seva gamma: els models més petits com Qwen3.8-27B es distribueixen sota Apache 2.0, però el model insígnia Qwen3.8-Max es manté tancat sota una llicència personalitzada.