November 13, 2026
Qwen vs Gemini per a la traducció i per què la direcció és important
Teniu dos models i una llista de parells d'idiomes, i heu de decidir en quin model confiar per al projecte. La majoria de comparacions entre Qwen i Gemini responen amb una puntuació global única. Crec que una sola puntuació amaga allò que realment determina el resultat, que és la direcció de la traducció.
Treballo en la manera com avaluem els models que s'executen a MachineTranslation.com, així que puc comparar Qwen i Gemini en 98 parells d'idiomes puntuats sobre un text idèntic. Gemini ha obtingut una puntuació més alta en 68 d'aquests parells i Qwen en 29, i la diferència mitjana és de 0,08 punts sobre 10. Els totals per si sols no us diuen quin model triar per a la traducció d'urdú a anglès o d'anglès a crioll haitià.
Aquest article mostra on s'acosten tots dos models i on lidera cadascun d'ells. També explica allò que encara no us puc dir. Les meves dades acaben el 8 d'agost de 2026, abans que Google anunciés Gemini 4 a l'octubre, de manera que descriuen les versions anteriors de tots dos models.
Punts clau
- En 98 parells d'idiomes puntuats sobre un text idèntic (del 12 de juliol al 8 d'agost de 2026), Gemini ha obtingut una puntuació més alta en 68 parells, Qwen en 29, i un parell ha empatat.
- La diferència mitjana és petita, 9,06 per a Gemini davant de 8,98 per a Qwen, i 60 dels 98 parells se situen a menys de 0,1 punts.
- En traduir cap a l'anglès, Qwen lidera per més de 0,1 punts en 7 de 27 parells i Gemini en 3; els altres 17 es troben a menys de 0,1 punts.
- En traduir des de l'anglès, Gemini lidera per més de 0,1 punts en 13 de 29 parells i Qwen en cap.
- Les dades acaben abans que Google anunciés Gemini 4 a l'octubre de 2026, de manera que descriuen les versions anteriors de Gemini i requereixen una nova execució abans de considerar-les actuals.
És millor Qwen o Gemini per a la traducció?
Depèn de la direcció, perquè tots dos models estan molt igualats quan l'idioma de destinació és l'anglès i Gemini obté una puntuació més alta en la majoria dels altres parells. En el conjunt dels 98 parells, Gemini ha obtingut una puntuació més alta en 68. En les puntuacions de MachineTranslation.com del 12 de juliol al 8 d'agost de 2026, Gemini ha obtingut una mitjana de 9,06 sobre 10 i Qwen de 8,98, una diferència mitjana de 0,08 punts.
El panell només té en compte els segments on ChatGPT, Claude, DeepSeek, Gemini i Qwen han rebut una puntuació real, de manera que tots els models s'avaluen sobre un text d'origen idèntic. Cada parell d'idiomes té almenys 30 segments. Utilitzo aquest panell perquè elimina un error habitual, que és comparar models sobre textos diferents.
Pel que fa al recompte, Gemini va al capdavant en 68 parells (69%), Qwen en 29 (30%) i un parell està empatat. El recompte per si sol exagera la diferència, perquè 60 dels 98 parells es troben a menys de 0,1 punts. Les seccions següents desglossen els resultats per direcció i per marge.
Quines direccions de traducció afavoreixen cada model?
Gemini lidera quan l'anglès és l'idioma d'origen o quan cap dels dos idiomes és l'anglès, i Qwen està empatat amb ell o per davant quan l'anglès és la llengua de destinació. Des de l'anglès, Gemini lidera per més de 0,1 punts en 13 de 29 parells i Qwen en cap. Cap a l'anglès, Qwen lidera per aquest marge en 7 de 27 parells i Gemini en 3.
| Direcció | Parells | Gemini per davant per més de 0,1 | Dins de 0,1 punts | Qwen per davant per més de 0,1 | Diferència mitjana |
|---|---|---|---|---|---|
| Cap a l'anglès | 27 | 3 | 17 | 7 | Qwen +0,04 |
| Des de l'anglès | 29 | 13 | 16 | 0 | Gemini +0,16 |
| Cap de les dues en anglès | 42 | 14 | 27 | 1 | Gemini +0,13 |
Cap a l'anglès, 17 de 27 parells es troben a menys de 0,1 punts, Qwen lidera en 7 i Gemini lidera en 3. Des de l'anglès, 16 de 29 parells es troben a menys de 0,1 punts, Gemini lidera en 13 i Qwen no lidera en cap. Quan cap de les dues llengües és l'anglès, 27 de 42 es troben a menys de 0,1 punts, Gemini lidera en 14 i Qwen lidera en 1.
Qwen es troba a menys de 0,1 punts de Gemini o per davant en 24 dels 27 parells cap a l'anglès. Fent la mitjana per direcció, Qwen està al capdavant per uns 0,04 punts cap a l'anglès, mentre que Gemini està al capdavant per uns 0,16 punts des de l'anglès i 0,13 punts entre dues llengües que no són l'anglès.
No sé per què es produeix aquesta divisió, i aquestes dades no m'ho poden dir. Una explicació que provaria primer és la combinació de textos d'entrenament darrere de cada model, però no he dut a terme aquesta prova. Qwen mostra un patró similar enfront de ChatGPT. En el mateix panell, la nostra comparació de Qwen vs ChatGPT va determinar que tots dos estaven gairebé empatats cap a l'anglès, amb ChatGPT al capdavant en el 89% dels altres parells.
Quins parells de llengües mostren les diferències més grans?
Les diferències més grans afavoreixen Gemini. Lidera per entre 0,51 i 0,95 punts en rus a kazakh, anglès a crioll haitià, anglès a tagal, espanyol a grec i àrab a persa. Els avantatges més grans de Qwen són més reduïts, d'entre 0,15 i 0,26 punts, i quatre dels seus cinc primers són parells cap a l'anglès.
| Parell de llengües | Puntuació de Gemini | Puntuació de Qwen | Diferència |
|---|---|---|---|
| De rus a kazakh | 9,27 | 8,32 | Gemini +0,95 |
| D'anglès a crioll haitià | 9,19 | 8,27 | Gemini +0,92 |
| D'anglès a tagal | 9,14 | 8,43 | Gemini +0,70 |
| Espanyol a grec | 8,90 | 8,33 | Gemini +0,57 |
| Àrab a persa | 8,84 | 8,34 | Gemini +0,51 |
| Urdú a anglès | 8,56 | 8,81 | Qwen +0,26 |
| Xinès a anglès | 9,00 | 9,19 | Qwen +0,19 |
| Suec a anglès | 8,29 | 8,46 | Qwen +0,16 |
| Xinès a indonesi | 9,03 | 9,19 | Qwen +0,16 |
| Birmà a anglès | 8,94 | 9,09 | Qwen +0,15 |
No consideraria aquests resultats com a rànquings definitius. Les dues diferències més grans, de rus a kazakh i d'anglès a crioll haitià, es basen en mostres més petites que la parella mediana. D'anglès a tagàlog, d'espanyol a grec i d'àrab a persa es basen en mostres més grans, de manera que confiaria més en aquestes tres. Tornaria a avaluar les dues diferències de mostra reduïda abans de confiar-hi.
Què significa una diferència de 0,1 punts?
Al meu parer, una diferència inferior a 0,1 punts és massa petita per proclamar un guanyador. De les 98 parelles, 60 cauen dins d'aquest marge, i cada parella es puntua sobre un nombre limitat de segments. La línia del 0,1 és el meu propi llindar de treball, i no he fet cap prova de significació estadística sobre aquestes parelles.
Una puntuació també passa per alt algunes diferències. A les nostres proves de frases habituals, vam passar «sorry» en àrab per 22 models d'IA. Gemini i Qwen van triar tots dos la forma informal آسف. ChatGPT i el resultat combinat van triar la forma formal عذرًا. Tots els models van obtenir una puntuació de 9,5, de manera que les dues paraules difereixen en registre i la puntuació no va variar.
Per això llegeixo el marge i els exemples de registre conjuntament. Una diferència petita amb una diferència de registre visible requereix una decisió humana. Una diferència gran en una mostra reduïda requereix una nova prova.
Qwen i Gemini cometen tipus d'errors diferents?
Sí, perquè a la nostra prova de cites de la Copa del Món de 2026 tots dos models van prendre almenys una decisió que els altres models no van prendre, i les puntuacions gairebé no van variar. Gemini va traduir una frase de Mbappé com a «with each game» i va traduir paraula per paraula una cita de Wirtz, mentre que Qwen va oferir una interpretació diferent d'una cita de Scaloni. Les puntuacions d'aquests casos van anar de 9,2 a 9,5.
Els detalls provenen de la nostra prova de cites de la Copa del Món. En la cita de Mbappé sobre mirar endavant, els altres models van mantenir «match» mentre que Gemini va escriure «with each game», una petita relliscada de registre que va obtenir un 9,4. En una cita de Wirtz, Gemini va traduir una frase paraula per paraula i en va canviar el significat, també amb un 9,4. En la cita de Scaloni, la majoria dels models van convergir en una interpretació mentre que Qwen va escriure «that is what matters» i va obtenir un 9,4. En la cita tàctica de Mbappé, Claude i DeepSeek van triar anglès britànic futbolístic mentre que Gemini, Qwen i els altres van triar anglès americà, i Qwen va obtenir un 9,2, més baix que la resta.
Interpreto això com a petits hàbits. Els exemples de Gemini tenen a veure amb el registre i la formulació literal. Els de Qwen tenen a veure amb quina interpretació d'una frase triar. Quatre exemples són massa pocs per parlar d'un patró, però mostren la mena de diferència que una sola puntuació amaga.
Quin model de Qwen és el millor per a la traducció?
No ho puc determinar a partir de les nostres dades, perquè les puntuacions de MachineTranslation.com tracten Qwen com un sol model sense etiqueta de versió. D'Alibaba, la família Qwen3.8 va arribar a Hugging Face l'agost de 2026, de manera que ara n'existeixen diverses versions, i les puntuacions d'aquest article no les diferencien.
M'agradaria desglossar això per versió, i encara no puc fer-ho. La xifra a escala de plataforma pot fer la mitjana de més d'una versió de Qwen que s'hagi executat durant aquest període. Si heu de triar entre versions de Qwen per a un projecte, jo les compararia amb una mostra del vostre propi text.
Quines alternatives hi ha a Gemini per a la traducció?
ChatGPT, Claude, DeepSeek, Qwen, Grok i Mistral AI funcionen a MachineTranslation.com, i l'alternativa adequada depèn de la parella. A les nostres puntuacions del 12 de juliol al 8 d'agost de 2026, Qwen està a menys de 0,1 punts de Gemini o per davant en 24 de 27 parelles cap a l'anglès. Les nostres puntuacions de francès de Mistral AI mostren que la seva mitjana de francès a anglès se situa 0,40 punts per sobre de la de Gemini.
Si la vostra alternativa és ChatGPT, la resposta també varia segons la parella. En el nostre desglossament publicat d'espanyol a anglès, Gemini va guanyar en el 31% dels segments i ChatGPT en el 21%. En francès, cap dels dos models guanya en totes dues direccions. Com que l'elecció canvia segons la parella, MachineTranslation.com no tria una sola alternativa. Les executa juntes.
El meu suggeriment és començar pel parell i la direcció, i després mirar quina alternativa encaixa.
Com mostra MachineTranslation.com on discrepen Qwen i Gemini?
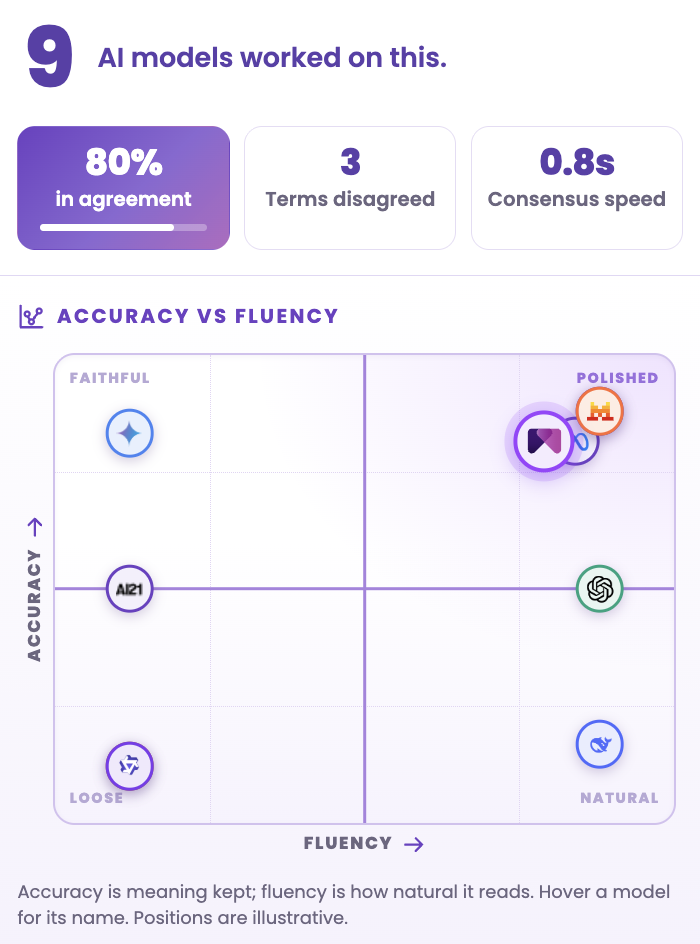
MachineTranslation.com executa ambdós models en cada traducció i mostra on coincideixen els models i on divergeixen. El panell de concordança informa sobre quants models d'IA han treballat en el text, el percentatge de concordança, quants termes han estat en disputa i amb quina rapidesa s'ha format el consens.
Com d'actuals són aquests resultats?
Aquests resultats cobreixen del 12 de juliol al 8 d'agost de 2026, de manera que descriuen les versions de Gemini i Qwen que s'executaven aleshores. Google va anunciar Gemini 4 a l'octubre de 2026. La família Qwen3.8 d'Alibaba va arribar a l'agost de 2026. La meva recomanació és tornar a executar el panell abans de confiar en aquests números per a un nou projecte.
Espero que el mètode de comparar text idèntic amb un marge per al soroll es mantingui ferm. Espero que la mida de les diferències canviï. Consideraria qualsevol parell on canviï el líder en una nova execució com un senyal que la diferència anterior es trobava dins del soroll.
Com triaria entre Qwen i Gemini per a un projecte?
El meu punt de vista és triar per parell i direcció, i evitar triar d'una sola vegada per a tot un projecte. A la pràctica, això vol dir considerar una diferència de menys de 0,1 punts com un empat i esperar que el model líder canviï segons el parell. Aquest és l'ordre que jo seguiria.
- Llista cada parell d'idiomes del projecte i marca'n la direcció.
- Comproveu la diferència per a cada parell en aquest article. Considereu un empat si la diferència és inferior a 0,1 punts.
- On la diferència sigui més gran, comenceu pel model capdavanter i proveu una mostra del vostre propi text.
- Si el vostre contingut va en ambdues direccions, espereu que el líder canviï entre parells.
- Torneu-ho a comprovar quan qualsevol dels dos models tregui una nova versió.
Ambdós models s'executen al costat de 20 més en cada traducció a MachineTranslation.com. Es retorna la versió en què la majoria coincideix, de manera que no cal prendre la decisió una sola vegada per a tot el projecte. El conjunt complet de resultats dels models es troba a les nostres proves de comparació de models.
Preguntes freqüents
1. És millor Qwen o Gemini per a la traducció?
Depèn de la direcció, perquè Qwen es troba a menys de 0,1 punts de Gemini o per davant en 24 de 27 parells cap a l'anglès. Gemini encara va obtenir una puntuació més alta en 68 de 98 parells en les puntuacions de MachineTranslation.com del 12 de juliol al 8 d'agost de 2026. La diferència mitjana és de 0,08 punts sobre 10, així que jo triaria per parell.
2. Quin model de Qwen és el millor per a la traducció?
No ho puc dir a partir de les nostres dades, perquè les puntuacions de MachineTranslation.com tracten Qwen com un únic model sense etiqueta de versió. La família Qwen3.8 d'Alibaba va arribar a Hugging Face l'agost de 2026, de manera que ara n'hi ha diverses versions. Fins que les puntuacions no les separin, compararia les versions amb una mostra del vostre propi text abans de triar-ne una per a un projecte.
3. Quines són algunes alternatives a Gemini per a la traducció?
ChatGPT, Claude, DeepSeek, Qwen, Grok i Mistral AI s'executen tots a MachineTranslation.com. En les nostres puntuacions del 12 de juliol al 8 d'agost de 2026, Qwen es troba a menys de 0,1 punts de Gemini o per davant en 24 de 27 parells cap a l'anglès. La mitjana de francès a anglès de Mistral AI es va situar 0,40 punts per sobre de la de Gemini. L'alternativa adequada depèn del parell.
4. És millor Gemini que ChatGPT per a la traducció?
Depèn del parell d'idiomes, perquè cap model d'IA guanya a tot arreu. En el nostre desglossament publicat d'espanyol a anglès, Gemini va guanyar el 31% dels segments i ChatGPT en va guanyar el 21%. En francès, cap dels dos models guanya en ambdues direccions. Comprovaria el parell i la direcció que necessiteu abans de triar entre ells.
5. És precís Gemini per a la traducció?
Sí, perquè Gemini va obtenir una mitjana de 9,06 sobre 10 en 98 parells d'idiomes en les puntuacions del 12 de juliol al 8 d'agost de 2026 de MachineTranslation.com. La precisió encara varia segons el parell. El seu avantatge és més gran des de l'anglès, i Qwen està per davant seu per més de 0,1 punts en 7 de 27 parells cap a l'anglès.