October 2, 2026
Qwen vs Grok: Quin model d'IA tradueix millor?
Qwen i Grok són models d'IA de propòsit general, no eines específiques de traducció, i tots dos formen part del conjunt de models que MachineTranslation.com executa en cada traducció. Això és important a l'hora de llegir el que ve a continuació. Aquesta és una anàlisi de com es comporten dos dels models de la mateixa plataforma entre ells, amb les advertències reals que comporten aquest tipus de dades, i no una competició entre dos aspirants externs i la plataforma en si.
Què són Qwen i Grok?
Qwen és la família de grans models de llenguatge d'Alibaba, actualment en la seva generació Qwen3.8, i es va afegir al conjunt de models de MachineTranslation.com com a part de l'expansió contínua de la plataforma. Grok és la línia de models d'xAI, actualment en la versió Grok 4.7 en el moment d'escriure aquest article, havent passat per diverses versions des d'aquella que aquest article va comparar originalment, i es va incorporar a la plataforma per separat. Cap dels dos models es va crear específicament per a la traducció. Tots dos són sistemes de propòsit general que, casualment, gestionen molts idiomes com a part d'una capacitat lingüística més àmplia, la qual cosa suposa un punt de partida diferent respecte d'una plataforma construïda i provada específicament al voltant de la qualitat de la traducció.
Com es comparen Qwen i Grok segons les dades pròpies de MachineTranslation.com?
Durant els últims 28 dies de trànsit de la plataforma, Grok va obtenir una puntuació mitjana superior a la de Qwen: 9.26 sobre 10 davant de 8.87. El 10% de les traduccions amb pitjor puntuació de Grok va mantenir una mitjana de 9.2, mentre que el 10% amb pitjor puntuació de Qwen va caure fins al 7.6, una bretxa més àmplia a la franja baixa del que suggereix només la mitjana.
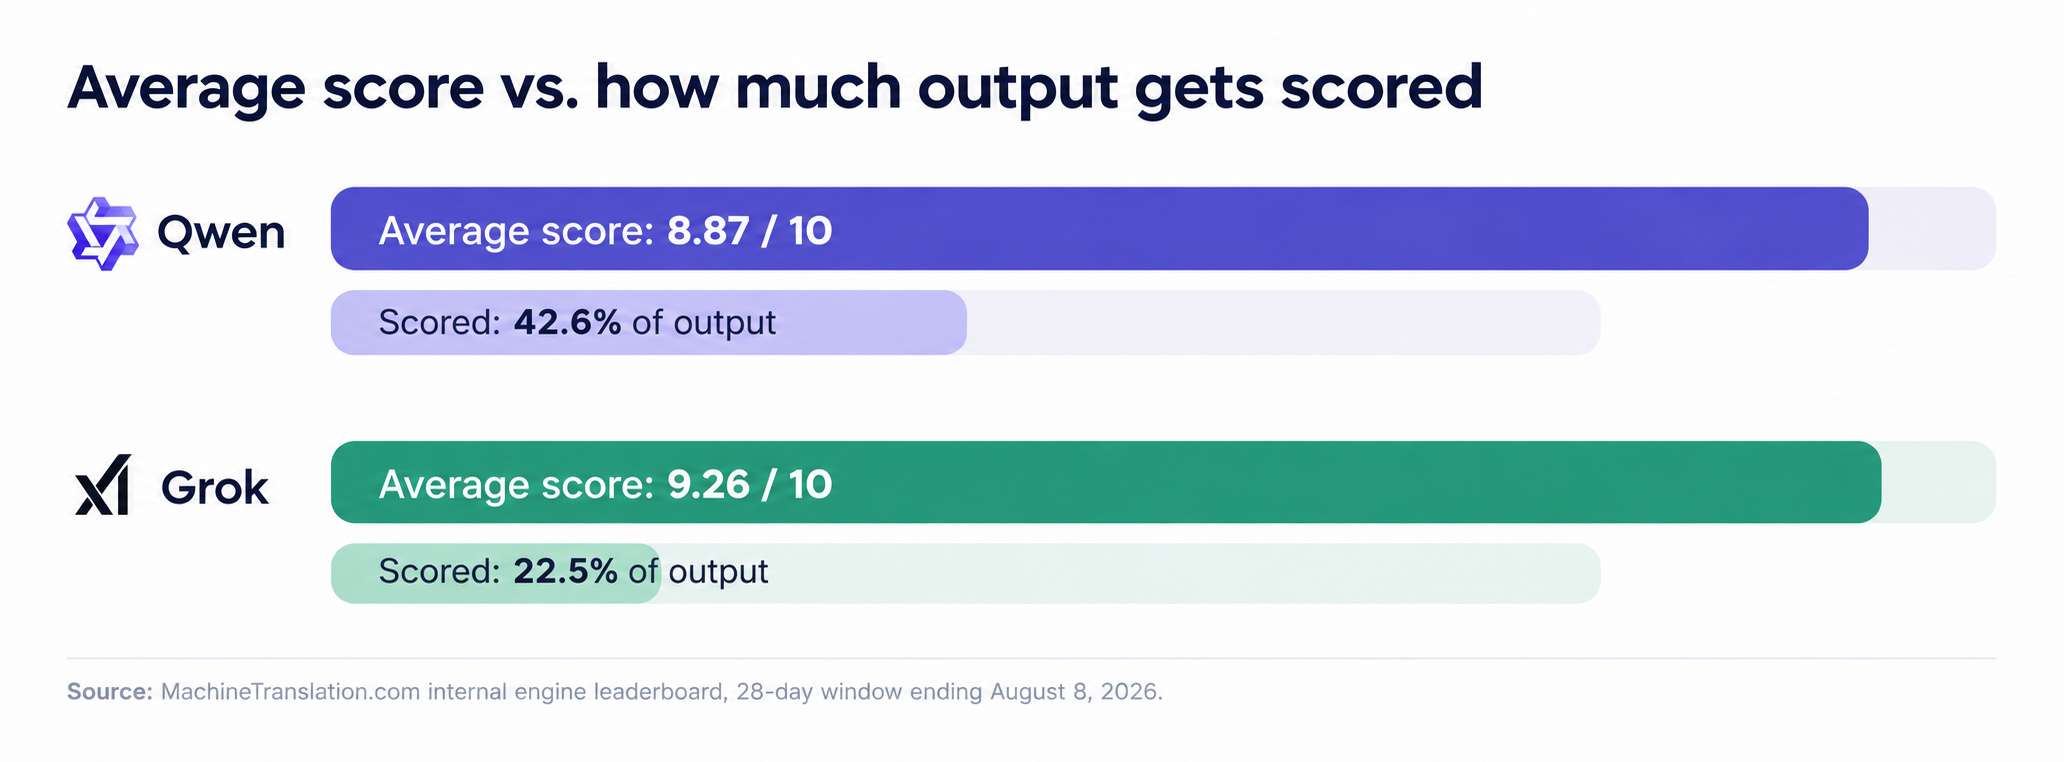
La puntuació mitjana de Grok és més alta, però es basa en haver puntuat menys d'una quarta part de la seva producció, enfront de gairebé la meitat en el cas de Qwen. Les dues barres expliquen parts diferents de la mateixa història.
| Qwen | Grok | |
|---|---|---|
| Percentatge de producció puntuada | 42.6% | 22.5% |
| Puntuació mitjana | 8.87 / 10 | 9.26 / 10 |
| El 10% de les puntuacions més baixes | 7.6 | 9.2 |
Font: rànquing intern de motors de MachineTranslation.com, període de 28 dies finalitzat el 8 d'agost de 2026.
La puntuació més alta de Grok significa que és la millor opció?
No per si sola. Grok s'utilitza molt menys que Qwen a la plataforma, i se'n puntuen menys d'una quarta part de les traduccions, en comparació amb gairebé la meitat de les de Qwen. Una mostra més petita i menys representativa pot fer que una mitjana sembli millor o pitjor del que seria amb el mateix volum que veu Qwen. Els informes de MachineTranslation.com sobre aquestes dades tracten la cobertura de la puntuació com una limitació real, no pas com una nota a peu de pàgina: un motor puntuat en una franja reduïda del seu trànsit no s'ha provat de manera tan exhaustiva com un que ha estat puntuat en gairebé la meitat del seu volum de sortida.
La lectura honesta és que els números de Grok són prometedors, però menys sòlids. Els de Qwen són més baixos de mitjana, però es fonamenten en una base molt més gran i representativa. Cap dels dos fets anul·la l'altre.
Què passa amb la cobertura d'idiomes?
Ni Qwen ni Grok publiquen una llista verificada de parells d'idiomes en què el rendiment disminueixi, i no hi ha proves independents que ho confirmin. El que es pot afirmar amb certesa és que cap dels dos models es va crear centrat en la qualitat de traducció en un conjunt específic d'idiomes, com sí que ho fa una plataforma de traducció dedicada. MachineTranslation.com prova i admet de manera directa més de 270 idiomes, la qual cosa és una afirmació molt diferent de l'àmplia però no contrastada capacitat multilingüe d'un model de propòsit general.
Com utilitza realment MachineTranslation.com Qwen i Grok
MachineTranslation.com executa Qwen, Grok i més de 20 models d'IA diferents en cada traducció, i després mostra la versió en què més coincideixen aquests models. Cap model s'exclou per tenir una puntuació mitjana inferior. Executar molts models alhora permet detectar els casos en què un model amb una puntuació mitjana més baixa encerta una oració específica en què un model amb una puntuació més alta falla. El rendiment de Qwen també varia segons la direcció i el parell d'idiomes d'una manera que val la pena conèixer abans de triar un sol model, cosa que es tracta amb més profunditat a la comparació de Qwen contra DeepSeek de MachineTranslation.com. Per veure amb més detall com es posen a prova els models entre si directament, consulteu les proves de comparació de models completes de MachineTranslation.com.
Preguntes freqüents
1. És millor Qwen o Grok per a la traducció?
Segons les dades de motors de 28 dies pròpies de MachineTranslation.com, Grok obté una puntuació mitjana superior a la de Qwen, 9.26 enfront de 8.87 sobre 10. Però Grok rep puntuacions en una part molt més petita i menys representativa dels seus resultats, així que no és un cara a cara net com ho seria una prova de segments emparellats.
2. Per què Grok té una puntuació mitjana més alta però menys traduccions puntuades?
Grok s'utilitza amb menys freqüència a la plataforma i només es puntua al voltant del 22.5% dels seus resultats, en comparació amb el 42.6% de Qwen. Una mostra més petita i menys representativa pot inflar o subestimar una mitjana, per això aquesta comparació s'ha d'interpretar com a orientativa, no com a definitiva.
3. Admet més idiomes Qwen o Grok?
Tots dos són models d'IA de propòsit general sense una llista publicada i verificada de limitacions específiques de cada idioma. Cap dels dos s'ha creat específicament per a la traducció, la qual cosa és diferent d'una plataforma que prova i puntua la qualitat de la traducció en més de 270 idiomes de manera directa, en lloc de dependre d'un ampli entrenament multilingüe com a substitut d'un rendiment de traducció mesurat.
4. MachineTranslation.com competeix amb Qwen i Grok?
No. MachineTranslation.com executa Qwen, Grok i més de 20 altres models d'IA en cada traducció i mostra la versió en què aquests models coincideixen més. Prova i combina models com aquests en lloc de competir-hi en contra com a model independent propi.
5. Quin model d'IA recomana MachineTranslation.com per a la traducció?
Cap per defecte. Els diferents models tenen un rendiment diferent segons el parell d'idiomes i el tipus de contingut, i la diferència entre ells pot anar en qualsevol direcció depenent del que s'estigui traduint. Aquesta variació és precisament la raó per la qual la plataforma executa diversos models en cada traducció en lloc d'escollir-ne un com a recomanació permanent.