October 9, 2026
Qwen vs ChatGPT: Který AI model překládá lépe?
Současná generace ChatGPT a Qwen jsou součástí nabídky modelů, které MachineTranslation.com využívá při každém překladu, a nikoli dvěma externími konkurenty hodnocenými vůči samotné platformě. Když necháte přeložit stejný text oběma modely na identických segmentech, ChatGPT zvítězí u většiny jazykových párů celkově. Rozdělte však výsledky podle směru překladu a situace se výrazně zúží v jednom konkrétním případě: při překladu do angličtiny, kde jsou oba modely téměř vyrovnané.
Existuje na překlad nějaká AI lepší než ChatGPT?
Všeobecný zájem o alternativy k ChatGPT roste s tím, jak se konkurenční modely zlepšují, ačkoli důvody se podle konkrétního případu použití značně liší a neexistuje jediné vysvětlení. Konkrétně u překladu je užitečnější otázkou to, který model funguje lépe na daném jazykovém páru – což je testovatelná záležitost, nikoli věc pocitu.
Během posledních 28 dní provozu MachineTranslation.com přeložily oba modely identický zdrojový text napříč 98 jazykovými páry. ChatGPT dosáhl vyššího skóre u 77 z těchto párů; Qwen skóroval lépe u 21. Vážený průměr napříč porovnávanými výstupy staví ChatGPT na 9,10 z 10 a Qwen na 8,98, což je v průměru sice reálný, ale mírný rozdíl, který však zakrývá mnohem výraznější propast, jakmile se vezme v úvahu směr překladu.
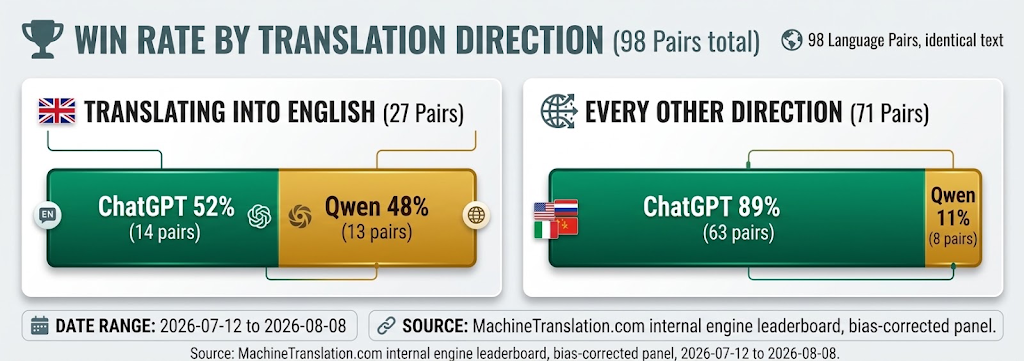
Při překladu do angličtiny jsou oba modely téměř nerozhodně. Ve všech ostatních směrech vítězí ChatGPT u drtivé většiny testovaných párů.
| ChatGPT | Qwen | |
|---|---|---|
| Procento hodnocených výstupů | 54.76% | 42.6% |
| Průměrné skóre | 8.89 / 10 | 8.87 / 10 |
| Nejnižších 10 % skóre | 7.8 | 7.6 |
| Míra úspěšnosti, do angličtiny | 52% | 48% |
| Míra úspěšnosti, všechny ostatní směry | 89% | 11% |
Proč tento rozdíl při překladu do angličtiny téměř mizí?
Data ukazují, kde k tomuto rozdělení dochází, nikoli proč. Jasné je, že konkurenceschopnost modelu Qwen není rovnoměrně rozprostřena. Z 27 párů, kde je cílovým jazykem angličtina, získává Qwen 13, což je v podstatě hod mincí. Ze zbývajících 71 párů, a to jak při překladu z angličtiny, tak mezi dvěma neanglickými jazyky, ChatGPT vítězí v 63 případech, tedy v 89 % z nich. Tým, který by předpokládal, že výkon modelu Qwen při překladu do angličtiny se přenese i na překlady z angličtiny nebo mezi jinými jazykovými páry, by si vyvodil špatné ponaučení ze špatného směru.
Je Qwen čínská společnost a záleží na tom při překladu?
Model Qwen vyvíjí Alibaba Cloud se sídlem v Číně. Samo o sobě to nemění nic na tom, jak dobře model překládá danou větu – výše uvedená data odrážejí skutečnou kvalitu výstupu bez ohledu na to, kde byl model vytvořen. Kde na tom záležet může, je nakládání s daty: podniky překládající regulovaný nebo citlivý obsah (smlouvy, lékařské záznamy, osobní údaje) by měly otázku, kde poskytovatel AI tento obsah zpracovává a ukládá, považovat za skutečný předmět náležité péče (due diligence), oddělený od samotné kvality překladu. To platí pro jakéhokoli poskytovatele AI, nikoli pouze pro Qwen, a je to jeden z důvodů, proč MachineTranslation.com přímo zveřejňuje své vlastní postupy nakládání s daty a bezpečnostní zásady, místo aby tuto otázku ponechávala nezodpovězenou.
Je některý z těchto modelů spolehlivější pro právní a obchodní překlady?
Ne konzistentně a divergence nespočívá vždy v tom, který model dosáhne vyššího skóre. Testování webu MachineTranslation.com na reálném smluvním jazyce odhalilo dva samostatné případy, které stojí za to znát předtím, než kterémukoli z modelů svěříte právní text. Idiomatický jazyk se někdy chová opačně: samostatný přímý test ukázal, že ChatGPT přeložil německý idiom doslovně a nesprávně, zatímco Qwen našel správný idiomatický význam – což je připomínka, že celkový náskok žádného z modelů v souhrnných datech neplatí větu po větě.
| Testovací případ | ChatGPT | Qwen |
|---|---|---|
| „At-will employment“ do němčiny | Použitelná, funkční formulace | Sáhl po nesouvisejícím právním konceptu |
| Klauzule o omezení odpovědnosti do španělštiny | „que surjan de“ | „derivados de“ (rozdíl měnící rozsah) |
| „Ich verstehe nur Bahnhof“ (německý idiom) | Přeloženo doslovně, nesprávně | Správný idiomatický význam |
Ani jeden z modelů v těchto třech případech konzistentně nevítězí: celkové souhrnné skóre modelu nepředpovídá jeho chování u jakéhokoli konkrétního termínu či fráze. To je také důvod, proč právním a smluvním textům prospívá krok lidské kontroly bez ohledu na to, který model vytvořil první návrh.
A jak je to s jazykovým pokrytím?
Ani ChatGPT, ani Qwen nezveřejňují ověřený, nezávisle potvrzený seznam jazykových párů, u kterých kvalita překladu klesá. Oba jsou univerzální modely s rozsáhlým vícejazyčným tréninkem, což je však jiné tvrzení než naměřený překladatelský výkon napříč konkrétní sadou jazyků. MachineTranslation.com přímo testuje a hodnotí kvalitu překladu napříč více než 330 jazyky, místo aby spoléhal na obecné jazykové schopnosti modelu jako na ukazatel toho, jak dobře ve skutečnosti překládá.
Co byste neměli vkládat do ChatGPT nebo Qwen pro firemní překlady?
Ani ChatGPT, ani Qwen nebyly vytvořeny jako specializované překladatelské platformy a vkládání citlivého firemního obsahu přímo do univerzálního chatovacího rozhraní s sebou nese stejné otázky ohledně nakládání s daty jako jeho vkládání do jakéhokoli jiného spotřebitelského nástroje AI: kde se vstup zpracovává, zda se uchovává a kdo k němu má přístup. Smlouvy, lékařské záznamy, imigrační dokumenty a finanční výkazy jsou přesně tím typem obsahu, u kterého stojí za to tuto otázku zodpovědět před překladem, nikoli až po něm. To je pádný důvod, proč specializovaná překladatelská platforma se zveřejněnými a ověřitelnými postupy nakládání s daty představuje zcela jinou nabídku než univerzální chatovací rozhraní, bez ohledu na to, jaký model stojí v pozadí.
Jak MachineTranslation.com oba modely ve skutečnosti využívá
MachineTranslation.com spouští ChatGPT, Qwen a více než 20 dalších modelů AI pro každý překlad a poté nabízí verzi, na které se tyto modely nejvíce shodují. Vzhledem k tomu, jak výrazně se výkon modelů Qwen a ChatGPT liší podle směru překladu, by volba jednoho modelu jako trvalého výchozího nastavení znamenala chybný odhad u předvídatelné části jazykových párů. Stejný vzorec závislý na směru se projevuje i ve srovnání modelů Qwen a DeepSeek na MachineTranslation.com. Úplný přehled o tom, jak jsou současné modely vzájemně testovány, najdete v kompletním srovnávacím testování modelů na MachineTranslation.com.
Často kladené otázky
1. Je pro překlad lepší Qwen, nebo ChatGPT?
V 98 jazykových párech testovaných na identickém zdrojovém textu dosáhl ChatGPT vyššího skóre v 77 z nich. Nejsilnější stránkou modelu Qwen je překlad do angličtiny, kde jsou oba modely téměř vyrovnané. Ve všech ostatních směrech vítězí ChatGPT v drtivé většině párů, takže upřímná odpověď do značné míry závisí na tom, kterým směrem se obsah překládá.
2. Podporuje více jazyků ChatGPT, nebo Qwen?
Oba jsou univerzální modely AI bez ověřeného a zveřejněného seznamu jazykových omezení. Ani jeden nezveřejňuje nezávisle potvrzená data o pokrytí jazykových párů, což se liší od platformy, která přímo testuje a hodnotí kvalitu překladu napříč více než 330 jazyky, místo aby spoléhala na obecná tvrzení o vícejazyčném tréninku.
3. Je pro právní a obchodní překlady lepší Qwen, nebo ChatGPT?
Ani jeden z nich není spolehlivě lepší ve všech ohledech. Při testování německého pracovněprávního pojmu vytvořily modely DeepSeek a ChatGPT použitelné funkční formulace, zatímco Claude i Qwen sáhly po nesouvisejícím právním konceptu, což ukazuje, že rozdíly závisí na konkrétním termínu a kontextu, nikoli na tom, který model je obecně silnější.
4. Konkuruje MachineTranslation.com modelům ChatGPT a Qwen?
Ne. MachineTranslation.com spouští pro každý překlad ChatGPT, Qwen a více než 20 dalších modelů AI a nabízí verzi, na které se tyto modely nejvíce shodují. Tyto modely testuje a kombinuje, místo aby vystupoval jako samostatný konkurenční model.
5. Který model bych si měl vybrat pro rozsáhlý lokalizační projekt?
Ani jeden z nich sám o sobě není bezpečnou výchozí volbou, jakmile se obsah překládá mezi mnoha jazyky v obou směrech. Zde zdokumentovaný rozdíl závislý na směru překladu znamená, že model, který si vede dobře při překladu do angličtiny, může podávat velmi odlišné výkony při překladu z ní, a to napříč desítkami jazykových párů současně.
6. Který model Qwen je pro překlad nejlepší?
Tyto informace zatím nejsou k dispozici. Sledování platformy MachineTranslation.com v současnosti na rozdíl od jiných poskytovatelů eviduje Qwen jako jediný engine bez označení verze modelu, takže data o kvalitě jednotlivých podverzí nelze vykázat. Jakmile to bude napraveno, bude možné provést skutečné porovnání mezi Qwen3.8-Max a Qwen3.8-27B; prozatím jde o skutečnou mezeru v datech, nikoli jen o nezměřený detail.