September 25, 2026
Von GPT-3 bis GPT-5: Wie sich die KI-Übersetzungsqualität tatsächlich verändert hat
GPT-3, GPT-4 und GPT-5 liegen fünf Jahre und mehrere Architekturgenerationen auseinander, aber die entscheidende Frage für die Übersetzung lautet nicht: „Welches ist das klügste?“ Sie ist spezifischer: Was genau hat sich daran geändert, wie diese Modelle mit den Aspekten einer Sprache umgehen, die sich nicht Wort für Wort übersetzen lassen – Dinge wie Redewendungen, Mehrdeutigkeiten und Sprachebenen? Die Verbesserung zeigte sich an bestimmten Stellen, zu bestimmten Zeitpunkten, und sie verlief keineswegs geradlinig von alt nach neu.
Was GPT-3 tatsächlich für die Übersetzung bot
OpenAI veröffentlichte GPT-3 im Jahr 2020, noch bevor das eigene Testprogramm von MachineTranslation.com existierte, daher handelt es sich hierbei um keinen proprietären Benchmark. Es ist gut dokumentierte Geschichte, kein internes Testergebnis. GPT-3 war das erste Modell seiner Art, das in der Lage war, flüssigen, menschlich klingenden Text in mehreren Sprachen ohne aufgabenspezifisches Training zu generieren, was es zu einem echten Meilenstein machte. Speziell für die Übersetzung barg dieselbe Sprachgewandtheit jedoch ein echtes Risiko: GPT-3 konnte einen selbstbewussten, wohlgeformten Satz in der Zielsprache erzeugen, der dennoch falsch war – ohne dass an der Ausgabe erkennbar gewesen wäre, dass ein Fehler aufgetreten war.
Was sich mit dem Erscheinen von GPT-4 änderte
GPT-4 kam im März 2023 auf den Markt, und die Modelltests von MachineTranslation.com setzen etwa ab dieser Generation an. Die Verbesserung war spürbar, aber uneinheitlich. Beim Testen der mehrdeutigen englischen Formulierung „That's sick“ im Japanischen war GPT-4.1-nano das einzige von sechs getesteten Modellen, das die bewusste Doppelbedeutung der Formulierung auf eine einzige Interpretation reduzierte, während die anderen fünf die beabsichtigte Mehrdeutigkeit des Originalausdrucks beibehielten. Redewendungen stellten eine größere Schwachstelle dar: Als das spanische Idiom „llevarse el gato al agua“ gleichzeitig durch fünf GPT-Versionen getestet wurde, lieferten die kleineren Modelle GPT-4o-mini und GPT-4.1-nano jeweils dieselbe wörtliche, falsche Übersetzung und verfehlten die Redewendung völlig.
Dasselbe Muster zeigte sich auch an anderer Stelle. Die deutsche Redewendung „ich verstehe nur Bahnhof“, getestet an acht GPT- und Claude-Unterversionen, wurde speziell von GPT-4o-mini wörtlich und falsch übersetzt, während ein kleineres, neueres Modell im selben Test, GPT-4.1-nano, sie richtig erfasste. Generation und Modellgröße korrelierten in keiner konsistenten Weise – ein Muster, das die Modellversions-Tests von MachineTranslation.com noch eingehender beleuchten.
Was GPT-5 für die Übersetzung veränderte
OpenAI führte GPT-5 als einheitliches System ein, das je nach Aufgabe zwischen einem schnellen Standardmodell und einem tiefergehenden Reasoning-Modell vermittelt – eine strukturelle Änderung gegenüber dem Einzelmodell-Design von GPT-4. OpenAIs eigene GPT-5 System Card beziffert die Gesamtrate an Faktenfehlern des Modells auf rund 45 % niedriger als bei GPT-4 und 80 % niedriger als bei GPT-3 – ein allgemeiner Zuwachs an Zuverlässigkeit, der sich auch speziell bei Übersetzungen zeigt. Die Tests von MachineTranslation.com weisen die deutlichsten Verbesserungen dort auf, wo Modelle der GPT-4-Ära die größten Schwierigkeiten hatten: Bei derselben spanischen Redewendung, an der GPT-4o-mini und GPT-4.1-nano scheiterten, erzielten sowohl GPT-5.4-mini als auch GPT-5.4 korrekte, idiomatische Übersetzungen – jeweils etwas anders formuliert, aber beide mit einem Verständnis für die Redewendung selbst.
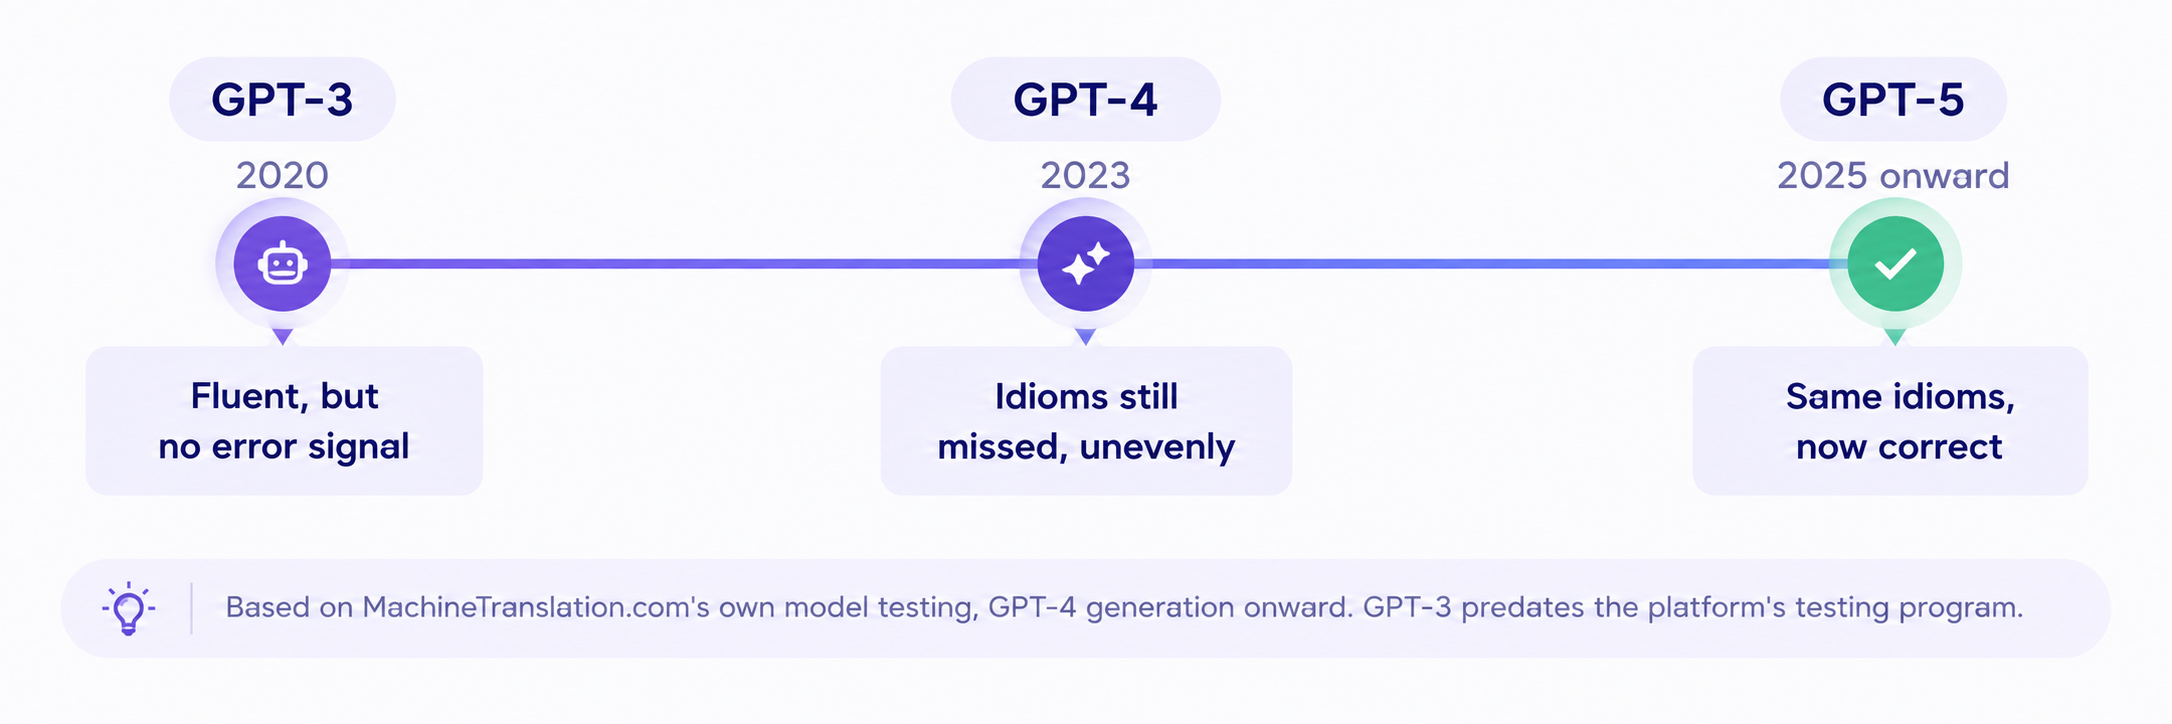
Der Unterschied zwischen den Generationen war kein kontinuierlicher Anstieg. Er konzentrierte sich fast ausschließlich auf idiomatische und mehrdeutige Sprache. Bei unkomplizierten Texten schneiden Modelle der GPT-4- und GPT-5-Ära nahezu identisch ab.
| GPT-3 | GPT-4 | GPT-5 | |
|---|---|---|---|
| Veröffentlicht | 2020 | März 2023 | 2025, mittlerweile bei GPT-5.4/5.5 |
| Heute verfügbar | Nein, eingestellt | Nur per API, in ChatGPT eingestellt | Ja, aktuelle Generation |
| Umgang mit Redewendungen | Nicht von MachineTranslation.com getestet (vor Beginn des Testprogramms) | Uneinheitlich; verfehlte mehrere Redewendungen gänzlich | Übersetzte dieselben Redewendungen korrekt, an denen GPT-4 scheiterte |
| Standard-Geschäftstexte | Nicht von MachineTranslation.com getestet | Stark, nahezu identisch mit späteren Modellen | Stark, nahezu identisch mit GPT-4 |
Dieser letzte Punkt ist wichtig: Ein separater Test einer geschäftlichen Standardphrase – „please confirm receipt of this document“ –, die ins Deutsche übersetzt wurde, lieferte bei allen getesteten Modellen nahezu identische Ergebnisse, einschließlich GPT-4o-mini und Modellen der GPT-5-Generation. Der Generationsunterschied zeigt sich spezifisch bei bildhafter und mehrdeutiger Sprache, nicht als pauschaler Qualitätsunterschied.
Bedeutet eine neuere GPT-Generation immer eine bessere Übersetzung?
Nein. Beim Testen einer hebräischen Redewendung über verschiedene Modellfamilien hinweg kamen GPT-5.4-mini und GPT-5.4 zu zwei unterschiedlichen, unvollständigen Interpretationen desselben Ausdrucks – keine davon war vollständig korrekt, während ein älteres, nicht verwandtes Modell näher herankam. Ein neueres Modell ist nicht automatisch ein genaueres, und ein größeres oder aktuelleres Modell ist für einen bestimmten Satz nicht automatisch die sicherere Wahl.
Wo GPT-5 heute bei Übersetzungen steht
GPT-3 und GPT-4 wurden beide aus ChatGPT entfernt; GPT-4 bleibt nur über die API von OpenAI für bestehende Integrationen erreichbar. Die aktuelle Generation, GPT-5.4 und GPT-5.5, setzt MachineTranslation.com heute ein, und sie schneidet im Vergleich zu aktuellen Modellen anderer Anbieter konkurrenzfähig ab, wenn auch nicht einheitlich besser bei jedem Sprachpaar. Für einen genaueren Blick darauf, wie aktuelle GPT-Unterversionen untereinander und mit Modellen wie Claude und DeepSeek im Vergleich abschneiden, bieten die Head-to-Head-Subversions-Tests von MachineTranslation.com tiefere Einblicke, als es eine generationenübergreifende Übersicht vermag.
Was das bedeutet, wenn Sie im großen Maßstab lokalisieren
Die wichtigste Erkenntnis für ein großes Lokalisierungsprogramm lautet nicht „GPT-5 schlägt GPT-3“. Es ist die Tatsache, dass die Modellversion und nicht nur die Modellfamilie darüber entscheidet, ob eine bestimmte Redewendung oder mehrdeutige Formulierung korrekt übersetzt wird – und das gilt für jedes Sprachpaar, nicht nur für die wenigen hier gezeigten. Dies ist vor allem bei Inhalten von Bedeutung, die von vornherein auf Tonalität und bildhafte Sprache setzen, insbesondere bei Marketingtexten und nutzergenerierten Inhalten, bei denen eine einzige wörtlich übersetzte Redewendung die gesamte Bedeutung eines Beitrags oder einer Anzeige verändern kann. Ein Programm, das Inhalte in Dutzende von Sprachen überträgt, wird in jeder einzelnen davon auf genau diese Art von Sprache stoßen. Die Subversions-Testreihe und die umfassenden Modellvergleichstests von MachineTranslation.com behandeln dies ausführlicher. Der Ansatz der Plattform, bei jeder Übersetzung aktuelle GPT-Modelle parallel zu mehr als 20 weiteren Modellen auszuführen, existiert genau deshalb, weil die Versionshistorie keines einzelnen Modells für sich genommen eine verlässliche Garantie darstellt.
Häufig gestellte Fragen
1. Was ist der wirkliche Unterschied zwischen GPT-3, GPT-4 und GPT-5 bei Übersetzungen?
GPT-3 kam mit einfachen Texten recht gut zurecht, hatte jedoch bei allem, was idiomatisch oder mehrdeutig war, erhebliche Schwierigkeiten. GPT-4 verringerte diese Lücke deutlich, reduzierte jedoch manche wirklich mehrdeutigen Ausdrücke auf eine einzige Bedeutung, anstatt die Mehrdeutigkeit beizubehalten. Die späteren Unterversionen von GPT-5 bewältigten Redewendungen korrekt, die von früheren Modellen der GPT-4-Ära noch wörtlich und falsch übersetzt wurden.
2. Ist GPT-5 beim Übersetzen immer besser als GPT-4?
Nein. Die eigenen Tests von MachineTranslation.com haben Fälle gezeigt, in denen eine kleinere, neuere Unterversion eine größere, ältere übertraf. Zudem betrifft der Qualitätsunterschied zwischen den Generationen eher idiomatische oder bildhafte Sprache als eine allgemeine, flächendeckende Verbesserung.
3. Bietet OpenAI weiterhin GPT-3 oder GPT-4 an?
Nein. Beide wurden aus ChatGPT entfernt und durch neuere Modelle der GPT-5-Generation ersetzt. GPT-4 bleibt nur über die API von OpenAI für bestehende Integrationen zugänglich, nicht jedoch als aktuelle Option für Endnutzer.
4. Welche GPT-Version verwendet MachineTranslation.com?
MachineTranslation.com nutzt bei jeder Übersetzung aktuelle Modelle der GPT-5-Generation (GPT-5.4 und GPT-5.5, je nach Tarifstufe) parallel zu mehr als 20 weiteren KI-Modellen, anstatt sich allein auf GPT zu verlassen.
5. Wie schneidet GPT-5 im Vergleich zu anderen aktuellen KI-Modellen bei der Übersetzung ab?
Modelle der GPT-5-Generation schneiden wettbewerbsfähig ab, sind jedoch nicht durchweg besser als Modelle wie Claude, Gemini oder DeepSeek. Unterschiedliche Modelle schneiden bei verschiedenen Sprachpaaren und Inhaltstypen am besten ab, weshalb MachineTranslation.com sie direkt gegeneinander testet, anstatt eines als Standard festzulegen.