April 16, 2026
Grok vs. ChatGPT für Übersetzungen: Welches sollten Sie 2026 nutzen?
Wahrscheinlich haben Sie bereits einen Tab mit einem davon geöffnet. Die Frage ist, ob das, was dabei herauskommt, präzise genug ist, um es (für ein Kundendokument, eine Produktseite, eine Vertragsklausel) zu verwenden, ohne die nächsten 20 Minuten damit zu verbringen, jeden Satz zu hinterfragen.
Dieser Artikel vergleicht Grok 4.1 und ChatGPT (GPT-5.4) speziell für Übersetzungszwecke: was jedes gut macht, wo jedes scheitert und was Sie brauchen, wenn keines von beiden ganz ausreicht.
Was ist Grok und wie hat es sich entwickelt?
Grok ist ein großes Sprachmodell, das von xAI entwickelt wurde, dem KI-Unternehmen, das 2023 von Elon Musk gegründet wurde (nach einer Übernahme im Februar 2026 nun Teil von SpaceX). Seit seiner Einführung hat Grok vier große Generationen durchlaufen: Grok 1 (2023), Grok 2 (2024), Grok 3 (Februar 2025) und Grok 4 (Juli 2025), wobei Grok 4.1 ab Ende 2025 verfügbar sein wird.
Groks prägendes architektonisches Merkmal ist der Echtzeit-Datenzugriff. Im Gegensatz zu den meisten großen Sprachmodellen, die auf statischen Datensätzen trainiert wurden, integriert Grok Live-Websuche und Daten der Plattform X (ehemals Twitter) in seine Ausgaben. Dies macht es besonders geeignet für Inhalte, die aktuelle Ereignisse, neu entstehende Terminologie, kürzlich geprägte Branchenbegriffe oder zeitkritisches Ausgangsmaterial betreffen – Kategorien, in denen Modelle, die auf älteren Datenständen trainiert wurden, veraltete Formulierungen einbringen oder den aktuellen Kontext verpassen können.
Speziell für Übersetzungen ist der Echtzeitzugriff von Grok ein echter Vorteil bei einer kleinen, aber wichtigen Gruppe von Anwendungsfällen: der Übersetzung von Nachrichteninhalten, Pressemitteilungen, regulatorischen Aktualisierungen und Materialien, die sich auf aktuelle Ereignisse oder neu entstehende Begriffe beziehen. Seine mehrsprachige Unterstützung hat sich mit jeder aufeinanderfolgenden Modellgeneration verbessert. Grok 4.1 bietet ein 131K-Token-Kontextfenster, eine verbesserte mehrsprachige Ausgabe und native Tool-Nutzung mit Echtzeit-Suchintegration.
Wo Grok im Vergleich zu dedizierter Übersetzungsinfrastruktur noch schlechter abschneidet: Es ist ein Allzweckmodell, kein übersetzungsspezifisches. Es erzeugt eine einzige Ausgabe ohne internen Verifizierungsmechanismus. Die Ausgabequalität variiert je nach Sprachpaar und Inhaltstyp, und es gibt keine modellübergreifende Überprüfung, um die Ausgabe abzufangen, wenn sie falsch ist.
Was ist ChatGPT und was ändert GPT-5.4?
ChatGPT ist eine konversationelle KI, die von OpenAI entwickelt wurde und auf deren GPT-Architektur (Generative Pre-trained Transformer) basiert. Es startete im November 2022 und wurde zur am schnellsten wachsenden Verbraucheranwendung der Geschichte. Das aktuelle Modell mit Stand April 2026 ist GPT-5.4, veröffentlicht am 5. März 2026.
Für Übersetzungsaufgaben gehört ChatGPT zu den stärksten verfügbaren Allzweck-LLMs. Im internen Benchmark von MachineTranslation.com über 5.000 Wörter an gemischten technischen und Marketing-Inhalten erzielte ChatGPT eine Genauigkeit von 89,8 % – es schnitt bei der oberflächlichen Qualität gut ab, produzierte jedoch während dieses Tests in zwei Schlüsselsätzen halluzinierte Inhalte. In unabhängigen wissenschaftlichen Benchmarks erzielt GPT-5.4 92,0 % beim GPQA-Diamond-Test (wissenschaftliches Denken auf PhD-Niveau), was auf eine starke Leistung bei komplexen, faktenabhängigen Inhalten hinweist, bei denen es auf Genauigkeit ankommt.
ChatGPT unterstützt eine breite Palette von Sprachen und bewältigt komplexe Satzstrukturen, idiomatische Formulierungen und ein professionelles Register über europäische und wichtige asiatische Sprachpaare hinweg gut. Seine Schwächen bei der Übersetzung sind eher strukturell als qualitätsbezogen: Wie jedes Einzelmodell-KI-System kann es seine eigene Ausgabe nicht überprüfen. Wenn es halluziniert (und eine flüssig klingende Übersetzung erzeugt, die sachlich oder semantisch falsch ist), gibt es kein Signal, das den Benutzer warnt.
Wie schneiden Grok und ChatGPT bei der Übersetzungsgenauigkeit im Vergleich ab?
Beide Tools liefern qualitativ hochwertige Übersetzungen für allgemeine Inhalte. Die wesentlichen Unterschiede treten an den Rändern zutage — wenn Inhalte spezialisiert, technisch, zeitkritisch oder hochriskant sind.
Wo Grok im Vorteil ist: Inhalte zum aktuellen Zeitgeschehen, aufkommende Terminologie und Materialien, die einen aktuellen Kontext erfordern. Die Live-Suche-Integration von Grok bedeutet, dass es bei der Übersetzung von Nachrichtenartikeln, Produkteinführungen oder regulatorischen Updates auf aktuelle Nutzungsmuster zurückgreifen kann — Inhalte, bei denen ein Modell, das auf Daten von vor sechs Monaten trainiert wurde, veraltete Formulierungen erzeugen kann.
Wo ChatGPT im Vorteil ist: Strukturierte, faktenreiche Inhalte — wissenschaftliche, juristische und technische Texte, bei denen die Genauigkeit der etablierten Terminologie wichtiger ist als die Aktualität. Der GPQA-Benchmark-Score von GPT-5.4 von 92,0 % und eine im Vergleich zu früheren Modellen um 33 % niedrigere Rate an Falschaussagen machen es zur besseren Wahl für die hochpräzise professionelle Übersetzung von komplexem Ausgangsmaterial.
Was keines der beiden Tools leisten kann: Seine eigene Ausgabe überprüfen. Einzelne erstklassige LLMs (darunter sowohl Grok als auch ChatGPT) halluzinieren oder erfinden bei Übersetzungsaufgaben in 10 % bis 18 % der Fälle Inhalte, wie aus synthetisierten Daten von Intentos „State of Translation Automation 2025“ und den „WMT24 General Machine Translation Findings“ hervorgeht. Für professionelle, kundenorientierte oder regulierte Inhalte ist diese Spanne keine akzeptable Fehlertoleranz.
| Grok 4.1 | ChatGPT (GPT-5.4) | |
|---|---|---|
| Am besten geeignet für | Zeitkritische Inhalte zu aktuellen Ereignissen | Strukturierte, technische, faktenreiche Inhalte |
| Echtzeit-Datenzugriff | Ja — Live-X- und Web-Integration | Nein — statische Trainingsdaten |
| Genauigkeits-Benchmark | AIME 2025: 91,7% (mathematisches Denken) | GPQA Diamond: 92,0% (wissenschaftliches Denken) |
| Übersetzungs-Benchmark | ---- | 89,8% bei 5.000 Wörtern gemischtem Inhalt (mit 2 halluzinierten Sätzen) |
| Ausgabeverifizierung | Einzelnes Modell, kein Verifizierungssignal | Einzelnes Modell, kein Verifizierungssignal |
| Halluzinationsrate (einzelnes Modell) | 10–18% (Intento/WMT24) | 10–18% (Intento/WMT24) |
Wie unterscheidet sich die Sprachunterstützung zwischen Grok und ChatGPT?
ChatGPT unterstützt eine breite Palette von Sprachen aus allen großen Sprachfamilien. Es erbringt die stärkste Leistung bei europäischen Sprachpaaren und asiatischen Hauptsprachen (Chinesisch, Japanisch, Koreanisch), mit einer etwas weniger konsistenten Qualität bei ressourcenärmeren Sprachen.
Grok hat seine mehrsprachige Unterstützung über die Modellgenerationen hinweg schrittweise erweitert. Grok 4.1 bietet bei nicht-englischen Ausgaben eine deutliche Verbesserung gegenüber früheren Versionen, obwohl es weiterhin auf ressourcenreiche Sprachpaare ausgerichtet bleibt, bei denen Trainingsdaten im Überfluss vorhanden sind.
MachineTranslation.com unterstützt über 330 Sprachen, indem es 22 KI-Modelle gleichzeitig aggregiert (einschließlich Grok und ChatGPT) und die Ausgabe auswählt, auf die sich die Mehrheit einigt. Für Teams, die in mehreren Märkten oder mit weniger verbreiteten Sprachpaaren arbeiten, erübrigt dieser Ansatz die Notwendigkeit, jedes Tool für jede Sprache unabhängig zu evaluieren.
Für spezifische Empfehlungen zu Sprachpaaren: Englisch zu Spanisch, Englisch zu Französisch, Englisch zu Deutsch.
Wie verhält sich die Preisgestaltung im Vergleich zwischen Grok und ChatGPT?
Grok (xAI):
- Kostenlose Version: Verfügbar über X mit eingeschränktem Grok-Zugriff
- X Premium+: $22/Monat — inklusive Grok-Chatbot-Zugriff
- SuperGrok: $30/Monat — erweiterte Funktionen
- API (Grok 4.1): $0.20 per 1 million input tokens / $0,50 pro 1 Million Output-Token — gehört zu den niedrigsten API-Preisen auf dem LLM-Markt
ChatGPT (OpenAI):
- Kostenlose Version: Mit eingeschränkten Funktionen verfügbar
- ChatGPT Plus: $20/Monat
- ChatGPT Pro: $200/Monat
- API (GPT-5.4): $1.75 per 1 million input tokens / $14,00 pro 1 Million Ausgabetoken
MachineTranslation.com:
- Kostenlos: Tägliches Limit ohne Anmeldung; Übersetzungen werden alle 24 Stunden zurückgesetzt
- Pro-Plan: 39 $/Monat — unbegrenzte Übersetzungen, Dokumentenverarbeitung, Originallayout beibehalten
- 24-Stunden-Vollzugriff: 9,50 $ (einmalig, keine automatische Verlängerung)
Groks API-Preise sind deutlich niedriger als die von ChatGPT, was sie für eine hochvolumige API-Nutzung preislich attraktiv macht. Speziell für Übersetzungen sind die Kosten pro Token jedoch nur eine Dimension — Ausgabequalität, Verifizierung und Fehlerkorrekturkosten sind in professionellen Kontexten ebenso wichtig.
Wer hat die bessere API für Übersetzungs-Workflows?
Groks API wurde mit der Umstellung von xAI auf eine nutzungsbasierte Preisgestaltung im Oktober 2025 vollständig verfügbar. Die Preise gehören mit 0,20 $ pro 1 Mio. Input-Token (Grok 4.1) zu den niedrigsten auf dem Markt. Die Dokumentation hat sich seit der Grok 3 Beta erheblich erweitert. Für Entwickler, die Pipelines erstellen, die eine Echtzeit-Datenintegration erfordern, ist die API von Grok eine starke Option.
Die API von ChatGPT (OpenAI) ist die ausgereifteste und am umfassendsten dokumentierte LLM-API, die verfügbar ist. Es unterstützt Funktionsaufrufe, strukturierte Ausgaben, benutzerdefinierte GPTs und ein breites Integrationsökosystem. Mit 1,75 $ pro 1 Mio. Input-Token für GPT-5.4 ist es erheblich teurer als Grok, bietet jedoch die tiefere Anpassung und die nachgewiesene Stabilität, die Enterprise-Workflows typischerweise erfordern.
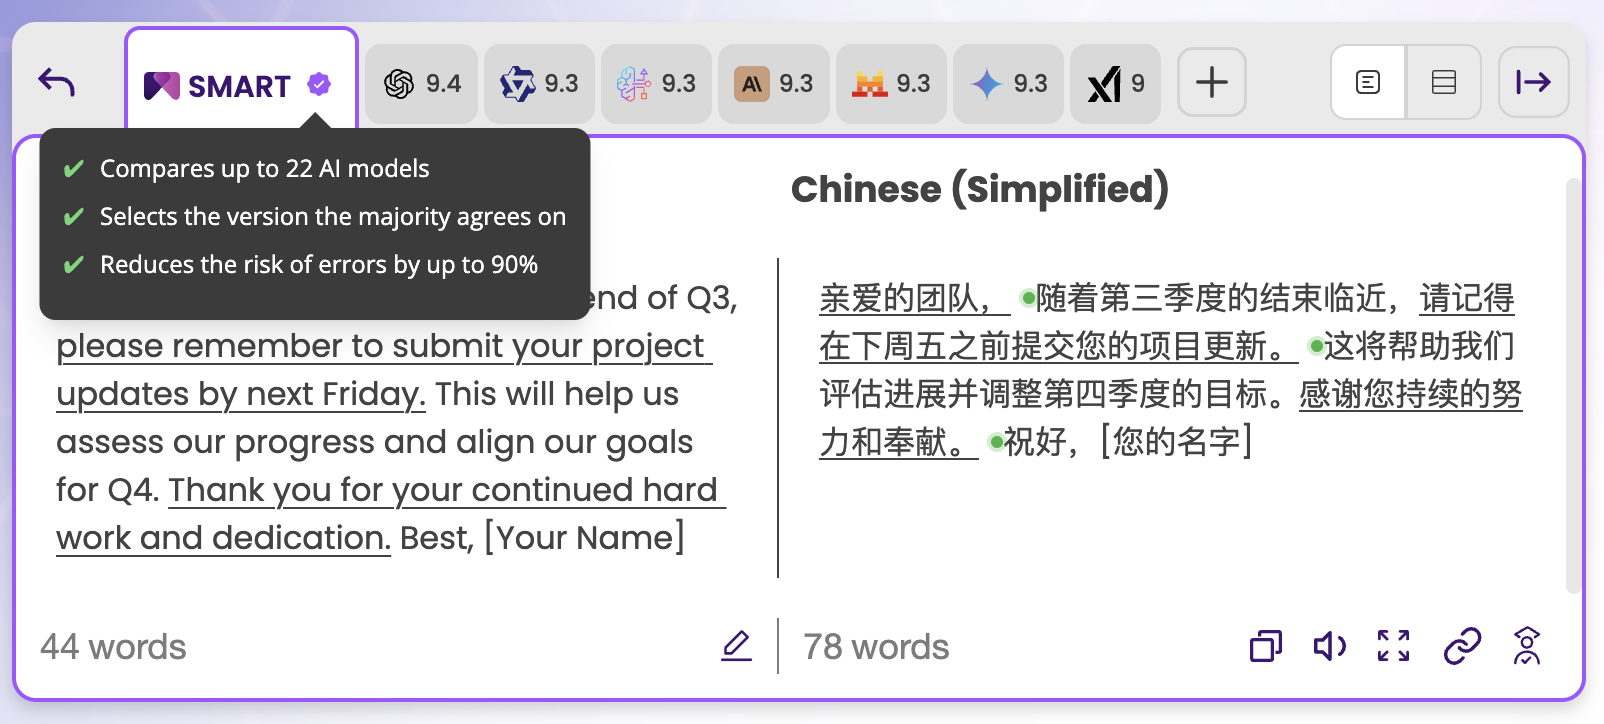
Die API von MachineTranslation.com leitet Anfragen gleichzeitig durch alle 22 Modelle (einschließlich Grok und ChatGPT) und gibt die SMART-Konsens-Ausgabe zurück. Für Entwickler, die verifizierte Übersetzungsqualität in großem Umfang benötigen, ersetzt ein einziger API-Aufruf die Notwendigkeit, mehrere Engine-Integrationen unabhängig voneinander zu verwalten, zu bewerten und zu vergleichen.
Für einen Überblick über die Optionen und Preise von Übersetzungs-APIs: Vergleich von Übersetzungs-APIs.
Welches Tool eignet sich besser für welche Art von Übersetzung?
Verwenden Sie Grok 4.1 für:
- Inhalte zu aktuellen Ereignissen, Zeitungsartikel und Pressemitteilungen, bei denen es auf aktuellen Kontext ankommt
- Das Übersetzen von Materialien mit neuer Terminologie oder kürzlich geprägter Branchensprache
- Übersetzungen mit großem Volumen und geringerem Risiko, bei denen die Kosten pro Token im Vordergrund stehen
- Inhalte, die sich auf aktuelle kulturelle Ereignisse oder Sprachmuster in sozialen Medien beziehen
Verwenden Sie ChatGPT (GPT-5.4) für:
- Technische, wissenschaftliche und professionelle Inhalte, bei denen es auf strukturierte Genauigkeit ankommt
- Rechtliche, finanzielle oder medizinische Texte mit etablierter Terminologie
- Längere Dokumente, bei denen die logische Kohärenz über den gesamten Text hinweg wichtig ist
- Jeden Kontext, in dem die breiten Ökosystem-Integrationen von GPT (Word, Notion, Zapier usw.) bereits genutzt werden
In beiden Fällen: Keines der beiden Tools überprüft seine eigene Ausgabe, und keines liefert ein Zuverlässigkeitssignal, bevor Sie die Übersetzung absenden.
Was tun Sie, wenn die Genauigkeit absolut sicher sein muss?
Sowohl Grok als auch ChatGPT liefern nützliche Übersetzungen. Sie scheitern auf dieselbe strukturelle Weise: Ein einzelnes Modell kann die Fehler, die es produziert, nicht abfangen. Wenn Grok einen juristischen Begriff falsch wiedergibt oder ChatGPT zwei Sätze mitten in einem technischen Dokument halluziniert hat (wie es beim internen 5.000-Wörter-Benchmark von MachineTranslation.com der Fall war), gibt es in der Ausgabe keinen Hinweis darauf, wo dies geschehen ist.
Das ist das Problem, das der SMART-Mechanismus von MachineTranslation.com konzeptbedingt löst. SMART lässt jede Übersetzung gleichzeitig durch 22 KI-Modelle laufen (darunter Grok und ChatGPT) und führt anschließend eine Konsensprüfung durch: Ausgewählt wird die Übersetzung, auf die sich die Mehrheit der Modelle einigt. Da Übersetzungshalluzinationen modellspezifisch sind, filtert eine modellübergreifende Übereinstimmung diese strukturell heraus.
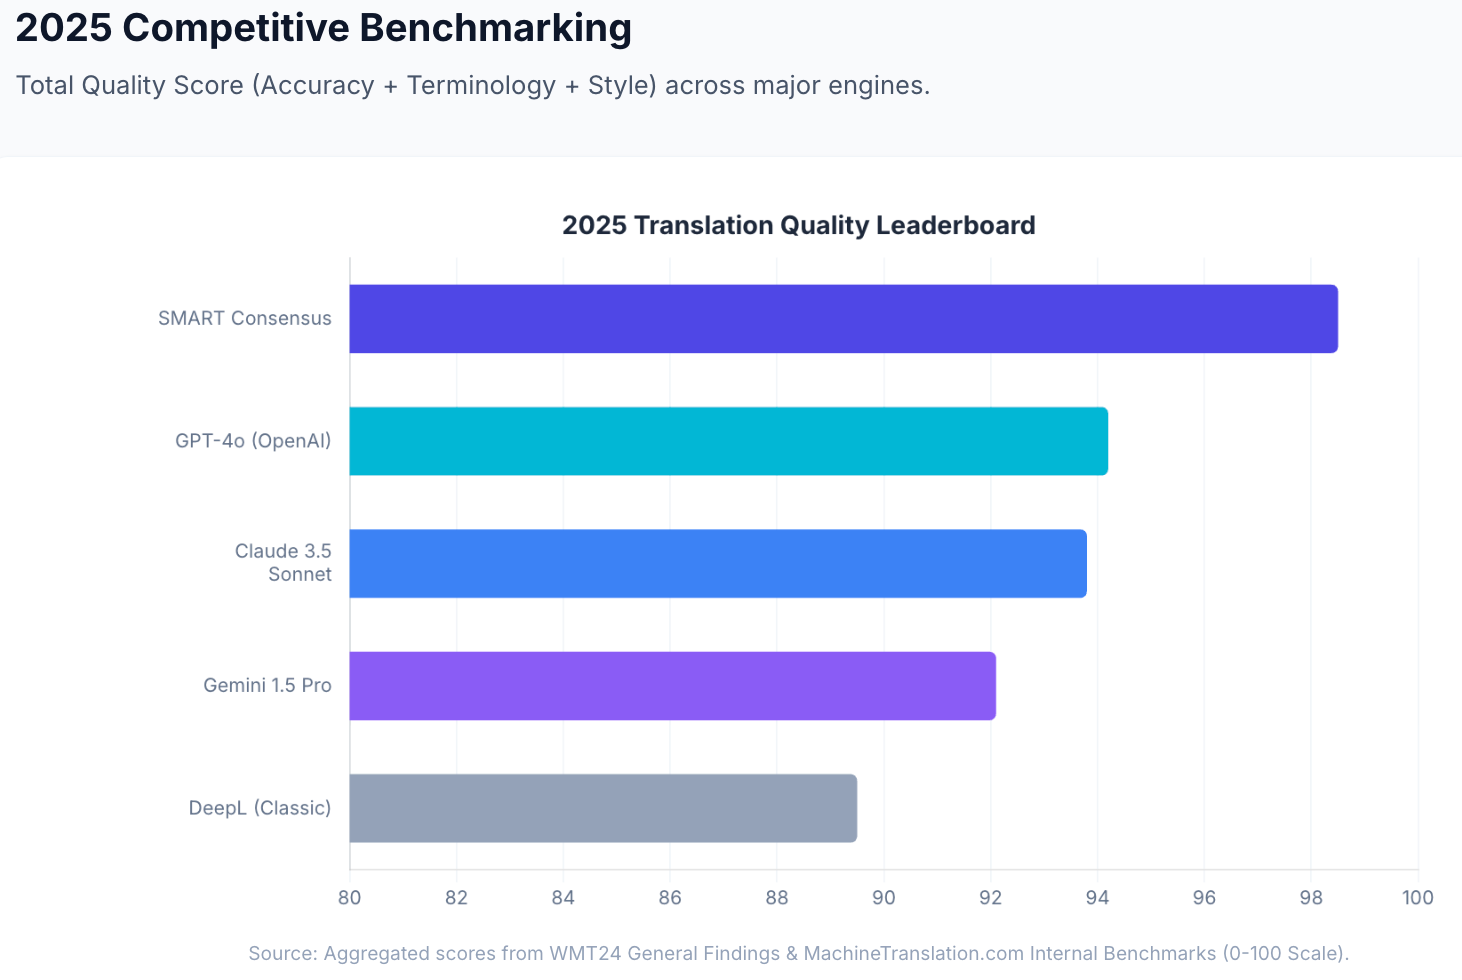
Interne Benchmarks zeigen, dass der SMART-Konsensansatz einen aggregierten Qualitätswert von 98,5 von 100 erreicht (im Vergleich zu GPT-4o mit 94,2 im selben Benchmark-Set) und das Risiko kritischer Übersetzungsfehler um 90 % reduziert. Übersetzungen, die mit SMART durchgeführt werden, reduzieren kritische Fehler auf unter 2 %, verglichen mit der Halluzinationsrate von 10–18 % bei Einzelmodell-LLMs, einschließlich Grok und ChatGPT. (Quelle: Interne Berichte von MachineTranslation.com; Intento State of Translation Automation 2025; WMT24-Erkenntnisse zur allgemeinen maschinellen Übersetzung.)
Für Übersetzungen, die absolute Sicherheit erfordern (rechtliche Schriftsätze, klinische Dokumentation, behördliche Einreichungen), steht eine menschliche Überprüfung auf derselben Plattform zur Verfügung. Keine externe Agentur. 100 % Genauigkeit garantiert.
Beginnen Sie mit dem Übersetzen auf MachineTranslation.com — kostenlos, keine Anmeldung erforderlich. Führen Sie Grok, ChatGPT und 20 andere KI-Modelle gleichzeitig aus und erhalten Sie die Übersetzung, auf die sie sich einigen.
FAQs
1. Ist Grok besser als ChatGPT für Übersetzungen?
Keines von beiden ist bei allen Übersetzungsaufgaben definitiv besser. Grok 4.1 hat aufgrund seiner Echtzeit-Web- und X-Datenintegration einen spezifischen Vorteil bei der Übersetzung von Inhalten zu aktuellen Ereignissen und Materialien mit sich neu entwickelnder Terminologie. ChatGPT (GPT-5.4) ist führend bei Benchmarks für strukturierte Genauigkeit und ist stärker bei technischen, wissenschaftlichen und juristischen Texten. Beide teilen dieselbe grundlegende Einschränkung: Als Einzelmodellsysteme kann keines von beiden seine eigene Ausgabe überprüfen.
2. Kann Grok Dokumente übersetzen?
Grok kann eingefügten Text und, je nach Plan, hochgeladene Dokumente übersetzen. Es ist jedoch kein dediziertes Übersetzungstool und bietet keine Funktionen wie die Beibehaltung des Originallayouts, die Bewertung der Übersetzungsqualität oder eine modellübergreifende Verifizierung. Für die Dokumentenübersetzung unter Beibehaltung des Layouts unterstützt MachineTranslation.com Dateien bis zu 30 MB in den Formaten PDF, DOCX, TXT, CSV, XLSX und Bildformaten.
3. Wie genau ist ChatGPT bei Übersetzungen im Jahr 2026?
Im internen Benchmark von MachineTranslation.com über 5.000 Wörter aus gemischten technischen und Marketing-Inhalten erzielte ChatGPT eine Genauigkeit von 89,8 % — stark, aber es halluzinierte im selben Test Inhalte in zwei Sätzen. Bei Benchmarks für wissenschaftliches Denken (GPQA Diamond) erzielt GPT-5.4 92,0 %. Wie bei allen Single-Modell-LLMs treten ChatGPT-Halluzinationen bei Übersetzungsaufgaben laut den Erkenntnissen von Intento State of Translation Automation 2025 und WMT24 mit einer Rate von 10–18 % auf.
4. Wie hoch sind die Preise für Grok im Jahr 2026?
Grok ist für Verbraucher über X Premium+ ($22/month) or SuperGrok ($30/Monat) zugänglich. Die xAI-API (Grok 4.1) liegt preislich bei $0.20 per 1 million input tokens and $0,50 pro 1 Million Ausgabe-Token, einer der niedrigsten API-Tarife unter den großen LLMs.
5. Nutzt MachineTranslation.com Grok und ChatGPT?
Ja. Sowohl Grok als auch ChatGPT gehören zu den 22 KI-Modellen, die MachineTranslation.com gleichzeitig über sein SMART-System laufen lässt. Anstatt sich auf eines der beiden Tools allein zu verlassen, wählt SMART die Übersetzung aus, auf die sich die Mehrheit von 22 Modellen einigt – und erfasst so die Stärken der einzelnen Modelle, während modellspezifische Fehler herausgefiltert werden. Die vollständige Liste der Modelle umfasst ChatGPT, Claude, Gemini, DeepL, Google, Grok und 16 weitere.
6. Welches KI-Tool ist besser für juristische oder medizinische Übersetzungen?
Für regulierte Inhalte reicht weder Grok noch ChatGPT allein aus — beide produzieren bei Übersetzungsaufgaben Halluzinationen mit einer Rate von 10–18 %, was ein direktes Haftungsrisiko für juristische und medizinische Dokumente darstellt. Der SMART-Konsens von MachineTranslation.com reduziert diese Fehlerquote auf unter 2 %, und auf derselben Plattform ist eine menschliche Überprüfung mit einer 100%igen Genauigkeitsgarantie für Inhalte verfügbar, die dies erfordern.
Übersetzen Sie gleichzeitig mit Grok, ChatGPT und 20 weiteren KI-Modellen auf MachineTranslation.com – kostenlos, keine Registrierung erforderlich.