August 5, 2026
Grok vs. Claude für Übersetzungen: Was die Benchmarks zeigen (2026)
Grok (xAI) und Claude (Anthropic) sind beide leistungsfähige KI-Übersetzungstools, aber sie haben strukturell unterschiedliche Stärken. Für die meisten allgemeinen Übersetzungsaufgaben werden Sie keinen wesentlichen Unterschied zwischen ihnen bemerken. Für zwei spezifische Szenarien (das Übersetzen von Inhalten über aktuelle Ereignisse und das Übersetzen formeller Dokumente, die Präzision erfordern) ist der Unterschied real und darin begründet, wie das jeweilige Modell entwickelt wurde.
Dieser Artikel befasst sich damit, was jedes Modell tatsächlich für die Übersetzung bietet, wo unabhängige Benchmarks sie einordnen und was zu tun ist, wenn die Ausgabe eines der beiden Modelle allein nicht ausreicht.
Wie schneiden Grok und Claude bei der Übersetzungsqualität im Vergleich ab?
Die kurze Antwort: Claude ist führend bei unabhängigen professionellen Übersetzungs-Benchmarks. Der spezifische Vorteil von Grok ist der Echtzeit-Wissenszugriff, nicht die allgemeine Übersetzungsqualität.
In den internen Benchmarks von MachineTranslation.com erzielt Claude (3.5 Sonnet-Stufe) 93.8 von 100 Punkten bei der Übersetzungsqualität — Genauigkeit, Terminologie und Stil kombiniert. Grok erscheint nicht unter den Top-14-Lösungen in Intento's State of Translation Automation 2025, der 46 MT-Engines und LLMs über 11 Sprachpaare hinweg bewertete. Claude Opus 4 und Claude Sonnet 3.7 erscheinen beide in den Top 14. Quelle: MachineTranslation.com interne Benchmarks; Intento State of Translation Automation 2025.
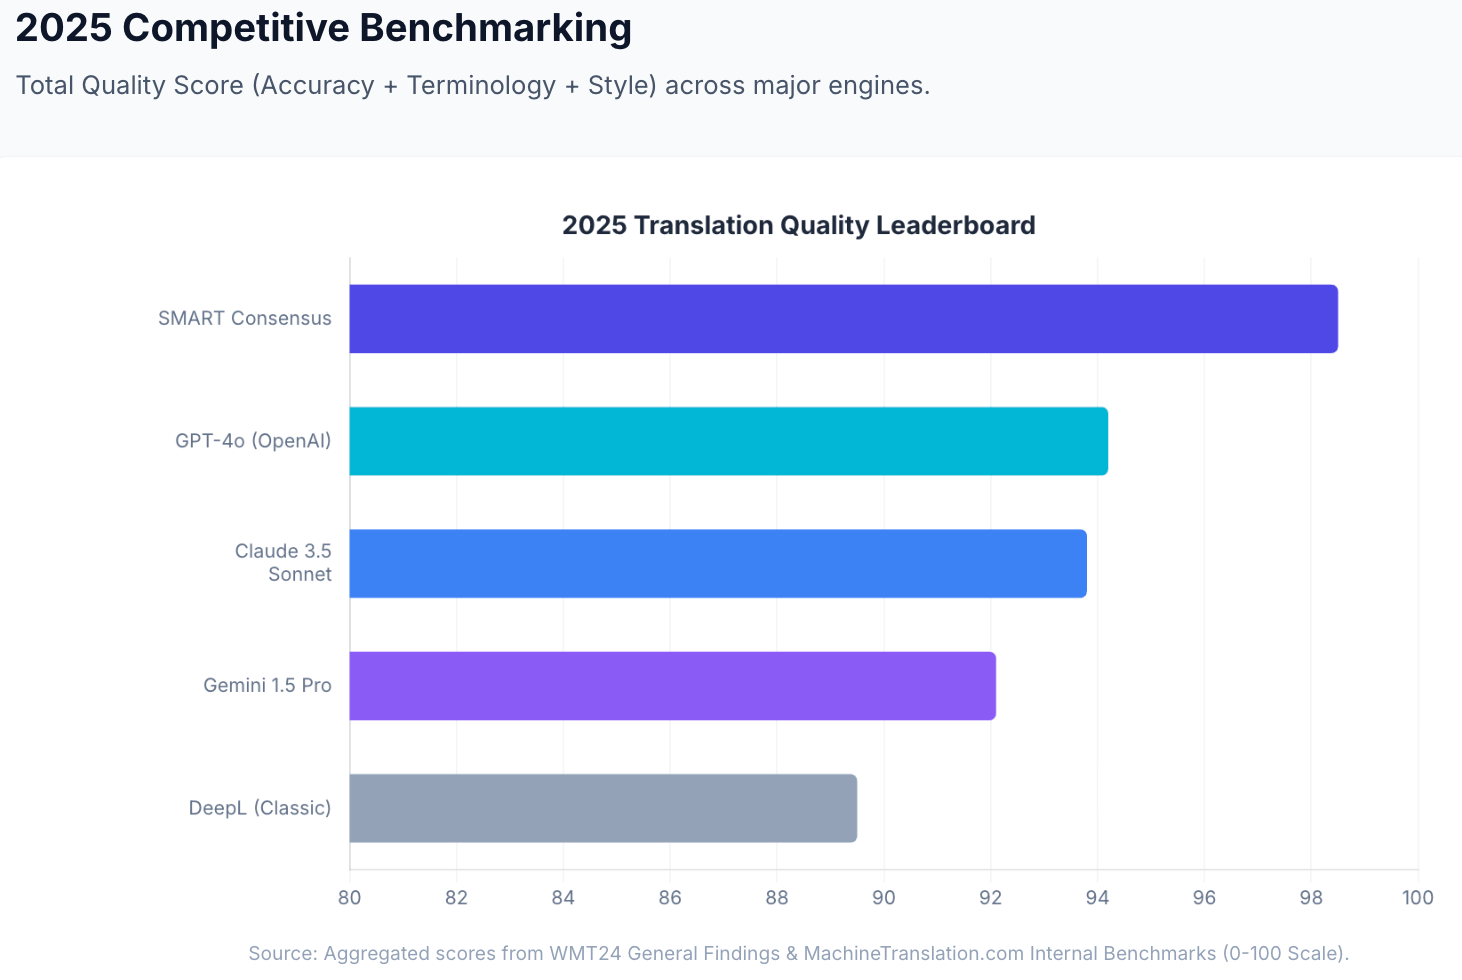
Bei WMT24 (dem wichtigsten unabhängigen Benchmark-Wettbewerb der Übersetzungsbranche) belegte Claude 3.5 den ersten Platz in 9 von 11 Sprachpaaren, vor GPT-4 und dedizierten neuronalen MT-Engines. In Lokalises Blindstudie von 2025 durch professionelle Übersetzer wurden 78 % der Übersetzungen von Claude 3.5 als „gut“ bewertet — der höchste Wert aller getesteten LLMs.
Grok wurde in WMT24 oder der unabhängigen LQA-Evaluierung von Intento nicht auf einem vergleichbaren Niveau bewertet. Der Slator Pro Guide (2025) führt Grok neben GPT und Claude als eines der Allzweck-LLMs auf, die für Übersetzungen in professionellen Umgebungen eingesetzt werden, ordnet es jedoch nicht höher als eines von beiden ein.
| Benchmark | Grok | Claude |
|---|---|---|
| interner Qualitätsscore von MachineTranslation.com | Auf Benchmark-Ebene nicht gemessen | 93.8/100 (3.5 Sonnet-Stufe) |
| Intento 2025 Top-14-Lösungen | Nicht aufgeführt | Claude Opus 4, Sonnet 3.7 beide aufgeführt |
| WMT24-Sprachpaare | Nicht bewertet | Platz 1 in 9/11 Sprachpaaren |
| Lokalise 2025 Blindstudie | Nicht bewertet | 78% „gut“ (höchster Wert aller LLMs) |
Quelle: MachineTranslation.com interne Benchmarks; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Wo hat Grok einen echten Vorteil?
Echtzeit-Übersetzung und die Übersetzung aktueller Ereignisse. Das definierende architektonische Merkmal von Grok ist seine Integration mit den Plattformdaten von X (ehemals Twitter) und der Live-Internetsuche. Im Gegensatz zu Claude und den meisten anderen LLMs, die auf statischen Datensätzen mit festen Wissensstichtagen trainiert sind, integriert Grok Echtzeitinformationen in seine Ausgaben. Für Übersetzungsaufgaben, die jüngste Ereignisse, neu erschienene Produkte, aufkommende politische Terminologie, aktuelle Nachrichten oder Inhalte betreffen, die sich auf Ereignisse der letzten Wochen beziehen, hat Grok Zugriff auf Kontext, den Claude nicht hat.
Dies ist insbesondere wichtig für: das Übersetzen von Nachrichtenartikeln über jüngste Ereignisse, das Lokalisieren von Produktankündigungen für schnelllebige Märkte, den Umgang mit neu geprägter Terminologie oder Slang, der nach den Trainingsdaten anderer Modelle entstanden ist, und alle Inhalte, deren Bedeutung davon abhängt, zu wissen, was kürzlich passiert ist.
Aufkommende und sich entwickelnde Terminologie. Technische Fachgebiete, Branchen und kulturelle Kontexte bringen kontinuierlich neue Terminologie hervor. Für Übersetzungsaufgaben, die kürzlich geprägte Begriffe, neue regulatorische Sprache oder neue Produktnomenklatur betreffen, geben Groks aktualisiertes Training und seine Echtzeitsuche ihm Zugriff auf Verwendungsmuster, die ältere Snapshots von Trainingsdaten nicht erfassen.
Grok 4.1 Kontextfenster und logisches Denken. Grok 4.1 (Stand Ende 2025) verfügt über ein Kontextfenster von 131K Token und verbesserte logische Denkfähigkeiten, wodurch es sich für komplexe, vielschichtige Dokumente eignet, bei denen Beziehungen zwischen Klauseln und logische Kohärenz von Bedeutung sind.
Wo hat Claude einen echten Vorteil?
Übersetzungsqualität bei unabhängigen Benchmarks. Claudes Vorteil wird durch eine unabhängige professionelle Evaluierung dokumentiert und nicht durch selbstberichtete Behauptungen. WMT24 platzierte Claude 3.5 in 9 von 11 Sprachpaaren auf Platz eins gegenüber dem gesamten Wettbewerbsfeld. Die Blindstudie von Lokalise aus dem Jahr 2025 ergab, dass professionelle Übersetzer den Output von Claude 3.5 mit einer „Gut“-Quote von 78% bevorzugten — höher als GPT-4, DeepL und Google Translate in derselben Bewertung. Dies sind Blindbewertungen: Professionelle Übersetzer bewerteten den Output, ohne zu wissen, welches Modell ihn generiert hat.
Spezifische Sprachpaare gemäß Intento 2025. Claude Opus 4 und Sonnet 3.7 erscheinen in der Kategorie „best“ für Englisch nach Deutsch, Englisch nach Japanisch, Englisch nach Italienisch, Englisch nach Koreanisch, Englisch nach Niederländisch, Englisch nach Arabisch und Englisch nach Französisch in der menschlichen LQA-Evaluierung von Intento. Für diese Paare ist Claude die stärkere dokumentierte Wahl von beiden.
Präzision im Tonfall und nuancierte Inhalte. Professionelle Übersetzer in der Lokalise-Studie bevorzugten den Output von Claude am häufigsten von allen LLMs — was Claudes dokumentierte Stärke bei der Bewahrung von Register, Autorenstimme und kontextueller Bedeutung widerspiegelt. Für literarische Übersetzungen, juristische Dokumente, formelle Kommunikation und Marketingtexte, bei denen es ebenso sehr darauf ankommt, wie etwas gesagt wird, wie auf das, was gesagt wird, schneidet Claude in unabhängigen Bewertungen durchweg gut ab.
Kohärenz bei langen Dokumenten. Claude 4.6 Sonnet unterstützt ein 200K-Token-Kontextfenster, wobei Claude Opus 4.6 in der Beta 1M Token unterstützt. Für lange formelle Dokumente (Verträge, technische Handbücher, Berichte über klinische Studien) kann Claude das gesamte Dokument in einem einzigen Durchgang verarbeiten und dabei die terminologische Konsistenz durchgehend beibehalten. In Fragmenten verarbeitete Dokumente weisen im Vergleich zur Verarbeitung ganzer Dokumente eine um 28 % höhere Rate an Terminologieinkonsistenz auf. Quelle: MachineTranslation.com interne Daten.
Wie schneiden sie bei Sprachunterstützung und Preisen ab?
Sprachunterstützung: Sowohl Grok 4.1 als auch Claude 4.6 unterstützen die Übersetzung in den meisten wichtigen Weltsprachen. Claude wurde unabhängig über europäische und ostasiatische Sprachpaare hinweg mit starken Ergebnissen evaluiert. Groks mehrsprachige Unterstützung hat sich über aufeinanderfolgende Versionen hinweg verbessert. Bei ressourcenarmen Sprachen nimmt die Qualität beider Modelle ab – eine menschliche Überprüfung ist für Inhalte in ressourcenarmen Sprachpaaren unabhängig vom verwendeten Modell angemessen.
Preise:
| Tarif | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Endnutzer (monatlich) | SuperGrok: $30/Monat | Claude Pro: $20/Monat |
| API-Eingabe (pro Mio. Token) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| API-Ausgabe (pro Mio. Token) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Kostenloser Tarif | Ja (ratenbegrenzt über X/Grok.com) | Ja (ratenbegrenzt über claude.ai) |
Im Endnutzer-Tarif liegt Claude Pro bei ($20/month) is cheaper than SuperGrok ($30/Monat). Auf API-Ebene hat Grok 4.1 einen leichten Kostenvorteil gegenüber Claude Sonnet 4.6 bei eingabeintensiven Übersetzungsworkflows.
Welches ist besser für bestimmte Inhaltstypen?
| Inhaltstyp | Empfohlenes Modell | Grund |
|---|---|---|
| Aktuelle Nachrichten / aktuelle Ereignisse | Grok | Echtzeit-Datenzugriff; statisch trainierten Modellen fehlt der aktuelle Kontext |
| Neue Terminologie / neue Produkteinführungen | Grok | Live-Suche-Integration erfasst aktuelle Nutzungsmuster |
| Formelle Rechtsdokumente | Claude | Unabhängige Bewertung von WMT24 und Lokalise 2025; Tonalitätspräzision |
| Medizinische / klinische Inhalte | Claude | Hervorragendes Abschneiden bei unabhängigen Benchmarks; Wahrung des Registers |
| Marketingtexte / kreative Inhalte | Claude | Präferenz in der Lokalise 2025 Blindstudie; tonale Nuancen |
| Technische Dokumentation (lang) | Claude | 200K-1M Kontextfenster; Konsistenz der Terminologie über die gesamte Länge |
| Social Media / Konversationsinhalte | Beide | Beide kommen gut mit ressourcenreichen Konversationspaaren zurecht |
| Entwickler- / API-Integration | Beide | Beide bieten API-Zugriff; Grok ist bei Input-Token etwas günstiger |
Was man nutzt, wenn ein Modell nicht ausreicht
Sowohl Grok als auch Claude sind Einzelmodell-Tools. Jedes einzelne KI-Modell (unabhängig davon, wie leistungsfähig es ist) erzeugt Fehler, die es in seiner eigenen Ausgabe nicht erkennen kann. Eine flüssige, souveräne Übersetzung von Grok oder Claude kann dennoch semantisch falsch sein, und ohne eine Gegenprüfung gibt es keine Möglichkeit, dies zu wissen.
Sowohl Grok als auch Claude gehören zu den 22 Modellen im SMART-System von MachineTranslation.com. SMART führt alle 22 Modelle gleichzeitig aus (einschließlich Grok und Claude) und gibt die Ausgabe zurück, auf die sich die Mehrheit einigt.
Was dies für die Frage Grok vs. Claude bedeutet: Groks Echtzeitstärke und Claudes kontextuelle Tiefe tragen beide zum selben Konsens bei. Wenn sie übereinstimmen, ist diese Übereinstimmung ein starkes Qualitätssignal.
In den internen Benchmarks von MachineTranslation.com erreichen einzelne Spitzenmodelle 93-94 von 100 Punkten bei der Übersetzungsqualität. SMARTs Konsens-Output erreicht 98.5/100. Quelle: Interne Benchmarks von MachineTranslation.com und WMT24 General Machine Translation Findings.
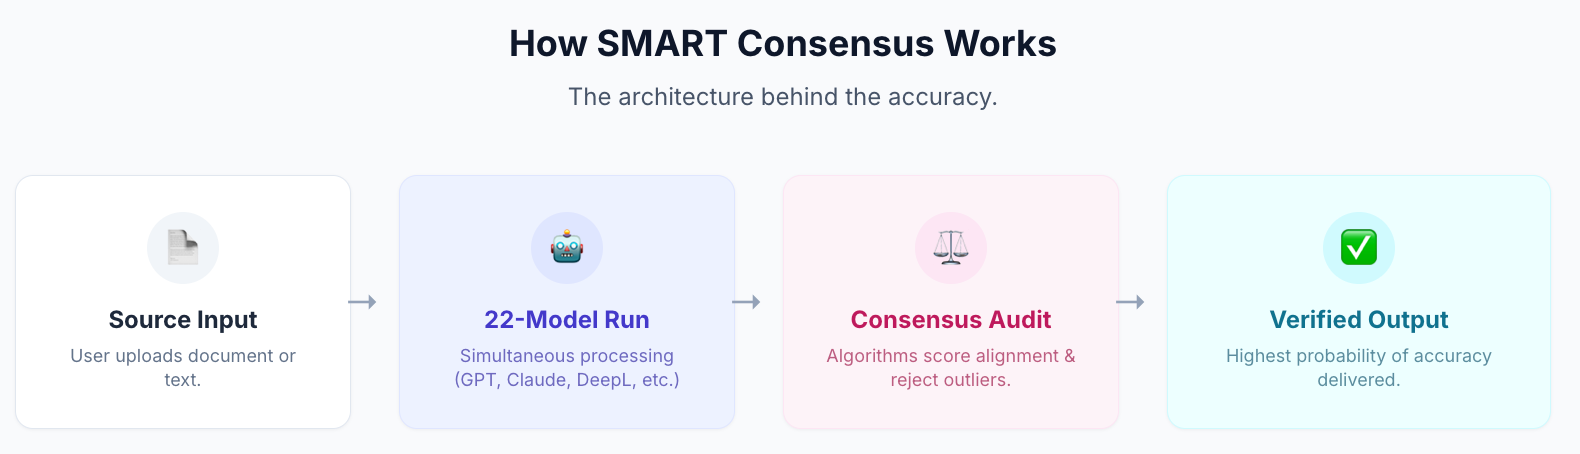
Nutzer, die von der Single-Engine-Übersetzung auf SMART umgestiegen sind, verbrachten 27 % weniger Zeit mit der Überprüfung und Korrektur der Ausgaben. Quelle: MachineTranslation.com interne Daten.
Für hochriskante Inhalte (rechtliche Dokumente, behördliche Einreichungen, medizinische Anweisungen) leitet Human Verification den SMART-Konsens an einen zertifizierten professionellen Prüfer innerhalb derselben Plattform weiter. Keine externe Agentur. 100% Genauigkeit garantiert.
Übersetzen Sie mit Grok, Claude und 20 weiteren Modellen auf MachineTranslation.com — kostenlos, keine Registrierung erforderlich.
Häufig gestellte Fragen
1. Ist Grok besser als Claude für Übersetzungen?
Bei den meisten Standard-Übersetzungsaufgaben liegt Claude bei unabhängigen Benchmarks vorn: Erster bei 9 von 11 Sprachpaaren beim WMT24, eine Bewertung von 78% als „gut“ in der Blindstudie von Lokalise aus dem Jahr 2025 und 93.8/100 in den internen Qualitätsbenchmarks von MachineTranslation.com. Groks spezifischer Vorteil liegt bei Inhalten, die Wissen über aktuelle Ereignisse erfordern, sein Echtzeit-Datenzugriff verleiht ihm einen Kontext, den statisch trainierte Modelle einschließlich Claude nicht haben. Für aktuelle Nachrichten, aufkommende Terminologie und zeitkritische Inhalte ist Grok die stärkere Wahl.
2. Was ist Groks Vorteil gegenüber Claude bei der Übersetzung?
Grok integriert Echtzeitdaten von X (ehemals Twitter) und die Live-Internetsuche. Im Gegensatz zu Claude und den meisten anderen LLMs, die auf statischen Datensätzen trainiert wurden, kann Grok bei der Generierung von Übersetzungen auf Informationen über aktuelle Ereignisse, neu geprägte Terminologie und den aktuellen Kontext zugreifen. Dies macht es besonders stark bei der Übersetzung von Nachrichteninhalten, kürzlich veröffentlichten Produkten und jeglichem Material, bei dem die Bedeutung von Ereignissen oder Sprachmustern der letzten Wochen abhängt.
3. Was ist Claudes Vorteil gegenüber Grok bei Übersetzungen?
Claudes Vorteil ist durch eine unabhängige professionelle Bewertung dokumentiert. Claude 3.5 belegte bei WMT24 den ersten Platz in 9 von 11 Sprachpaaren, und professionelle Übersetzer in Lokalises Blindstudie von 2025 bevorzugten seine Ausgabe mit einer „Gut“-Quote von 78 % — der höchste Wert aller getesteten LLMs. Claude erscheint auch in den Top-14-Lösungen von Intento über mehrere Sprachpaare hinweg in der menschlichen LQA-Evaluierung, während dies bei Grok nicht der Fall ist. Für formelle, professionelle und kritische Übersetzungsaufgaben ist Claudes unabhängiger Benchmark-Status das dokumentierte Differenzierungsmerkmal.
4. Was ist besser für juristische Übersetzungen, Grok oder Claude?
Claude ist basierend auf einer unabhängigen Bewertung die stärkere Wahl für juristische Übersetzungen. Claude 3.5 belegte bei den meisten ressourcenreichen europäischen Sprachpaaren bei der WMT24 den ersten Platz und erhielt die höchsten Präferenzbewertungen in Blindstudien von professionellen Übersetzern. Für rechtliche Inhalte, die eine zertifizierte Genauigkeit erfordern, ist keines der Modelle allein ausreichend – die Human Verification von MachineTranslation.com bietet 100 % Genauigkeit durch einen zertifizierten professionellen Prüfer auf derselben Plattform, ohne dass ein externer Anbieter erforderlich ist.
5. Sind sowohl Grok als auch Claude auf MachineTranslation.com verfügbar?
Ja. Beide gehören zu den 22 Modellen im SMART-System von MachineTranslation.com. Jede SMART-Übersetzung führt Grok, Claude und 20 andere Modelle gleichzeitig aus und gibt die Ausgabe zurück, auf die sich die Mehrheit einigt. Anstatt zwischen ihnen zu wählen, erhalten Sie den Konsens aller KI-Modelle.
6. Wie schneiden Grok und Claude im Preisvergleich ab?
Für Endverbraucher kostet Claude Pro $20/month versus SuperGrok at $30/Monat. Auf API-Ebene ist Grok 4.1 bei den Input-Tokens ($2/M vs. $3/M für Claude Sonnet 4.6) und beim Output ($10/M vs. $15/M) etwas günstiger. Der kostenlose Tarif von MachineTranslation.com enthält beide Modelle als Teil des 22-Modelle-Konsenses von SMART, keine Registrierung erforderlich.
7. Welches KI-Modell eignet sich am besten für die Übersetzung von Nachrichtenartikeln?
Für die Übersetzung von Nachrichtenartikeln hat Grok einen strukturellen Vorteil: Seine Echtzeit-Datenintegration bedeutet, dass es über aktuellen Kontext zu den beschriebenen Ereignissen verfügt, der statisch trainierten Modellen fehlen kann. Für die allgemeine Nachrichtenübersetzung, bei der Aktualität nicht kritisch ist, ist die Benchmark-Leistung von Claude stärker. Für hochvolumige Nachrichtenübersetzungen, bei denen sowohl Aktualität als auch Genauigkeit wichtig sind, führt SMART von MachineTranslation.com beide Modelle aus und liefert deren Konsensergebnis zurück.