October 9, 2026
Qwen vs. ChatGPT: Welches KI-Modell übersetzt besser?
ChatGPTs aktuelle Generation und Qwen gehören beide zum Modell-Pool, den MachineTranslation.com bei jeder Übersetzung nutzt, und sind keine zwei externen Herausforderer, die gegen die Plattform selbst bewertet werden. Lässt man denselben Text bei identischen Segmenten durch beide laufen, gewinnt ChatGPT insgesamt bei dem größeren Anteil der Sprachpaare. Teilt man die Ergebnisse nach Richtung auf, verengt sich das Bild an einer bestimmten Stelle deutlich: bei Übersetzungen ins Englische, wo beide nahezu gleichauf liegen.
Gibt es eine KI, die beim Übersetzen besser ist als ChatGPT?
Das allgemeine Interesse an Alternativen zu ChatGPT ist mit der Verbesserung konkurrierender Modelle gewachsen, auch wenn die Gründe je nach Anwendungsfall stark variieren und es keine einzelne Erklärung gibt. Speziell beim Übersetzen ist die nützlichere Frage, welches Modell bei einem bestimmten Sprachpaar tatsächlich besser abschneidet – eine überprüfbare Frage statt einer reinen Gefühlssache.
Über den Traffic der letzten 28 Tage von MachineTranslation.com hinweg übersetzten beide Modelle identischen Quelltext über 98 Sprachpaare hinweg. ChatGPT erzielte bei 77 dieser Paare eine höhere Punktzahl; Qwen schnitt bei 21 besser ab. Der gewichtete Durchschnitt über die verglichenen Ausgaben hinweg bringt ChatGPT auf 9.10 von 10 Punkten und Qwen auf 8.98 – ein realer, aber im Durchschnitt moderater Abstand, der eine weitaus deutlichere Kluft verbirgt, sobald die Übersetzungsrichtung berücksichtigt wird.
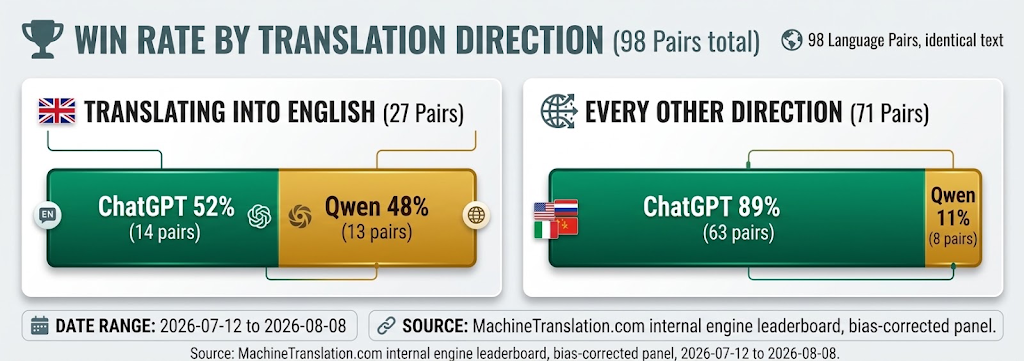
Ins Englische liegen die beiden Modelle nahezu gleichauf. In jeder anderen Richtung gewinnt ChatGPT die große Mehrheit der getesteten Paare.
| ChatGPT | Qwen | |
|---|---|---|
| Prozentsatz der bewerteten Ausgaben | 54.76% | 42.6% |
| Durchschnittliche Punktzahl | 8.89 / 10 | 8.87 / 10 |
| Untere 10 % der Bewertungen | 7.8 | 7.6 |
| Gewinnrate, ins Englische | 52% | 48% |
| Gewinnrate, alle anderen Richtungen | 89% | 11% |
Warum verschwindet der Abstand bei Übersetzungen ins Englische nahezu?
Die Daten zeigen, wo der Unterschied auftritt, nicht warum. Klar ist, dass die Wettbewerbsfähigkeit von Qwen nicht gleichmäßig verteilt ist. Von 27 Paaren, bei denen die Zielsprache Englisch ist, gewinnt Qwen 13 – im Grunde ein Münzwurf. Von den verbleibenden 71 Paaren, sowohl bei Übersetzungen aus dem Englischen als auch zwischen zwei nicht-englischen Sprachen, gewinnt ChatGPT 63 oder 89% davon. Ein Team, das davon ausgeht, dass sich Qwens Leistung bei Übersetzungen ins Englische auf ausgehende Übersetzungen oder nicht-englische Sprachpaare übertragen lässt, würde die falsche Lehre aus der falschen Richtung ziehen.
Ist Qwen ein chinesisches Unternehmen, und spielt das für Übersetzungen eine Rolle?
Qwen wird von Alibaba Cloud mit Sitz in China entwickelt. Für sich genommen ändert das nichts daran, wie gut das Modell einen bestimmten Satz übersetzt; die obigen Daten spiegeln die tatsächliche Ausgabequalität wider, unabhängig davon, wo ein Modell entwickelt wird. Wo es jedoch eine Rolle spielen kann, ist der Umgang mit Daten: Unternehmen, die regulierte oder sensible Inhalte übersetzen (Verträge, Krankenakten, personenbezogene Daten), sollten die Frage, wo ein KI-Anbieter diese Inhalte verarbeitet und speichert, als echten Due-Diligence-Punkt betrachten – unabhängig von der Übersetzungsqualität selbst. Das gilt für jeden KI-Anbieter, nicht speziell für Qwen, und ist einer der Gründe, warum MachineTranslation.com seine eigenen Praktiken zur Datenverarbeitung und Sicherheit direkt veröffentlicht, anstatt die Frage unbeantwortet zu lassen.
Ist eines der beiden Modelle zuverlässiger für juristische und geschäftliche Übersetzungen?
Nicht durchgängig, und die Abweichung hängt nicht immer davon ab, welches Modell besser abschneidet. Die Tests von MachineTranslation.com anhand realer Vertragssprache ergaben zwei separate Fälle, die man kennen sollte, bevor man einem der beiden Modelle bei juristischen Texten vertraut. Bei idiomatischer Sprache verhält es sich mitunter genau umgekehrt: Ein separater direkter Vergleich ergab, dass ChatGPT eine deutsche Redewendung wörtlich und falsch übersetzte, während Qwen die korrekte idiomatische Bedeutung fand – eine Erinnerung daran, dass der Gesamtvorsprung keines der beiden Modelle in den aggregierten Daten Satz für Satz zutrifft.
| Testfall | ChatGPT | Qwen |
|---|---|---|
| "At-will employment" ins Deutsche | Brauchbare, funktionale Formulierung | Griff auf ein nicht verwandtes Rechtskonzept zurück |
| Haftungsbeschränkungsklausel ins Spanische | "que surjan de" | "derivados de" (den Geltungsbereich verändernder Unterschied) |
| "Ich verstehe nur Bahnhof" (deutsche Redewendung) | Wörtlich übersetzt, fehlerhaft | Korrekte idiomatische Bedeutung |
Keines der beiden Modelle gewinnt in diesen drei Fällen durchgängig: Der aggregierte Gesamtwert eines einzelnen Modells lässt keine Vorhersage über sein Verhalten bei einem bestimmten Begriff oder einer bestimmten Formulierung zu. Dies ist auch der Grund, warum juristische und vertragliche Texte unabhängig davon, welches Modell den ersten Entwurf erstellt hat, von einer menschlichen Überprüfung profitieren.
Wie steht es um die Sprachabdeckung?
Weder ChatGPT noch Qwen veröffentlichen eine verifizierte, unabhängig bestätigte Liste von Sprachpaaren, bei denen die Übersetzungsqualität nachlässt. Beide sind Allzweckmodelle mit breitem mehrsprachigem Training – was etwas anderes ist als eine gemessene Übersetzungsleistung über eine bestimmte Gruppe von Sprachen hinweg. MachineTranslation.com testet und bewertet die Übersetzungsqualität für über 330 Sprachen direkt, anstatt sich auf die allgemeine Sprachkompetenz eines Modells als Ersatz dafür zu verlassen, wie gut es tatsächlich übersetzt.
Was sollten Sie für geschäftliche Übersetzungen nicht in ChatGPT oder Qwen einfügen?
Weder ChatGPT noch Qwen wurden als dedizierte Übersetzungsplattformen entwickelt, und das direkte Einfügen sensibler geschäftlicher Inhalte in eine universelle Chat-Benutzeroberfläche bringt dieselben Fragen zur Datenverarbeitung mit sich wie das Einfügen in jedes andere KI-Tool für Endverbraucher: wo die Eingabe verarbeitet wird, ob sie gespeichert wird und wer darauf zugreifen kann. Verträge, Krankenakten, Einwanderungsdokumente und Finanzberichte sind genau die Art von Inhalten, bei denen es sich lohnt, diese Frage vor und nicht erst nach der Übersetzung zu beantworten. Dies ist ein triftiger Grund, warum eine dedizierte Übersetzungsplattform mit veröffentlichten, überprüfbaren Datenverarbeitungspraktiken eine ganz andere Ausgangslage darstellt als eine universelle Chat-Benutzeroberfläche – unabhängig davon, welches Modell jeweils dahintersteckt.
Wie MachineTranslation.com tatsächlich beide Modelle nutzt
MachineTranslation.com führt bei jeder Übersetzung ChatGPT, Qwen und mehr als 20 weitere KI-Modelle aus und hebt dann die Version hervor, bei der diese Modelle am meisten übereinstimmen. Da die Leistung von Qwen und ChatGPT je nach Sprachrichtung so stark auseinandergeht, würde die Wahl eines einzigen Modells als fester Standard bedeuten, bei einem vorhersehbaren Anteil von Sprachpaaren falsch zu liegen. Dasselbe richtungsabhängige Muster zeigt sich auch im Vergleich von Qwen und DeepSeek durch MachineTranslation.com. Um sich ein vollständiges Bild davon zu machen, wie aktuelle Modelle gegeneinander getestet werden, werfen Sie einen Blick auf die umfassenden Modellvergleichstests von MachineTranslation.com.
Häufig gestellte Fragen
1. Ist Qwen oder ChatGPT besser für Übersetzungen?
Bei 98 Sprachpaaren, die anhand identischer Ausgangstexte getestet wurden, erzielte ChatGPT bei 77 davon eine höhere Punktzahl. Qwen zeigt seine stärkste Leistung bei Übersetzungen ins Englische, wo beide Modelle nahezu gleichauf liegen. In jeder anderen Richtung gewinnt ChatGPT die überwiegende Mehrheit der Paare, sodass die ehrliche Antwort stark davon abhängt, in welche Richtung der Inhalt übersetzt wird.
2. Unterstützt ChatGPT oder Qwen mehr Sprachen?
Beide sind Allzweck-KI-Modelle ohne eine verifizierte, veröffentlichte Liste sprachspezifischer Einschränkungen. Keines von beiden veröffentlicht unabhängig bestätigte Daten zur Sprachpaarabdeckung – im Gegensatz zu einer Plattform, die die Übersetzungsqualität für über 330 Sprachen direkt testet und bewertet, anstatt sich auf allgemeine Behauptungen über mehrsprachiges Training zu verlassen.
3. Ist Qwen oder ChatGPT besser für juristische und geschäftliche Übersetzungen?
Keines von beiden ist durchweg verlässlich besser. Beim Testen eines deutschen arbeitsrechtlichen Begriffs lieferten DeepSeek und ChatGPT brauchbare funktionale Formulierungen, während Claude und Qwen jeweils ein unpassendes Rechtskonzept heranzogen. Dies zeigt, dass die Unterschiede vom jeweiligen Begriff und Kontext abhängen und nicht davon, welches Modell allgemein stärker ist.
4. Steht MachineTranslation.com in Konkurrenz zu ChatGPT und Qwen?
Nein. MachineTranslation.com führt bei jeder Übersetzung ChatGPT, Qwen und mehr als 20 weitere KI-Modelle aus und hebt die Version hervor, bei der diese Modelle die größte Übereinstimmung aufweisen. Die Plattform testet und kombiniert Modelle wie diese, anstatt als eigenes, konkurrierendes Modell zu fungieren.
5. Welches Modell sollte ich für ein großes Lokalisierungsprojekt wählen?
Keines der beiden Modelle allein ist eine sichere Standardwahl, sobald Inhalte über viele Sprachen hinweg in beide Richtungen übersetzt werden. Die hier dokumentierte richtungsabhängige Diskrepanz bedeutet, dass ein Modell, das bei der Übersetzung ins Englische gut abschneidet, bei der Übersetzung daraus über Dutzende von Sprachpaaren gleichzeitig ganz andere Leistungen erbringen kann.
6. Welches Qwen-Modell ist am besten für Übersetzungen?
Dies ist noch nicht verfügbar. Das Tracking von MachineTranslation.com erfasst Qwen im Gegensatz zu anderen Anbietern derzeit als eine einzige Engine ohne Modellversions-Tag, sodass keine Qualitätsdaten für einzelne Unterversionen vorliegen, über die berichtet werden könnte. Sobald dies behoben ist, wird eine echte Aufschlüsselung zwischen Qwen3.8-Max und Qwen3.8-27B möglich sein; derzeit ist dies eine tatsächliche Lücke und nicht bloß ein nicht erfasstes Detail.