October 2, 2026
Qwen vs. Grok: Welches KI-Modell übersetzt besser?
Qwen und Grok sind beide Allzweck-KI-Modelle, keine übersetzungsspezifischen Tools, und beide sind Teil des Modellpools, den MachineTranslation.com bei jeder Übersetzung einsetzt. Das ist wichtig für das Verständnis des Folgenden. Dies ist ein Blick darauf, wie zwei der plattformeigenen Modelle im Vergleich zueinander abschneiden, mit den echten Vorbehalten, die mit dieser Art von Daten einhergehen, und kein Wettbewerb zwischen zwei externen Herausforderern und der Plattform selbst.
Was sind Qwen und Grok?
Qwen ist Alibabas Familie großer Sprachmodelle, die sich derzeit in der Generation Qwen3.8 befindet, und wurde als Teil der laufenden Expansion der Plattform zum Modellpool von MachineTranslation.com hinzugefügt. Grok ist die Modellreihe von xAI, die sich zum Zeitpunkt der Erstellung dieses Artikels in der Version Grok 4.7 befindet. Sie hat seit der in diesem Artikel ursprünglich verglichenen Version mehrere Releases durchlaufen und wurde der Plattform separat hinzugefügt. Keines der beiden Modelle wurde speziell für Übersetzungen entwickelt. Beide sind Allzwecksysteme, die als Teil einer umfassenderen Sprachfähigkeit auch viele Sprachen verarbeiten können, was ein anderer Ausgangspunkt ist als eine Plattform, die speziell für Übersetzungsqualität entwickelt und getestet wurde.
Wie schneiden Qwen und Grok bei den eigenen Daten von MachineTranslation.com im Vergleich ab?
In den letzten 28 Tagen des Plattform-Traffics erzielte Grok im Durchschnitt eine höhere Punktzahl als Qwen: 9.26 von 10 im Vergleich zu 8.87. Die 10 % der am schlechtesten bewerteten Übersetzungen von Grok erreichten immer noch einen Durchschnitt von 9.2, während die 10 % der am schlechtesten bewerteten Übersetzungen von Qwen auf 7.6 fielen, was einer größeren Lücke im unteren Bereich entspricht, als der Durchschnitt allein vermuten lässt.
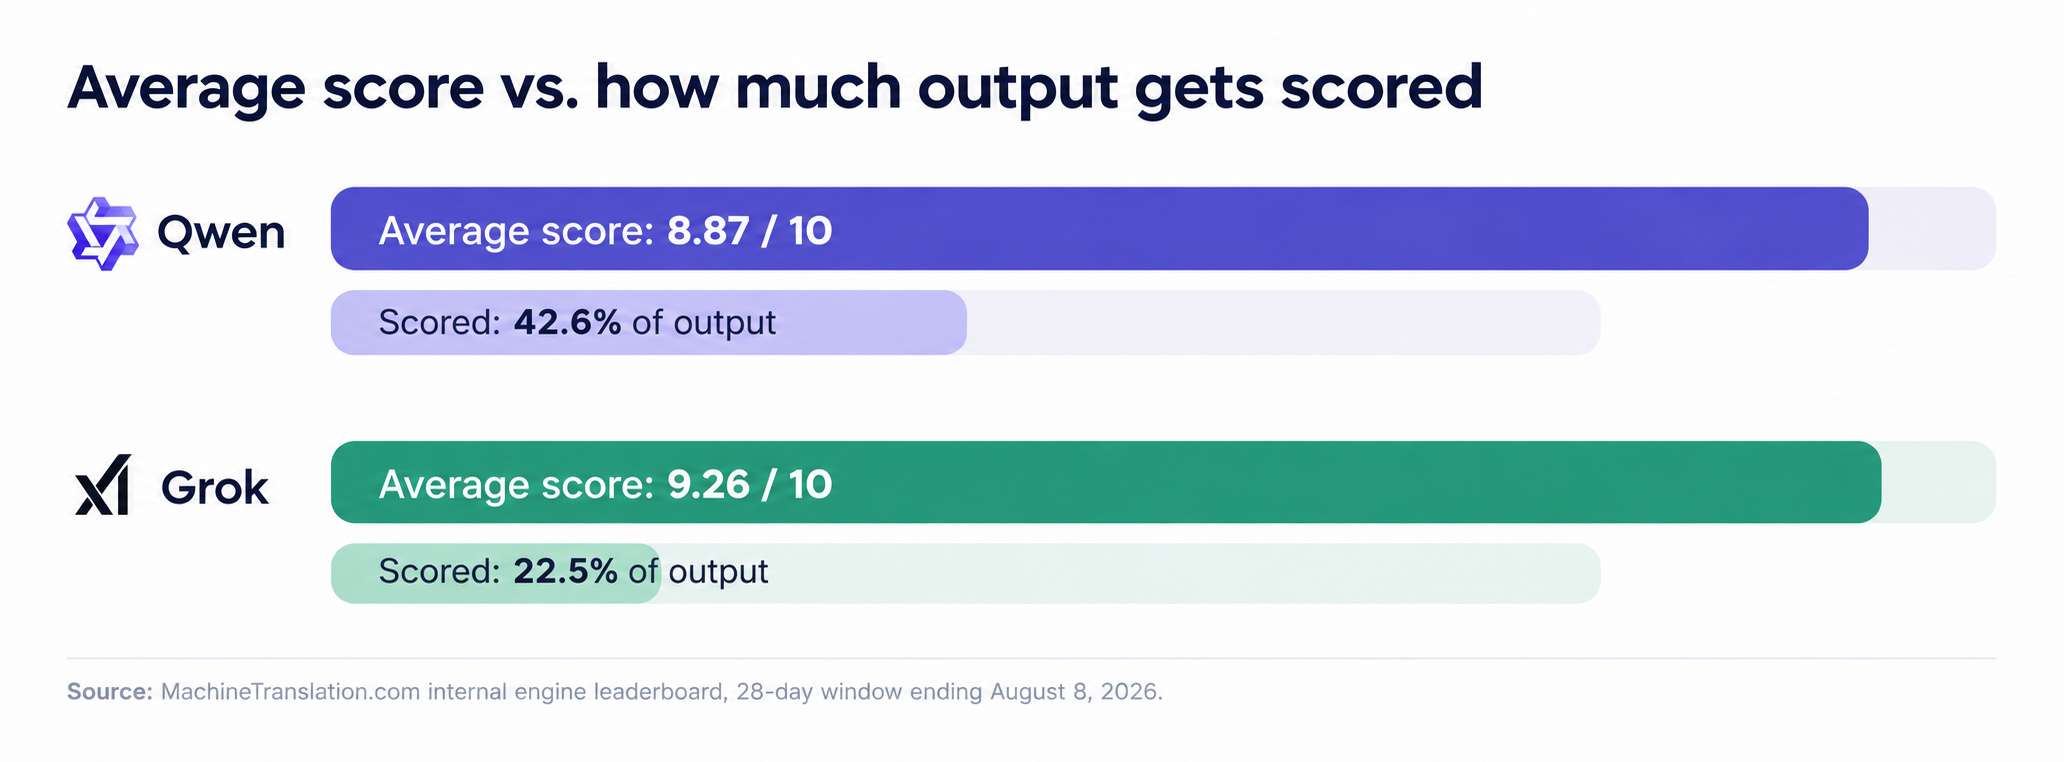
Die durchschnittliche Punktzahl von Grok ist höher, basiert jedoch darauf, dass weniger als ein Viertel seines Outputs bewertet wurde, gegenüber fast der Hälfte bei Qwen. Die beiden Balken erzählen verschiedene Teile derselben Geschichte.
| Qwen | Grok | |
|---|---|---|
| Prozentsatz des bewerteten Outputs | 42.6% | 22.5% |
| Durchschnittliche Punktzahl | 8.87 / 10 | 9.26 / 10 |
| Die schlechtesten 10 % der Bewertungen | 7.6 | 9.2 |
Quelle: Interne Engine-Rangliste von MachineTranslation.com, 28-Tage-Zeitraum endend am August 8, 2026.
Bedeutet die höhere Bewertung von Grok, dass es die bessere Wahl ist?
Für sich genommen nicht. Grok wird auf der Plattform weitaus seltener verwendet als Qwen, und weniger als ein Viertel seiner Übersetzungen wird überhaupt bewertet, verglichen mit fast der Hälfte bei Qwen. Eine kleinere, weniger repräsentative Stichprobe kann einen Durchschnitt besser oder schlechter aussehen lassen, als es bei demselben Volumen, das Qwen verzeichnet, der Fall wäre. Die eigenen Berichte von MachineTranslation.com zu diesen Daten behandeln die Bewertungsabdeckung als echte Einschränkung und nicht als Randnotiz: Eine Engine, die nur anhand eines kleinen Teils ihres Datenverkehrs bewertet wird, wurde nicht so gründlich getestet wie eine, die über fast die Hälfte ihrer Ausgabe hinweg bewertet wurde.
Die ehrliche Einschätzung ist, dass die Zahlen von Grok vielversprechend, aber weniger aussagekräftig sind. Die von Qwen sind im Durchschnitt niedriger, beruhen aber auf einer viel größeren, repräsentativeren Basis. Keine dieser Tatsachen hebt die andere auf.
Wie sieht es mit der Sprachabdeckung aus?
Weder Qwen noch Grok veröffentlichen eine verifizierte Liste von Sprachpaaren, bei denen die Leistung abfällt, und es gibt keine unabhängigen Tests, die eine solche bestätigen. Was man mit Sicherheit sagen kann, ist, dass keines der Modelle auf Übersetzungsqualität über eine bestimmte Sprachgruppe hinweg ausgelegt wurde, wie es bei einer dedizierten Übersetzungsplattform der Fall ist. MachineTranslation.com testet und unterstützt direkt über 270 Sprachen, was ein anderer Anspruch ist als die breite, aber ungetestete mehrsprachige Fähigkeit eines Allzweckmodells.
Wie MachineTranslation.com Qwen und Grok tatsächlich nutzt
MachineTranslation.com lässt Qwen, Grok und mehr als 20 andere KI-Modelle bei jeder Übersetzung laufen und präsentiert dann die Version, bei der diese Modelle am ehesten übereinstimmen. Kein Modell wird ausgeschlossen, nur weil es im Durchschnitt schlechter abschneidet. Viele Modelle gleichzeitig auszuführen bedeutet, genau die Fälle abzufangen, in denen ein im Schnitt schwächeres Modell einen bestimmten Satz dennoch richtig übersetzt, den ein im Schnitt besseres Modell verfehlt. Die Leistung von Qwen unterscheidet sich auch je nach Übersetzungsrichtung und Sprachpaarung auf eine Weise, die man kennen sollte, bevor man sich für ein einzelnes Modell entscheidet – dies wird im Vergleich Qwen vs DeepSeek von MachineTranslation.com genauer behandelt. Einen detaillierteren Blick darauf, wie Modelle direkt gegeneinander getestet werden, finden Sie in den vollständigen Modellvergleichstests von MachineTranslation.com.
Häufig gestellte Fragen
1. Ist Qwen oder Grok besser für Übersetzungen?
In den eigenen 28-Tage-Engine-Daten von MachineTranslation.com erzielt Grok im Durchschnitt eine höhere Punktzahl als Qwen, 9.26 gegenüber 8.87 von 10. Grok wird jedoch anhand eines viel kleineren, weniger repräsentativen Teils seiner Ausgaben bewertet, sodass dies kein sauberer direkter Vergleich ist, wie es ein Test mit übereinstimmenden Segmenten wäre.
2. Warum hat Grok eine höhere durchschnittliche Punktzahl, aber weniger bewertete Übersetzungen?
Grok wird auf der Plattform seltener verwendet und nur etwa 22.5% seiner Ausgaben werden bewertet, verglichen mit 42.6% bei Qwen. Eine kleinere, weniger repräsentative Stichprobe kann einen Durchschnitt künstlich erhöhen oder verringern, weshalb dieser Vergleich als richtungsweisend und nicht als endgültig betrachtet werden sollte.
3. Unterstützt Qwen oder Grok mehr Sprachen?
Beide sind universelle KI-Modelle ohne eine veröffentlichte, verifizierte Liste sprachspezifischer Einschränkungen. Keines von beiden wurde speziell für Übersetzungen entwickelt. Das unterscheidet sich von einer Plattform, die die Übersetzungsqualität direkt über 270+ Sprachen hinweg testet und bewertet, anstatt sich auf ein breites mehrsprachiges Training als Ersatz für gemessene Übersetzungsleistung zu verlassen.
4. Konkurriert MachineTranslation.com mit Qwen und Grok?
Nein. MachineTranslation.com führt bei jeder Übersetzung Qwen, Grok und mehr als 20 andere KI-Modelle aus und liefert die Version, bei der diese Modelle am ehesten übereinstimmen. Es testet und kombiniert Modelle wie diese, anstatt als eigenes, separates Modell gegen sie anzutreten.
5. Welches KI-Modell empfiehlt MachineTranslation.com für Übersetzungen?
Standardmäßig keines. Verschiedene Modelle schneiden je nach Sprachpaar und Inhaltstyp unterschiedlich ab, und der Leistungsunterschied zwischen ihnen kann je nach dem, was übersetzt wird, in beide Richtungen ausschlagen. Genau diese Variation ist der Grund, warum die Plattform bei jeder Übersetzung mehrere Modelle ausführt, anstatt eines als feste Empfehlung auszuwählen.