October 9, 2026
Qwen kontraŭ ChatGPT: Kiu AI-modelo tradukas pli bone?
La nuna generacio de ChatGPT kaj Qwen ambaŭ estas parto de la aro de modeloj, kiujn MachineTranslation.com uzas por ĉiu traduko, ne du eksteraj defiantoj juĝataj kontraŭ la platformo mem. Pasigu la saman tekston tra ambaŭ en identaj segmentoj, kaj ChatGPT gajnas la pli grandan parton de lingvoparoj ĝenerale. Disigu la rezultojn laŭ direkto, kaj la bildo draste mallarĝiĝas en unu specifa loko: tradukado en la anglan, kie la du estas preskaŭ egalaj.
Ĉu ekzistas iu AI pli bona ol ChatGPT por tradukado?
Ĝenerala intereso pri alternativoj al ChatGPT kreskis dum konkurantaj modeloj pliboniĝis, kvankam la kialoj tre varias laŭ uzkazo kaj ne ekzistas ununura klarigo. Specife por tradukado, la pli utila demando estas, kiu modelo fakte funkcias pli bone ĉe difinita lingvoparo — provebla demando prefere ol afero de persona opinio.
Dum la lastaj 28 tagoj de trafiko de MachineTranslation.com, ambaŭ modeloj tradukis identan fonttekston tra 98 lingvoparoj. ChatGPT atingis pli altan poentaron en 77 el tiuj paroj; Qwen atingis pli altan poentaron en 21. La pezita mezumo tra kongruigita eligo metas ChatGPT je 9.10 el 10 kaj Qwen je 8.98, reala sed modesta diferenco averaĝe, kiu kaŝas multe pli akran disiĝon kiam oni konsideras la direkton.
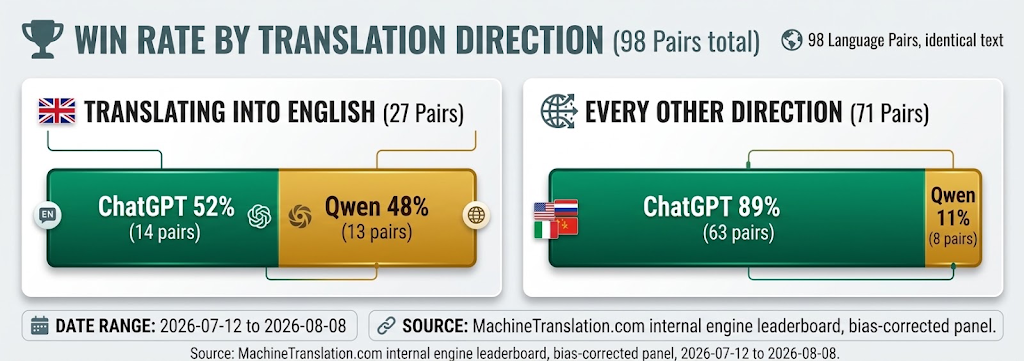
En la anglan, la du modeloj estas preskaŭ egalaj. En ĉiu alia direkto, ChatGPT gajnas la grandan plimulton de la testitaj paroj.
| ChatGPT | Qwen | |
|---|---|---|
| Elcentaĵo de eligo poentita | 54.76% | 42.6% |
| Meza poentaro | 8.89 / 10 | 8.87 / 10 |
| Plej malaltaj 10% de poentaroj | 7.8 | 7.6 |
| Venkoprocento, en la anglan | 52% | 48% |
| Venkoprocento, ĉiuj aliaj direktoj | 89% | 11% |
Kial la diferenco preskaŭ malaperas tradukante en la anglan?
La datumoj montras, kie okazas la disiĝo, ne kial. Estas klare, ke la konkurencivo de Qwen ne estas egale distribuita. El 27 paroj, en kiuj la cellingvo estas la angla, Qwen gajnas 13, esence monerĵeto. El la restantaj 71 paroj, kaj tradukante el la angla kaj inter du ne-anglaj lingvoj, ChatGPT gajnas 63, aŭ 89% el ili. Teamo supozanta, ke la rendimento de Qwen en la anglan transiĝas al tradukado el la angla aŭ inter ne-anglaj lingvoparoj, tirus la malĝustan lecionon el la malĝusta direkto.
Ĉu Qwen estas ĉina kompanio, kaj ĉu tio gravas por tradukado?
Qwen estas disvolvita de Alibaba Cloud, bazita en Ĉinio. Per si mem, tio ne ŝanĝas kiom bone la modelo tradukas donitan frazon; la supraj datumoj reflektas faktan eligokvaliton sendepende de kie modelo estas konstruita. Kie ĝi povas gravi, estas datumtraktado: entreprenoj tradukantaj reguligitan aŭ senteman enhavon (kontraktojn, medicinajn dosierojn, personajn informojn) devus trakti la demandon pri tio, kie AI-provizanto prilaboras kaj konservas tiun enhavon, kiel veran elementon de zorga kontrolo, apartan de la tradukkvalito mem. Tio validas por ajna AI-provizanto, ne specife por Qwen, kaj estas parto de la kialo, kial MachineTranslation.com publikigas siajn proprajn praktikojn pri datumtraktado kaj sekureco rekte anstataŭ lasi la demandon nerespondita.
Ĉu iu el la modeloj estas pli fidinda por jura kaj komerca tradukado?
Ne konstante, kaj la diferenco ne ĉiam temas pri tio, kiu modelo ricevas pli altan poentaron. La testado de MachineTranslation.com tra reala kontrakta lingvaĵo trovis du apartajn kazojn sciindajn antaŭ ol fidi iun ajn modelon por jura teksto. Idiomatika lingvaĵo foje iras la alian vojon: aparta rekta kompara testo trovis, ke ChatGPT tradukis germanan idiomon laŭvorte kaj malĝuste, dum Qwen trovis la ĝustan idioman signifon – memorigilo, ke la ĝenerala antaŭeco de nek unu nek la alia modelo en la agregitaj datumoj veras frazon post frazo.
| Testkazo | ChatGPT | Qwen |
|---|---|---|
| "At-will employment" en la germanan | Uzebla, funkcia frazigo | Uzis nerilatan juran koncepton |
| Klaŭzo pri limigo de respondeco en la hispanan | "que surjan de" | "derivados de" (ampleks-ŝanĝa diferenco) |
| "Ich verstehe nur Bahnhof" (germana idiomo) | Tradukita laŭvorte, malĝusta | Ĝusta idioma signifo |
Neniu el la du modeloj konstante venkas tra ĉi tiuj tri kazoj: la agregita poentaro de ununura modelo ne antaŭdiras ĝian konduton ĉe iu ajn specifa termino aŭ frazo. Tial ankaŭ jura kaj kontrakta teksto profitas de homa kontrola paŝo, sendepende de tio, kiu modelo produktis la unuan skizon.
Kio pri lingva kovrado?
Nek ChatGPT nek Qwen publikigas kontrolitan, sendepende konfirmitan liston de lingvoparoj, ĉe kiuj la tradukokvalito malkreskas. Ambaŭ estas ĝeneraluzaj modeloj kun larĝa multlingva trejnado, kio estas malsama aserto ol mezurita tradukefikeco trans specifa aro de lingvoj. MachineTranslation.com testas kaj poentas tradukokvaliton trans pli ol 330 lingvoj rekte, anstataŭ fidi la ĝeneralan lingvokapablon de modelo kiel anstataŭanton por tio, kiom bone ĝi efektive tradukas.
Kion vi ne devus alglui en ChatGPT aŭ Qwen por komerca tradukado?
Nek ChatGPT nek Qwen estis konstruitaj kiel dediĉita tradukplatformo, kaj alglui senteman komercan enhavon rekte en ĝeneraluzan babilan interfacon kunportas la samajn demandojn pri datentraktado kiel alglui ĝin en ajnan alian konsumantan AI-ilon: kie la enigo estas prilaborata, ĉu ĝi estas konservata, kaj kiu povas aliri ĝin. Kontraktoj, medicinaj registroj, enmigradaj dokumentoj kaj financaj raportoj estas ĝuste la speco de enhavo, por kiu tiun demandon indas respondi antaŭ tradukado, ne post ĝi. Ĉi tio estas vera kialo, pro kio dediĉita tradukplatformo kun publikigitaj, kontroleblaj praktikoj pri datentraktado estas tute malsama propono ol ĝeneraluza babila interfaco, sendepende de tio, kiu modelo funkcias sub ĉiu el ili.
Kiel MachineTranslation.com efektive uzas ambaŭ modelojn
MachineTranslation.com rulas ChatGPT, Qwen kaj pli ol 20 aliajn AI-modelojn por ĉiu traduko, kaj poste montras la version, pri kiu tiuj modeloj plej konsentas. Konsiderante kiom akre la efikeco de Qwen kaj ChatGPT disiĝas laŭ direkto, elekti unu modelon kiel konstantan defaŭlton signifus erari pri antaŭvidebla parto de lingvoparoj. La sama direkto-dependa ŝablono aperas en la komparo inter Qwen kaj DeepSeek de MachineTranslation.com. Por la kompleta bildo pri kiel nunaj modeloj estas testataj unu kontraŭ la alia, vidu la plenan modelan komparan testadon de MachineTranslation.com.
Oftaj demandoj
1. Ĉu Qwen aŭ ChatGPT estas pli bona por tradukado?
Trans 98 lingvoparoj testitaj sur identa fontoteksto, ChatGPT atingis pli altan poentaron en 77 el ili. La plej forta montriĝo de Qwen estas tradukado en la anglan, kie ambaŭ preskaŭ egalas. En ĉiu alia direkto, ChatGPT gajnas la grandan plimulton de la paroj, do la sincera respondo tre dependas de tio, en kiu direkto la enhavo moviĝas.
2. Ĉu ChatGPT aŭ Qwen subtenas pli da lingvoj?
Ambaŭ estas ĝeneraluzaj AI-modeloj sen kontrolita, publikigita listo de lingvospecifaj limigoj. Nek publikigas sendepende konfirmitajn datumojn pri lingvopara kovrado, kio estas malsama ol platformo, kiu testas kaj poentas tradukokvaliton trans pli ol 330 lingvoj rekte, anstataŭ fidi je ĝeneralaj asertoj pri multlingva trejnado.
3. Ĉu Qwen aŭ ChatGPT estas pli bona por jura kaj komerca tradukado?
Neniu el ili estas fidinde pli bona ĝenerale. Testante germanan laborjuran terminon, DeepSeek kaj ChatGPT produktis uzeblan funkcian frazaron, dum Claude kaj Qwen ambaŭ alvokis nerilatan juran koncepton, montrante, ke la disiĝo dependas de termino kaj kunteksto, ne de tio, kiu modelo estas ĝenerale pli forta.
4. Ĉu MachineTranslation.com konkuras kun ChatGPT kaj Qwen?
Ne. MachineTranslation.com rulas ChatGPT, Qwen kaj pli ol 20 aliajn AI-modelojn por ĉiu traduko kaj montras la version, pri kiu tiuj modeloj plej konsentas. Ĝi testas kaj kombinas modelojn kiel ĉi tiujn anstataŭ funkcii kiel aparta, konkuranta modelo propra.
5. Kiun modelon mi elektu por granda lokaliza projekto?
Neniu el ili sola estas sekura defaŭlto kiam enhavo moviĝas tra multaj lingvoj en ambaŭ direktoj. La direkto-specifa disiĝo dokumentita ĉi tie signifas, ke modelo, kiu funkcias bone tradukante en la anglan, povas funkcii tre malsame tradukante el ĝi, tra dekoj da lingvoparoj samtempe.
6. Kiu Qwen-modelo estas plej bona por tradukado?
Ĉi tio ankoraŭ ne estas disponebla. La spurado de MachineTranslation.com nuntempe registras Qwen kiel ununuran motoron sen modelo-versia etikedo, male al aliaj provizantoj, do kvalitdatenoj laŭ subversioj ne ekzistas por raporti. Post kiam tio estos solvita, vera detala analizo inter Qwen3.8-Max kaj Qwen3.8-27B estos ebla; nuntempe, ĉi tio estas vera manko, ne nur nemezurita detalo.