October 2, 2026
Qwen kontraŭ Grok: Kiu AI-modelo tradukas pli bone?
Qwen kaj Grok estas ambaŭ ĝeneralcelaj AI-modeloj, ne traduk-specifaj iloj, kaj ambaŭ estas parto de la modelaro, kiun MachineTranslation.com rulas por ĉiu traduko. Tio gravas por kiel oni legu la jenon. Ĉi tio estas rigardo al kiel du el la propraj modeloj de la platformo agas unu kompare kun la alia, kun la realaj avertoj, kiuj akompanas tian specon de datumoj, ne konkurso inter du eksteraj defiantoj kaj la platformo mem.
Kio estas Qwen kaj Grok?
Qwen estas la familio de grandaj lingvomodeloj de Alibaba, nuntempe en sia generacio Qwen3.8, kaj estis aldonita al la modelaro de MachineTranslation.com kiel parto de la daŭra vastiĝo de la platformo. Grok estas la modelserio de xAI, nuntempe ĉe Grok 4.7 je la momento de ĉi tiu verkado, trapasinte plurajn eldonojn ekde la versio, kiun ĉi tiu artikolo origine komparis, kaj ĝi aliĝis al la platformo aparte. Neniu el la modeloj estis konstruita specife por tradukado. Ambaŭ estas ĝeneralcelaj sistemoj, kiuj cetere pritraktas multajn lingvojn kiel parton de pli vasta lingvokapablo, kio estas malsama deirpunkto kompare kun platformo konstruita kaj testita specife pri tradukkvalito.
Kiel Qwen kaj Grok komparatas laŭ la propraj datumoj de MachineTranslation.com?
Dum la lastaj 28 tagoj de trafiko en la platformo, Grok atingis averaĝe pli altan poentaron ol Qwen: 9.26 el 10 kontraŭ 8.87. La 10% de la tradukoj de Grok kun la plej malbona poentaro ankoraŭ averaĝis je 9.2, dum la 10% plej malbone poentitaj de Qwen falis al 7.6, kio estas pli granda diferenco ĉe la malalta ekstremo ol la averaĝo mem sugestas.
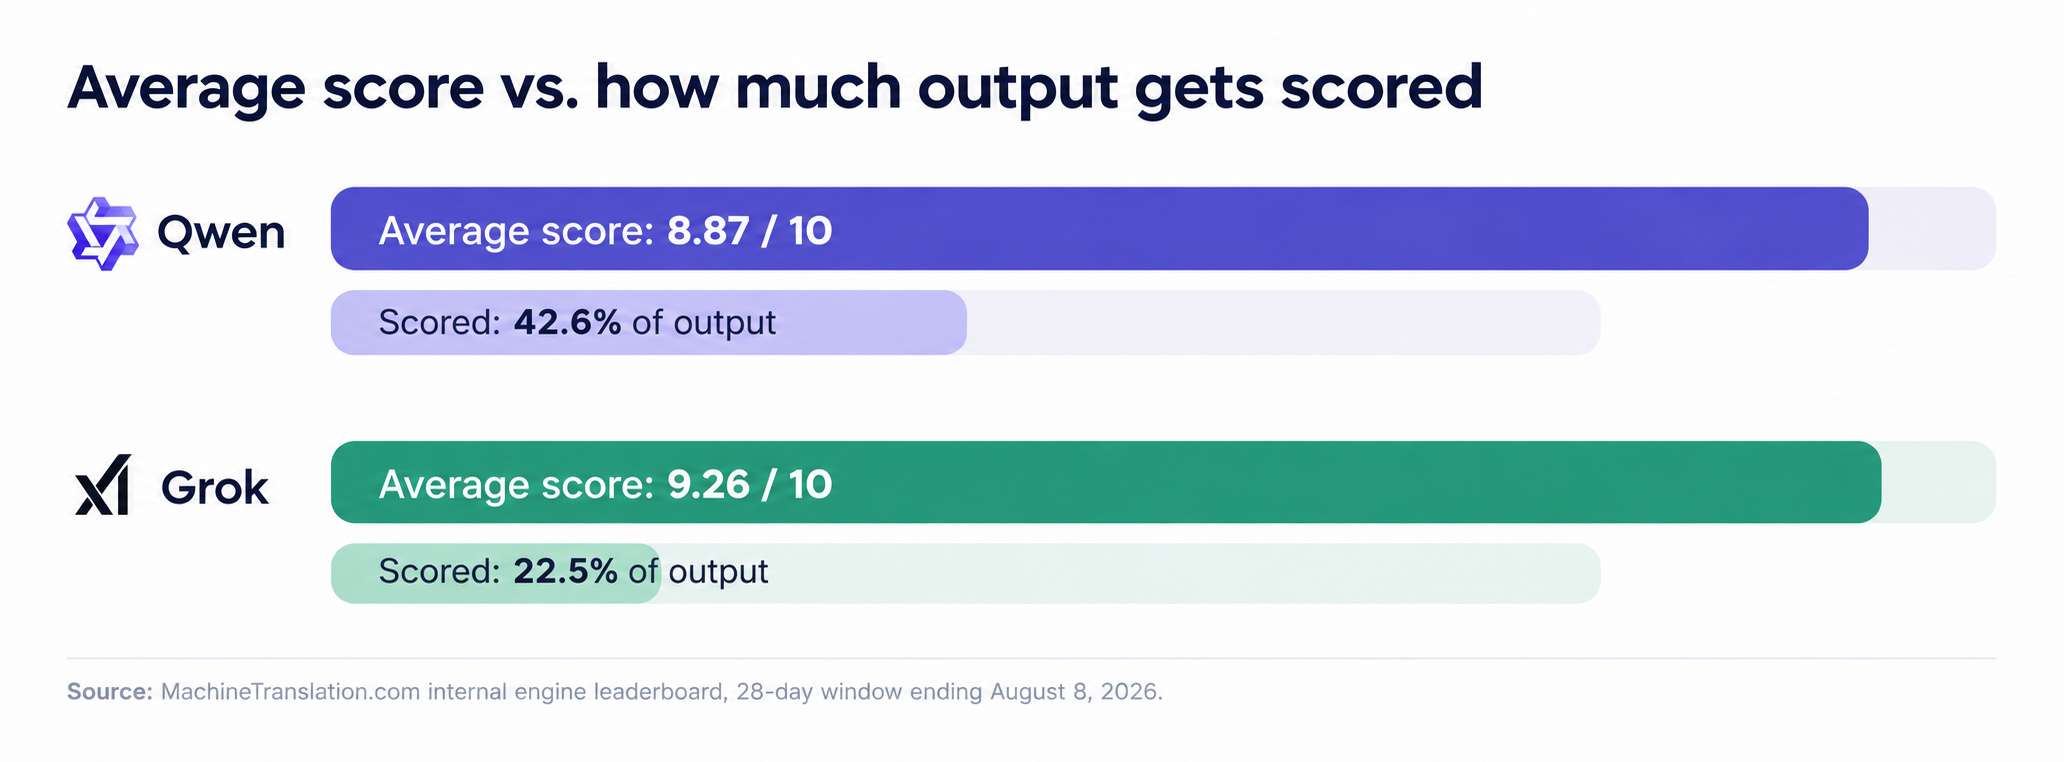
La averaĝa poentaro de Grok estas pli alta, sed ĝi baziĝas sur la poentado de malpli ol kvarono de ĝia eligo, kontraŭ preskaŭ duono por Qwen. La du stangoj rakontas malsamajn partojn de la sama rakonto.
| Qwen | Grok | |
|---|---|---|
| Procento de la eligo poentita | 42.6% | 22.5% |
| Averaĝa poentaro | 8.87 / 10 | 9.26 / 10 |
| Plej malaltaj 10% de poentoj | 7.6 | 9.2 |
Fonto: Interna motor-rangotabelo de MachineTranslation.com, 28-taga periodo finiĝanta la 8-an de aŭgusto 2026.
Ĉu la pli alta poento de Grok signifas, ke ĝi estas la pli bona elekto?
Ne per si mem. Grok estas uzata multe malpli ofte en la platformo ol Qwen, kaj malpli ol kvarono de ĝiaj tradukoj entute ricevas poentojn, kontraŭ preskaŭ duono de tiuj de Qwen. Pli malgranda, malpli reprezenta specimeno povas igi meznombron aspekti pli bona aŭ pli malbona ol ĝi estus tra la sama volumeno kiun vidas Qwen. La propra raportado de MachineTranslation.com pri ĉi tiuj datumoj traktas poentan kovradon kiel realan limigon, ne kiel piednoton: motoro poentita sur mallarĝa tranĉaĵo de sia trafiko ne estis testita tiel plene kiel tiu poentita tra preskaŭ duono de sia eligo.
La honesta lego estas, ke la nombroj de Grok estas esperigaj sed malpli ampleksaj. Tiuj de Qwen estas averaĝe pli malaltaj sed baziĝas sur multe pli granda, pli reprezenta bazo. Neniu el la faktoj nuligas la alian.
Kio pri lingva kovrado?
Nek Qwen nek Grok publikigas atestitan liston de lingvaj paroj, kie la rendimento malaltiĝas, kaj ne ekzistas sendependa testado por konfirmi tion. Kion oni povas diri kun certeco estas, ke neniu el la modeloj estis konstruita ĉirkaŭ tradukkvalito por specifa aro da lingvoj kiel estas dediĉita tradukplatformo. MachineTranslation.com rekte testas kaj subtenas pli ol 270 lingvojn, kio estas malsama speco de aserto ol la larĝa sed netestita multlingva kapablo de ĝeneraluzebla modelo.
Kiel MachineTranslation.com fakte uzas Qwen kaj Grok
MachineTranslation.com rulas Qwen, Grok, kaj pli ol 20 aliajn AI-modelojn por ĉiu traduko, kaj poste elmontras la version, pri kiu tiuj modeloj plej konsentas. Neniu modelo estas ekskludita pro averaĝe malpli alta poentado. Ruli multajn modelojn samtempe signifas kapti la kazojn, kie averaĝe malpli bone poentanta modelo tamen ĝuste tradukas specifan frazon, kiun pli bone poentanta modelo maltrafas. La rendimento de Qwen ankaŭ dividiĝas laŭ direkto kaj paro en manieroj sciindaj antaŭ ol elekti unuopan modelon, pli detale pritraktitaj en la komparo inter Qwen kaj DeepSeek de MachineTranslation.com. Por pli proksima rigardo al tio, kiel modeloj estas rekte testataj unu kontraŭ la alia, vidu la plenan testadon pri modelkomparo de MachineTranslation.com.
Oftaj demandoj
1. Ĉu Qwen aŭ Grok estas pli bona por tradukado?
Laŭ la propraj datumoj de la motoroj de MachineTranslation.com dum 28 tagoj, Grok ricevas averaĝe pli altan poentaron ol Qwen, 9.26 kontraŭ 8.87 el 10. Sed Grok estas poentata laŭ multe pli malgranda, malpli reprezenta parto de sia eligo, do tio ne estas pura rekta komparo kiel estus provo kun kongruaj segmentoj.
2. Kial Grok havas pli altan averaĝan poentaron sed malpli da poentitaj tradukoj?
Grok estas uzata malpli ofte en la platformo kaj nur ĉirkaŭ 22.5% de ĝia eligo estas poentata, kontraŭ 42.6% ĉe Qwen. Pli malgranda, malpli reprezenta specimeno povas ŝveligi aŭ subtaksi averaĝon, kaj pro tio ĉi tiu komparo devus esti legata kiel indika, ne definitiva.
3. Ĉu Qwen aŭ Grok subtenas pli da lingvoj?
Ambaŭ estas ĝeneralcelaj AI-modeloj sen publikigita, kontrolita listo de lingvospecifaj limigoj. Neniu el ili estas konstruita specife por tradukado, kio estas malsama al platformo kiu rekte testas kaj poentas tradukkvaliton tra 270+ lingvoj, anstataŭ fidi al larĝa multlingva trejnado kiel anstataŭaĵo por mezurita tradukefikeco.
4. Ĉu MachineTranslation.com konkuras kun Qwen kaj Grok?
Ne. MachineTranslation.com rulas Qwen, Grok kaj pli ol 20 aliajn AI-modelojn por ĉiu traduko kaj elmontras la version pri kiu tiuj modeloj plej konsentas. Ĝi testas kaj kombinas tiajn modelojn anstataŭ konkuri kontraŭ ili kiel propra, aparta modelo.
5. Kiun AI-modelon MachineTranslation.com rekomendas por tradukado?
Neniun defaŭlte. Malsamaj modeloj funkcias malsame laŭ lingvoparo kaj enhavotipo, kaj la diferenco inter ili povas iri en ajna direkto depende de tio, kio estas tradukata. Tiu variado estas ĝuste la kialo, pro kiu la platformo rulas plurajn modelojn por ĉiu traduko anstataŭ elekti unu kiel konstantan rekomendon.