September 25, 2026
De GPT-3 a GPT-5: Cómo cambió realmente la calidad de la traducción con IA
GPT-3, GPT-4 y GPT-5 están separados por cinco años y varias generaciones de arquitectura, pero la pregunta útil para la traducción no es «cuál es el más inteligente». Es más específica: ¿qué cambió exactamente en la forma en que estos modelos manejan las partes de un idioma que no se traducen palabra por palabra, como los modismos, la ambigüedad y el registro? La mejora se produjo en aspectos concretos, en momentos específicos, y no siguió una línea recta de los más antiguos a los más nuevos.
Lo que GPT-3 ofreció realmente para la traducción
OpenAI lanzó GPT-3 en 2020, antes de que existiera el programa de pruebas propio de MachineTranslation.com, por lo que nada de lo aquí expuesto es una comparativa propietaria. Es historia bien documentada, no el resultado de una prueba interna. GPT-3 fue el primer modelo de su tipo capaz de generar texto fluido y con tono humano en múltiples idiomas sin un entrenamiento específico para la tarea, lo que lo convirtió en un auténtico hito. Específicamente para la traducción, esa misma fluidez conllevaba un riesgo real: GPT-3 podía generar una oración con total seguridad y bien estructurada en el idioma de destino que, aun así, era incorrecta, sin que nada en el resultado indicara que se había cometido un error.
Qué cambió con la llegada de GPT-4
GPT-4 se lanzó en marzo de 2023, y las pruebas de modelos de MachineTranslation.com comienzan a intensificarse en torno a esta generación. La mejora fue real, pero desigual. Al probar la ambigua frase en inglés «That's sick» en japonés, GPT-4.1-nano fue el único de los seis modelos evaluados que redujo el deliberado doble sentido de la expresión a una sola interpretación, mientras que los otros cinco conservaron la ambigüedad prevista por la frase original. Los modismos fueron una debilidad mayor: al procesar el modismo en español «llevarse el gato al agua» en cinco versiones de GPT simultáneamente, los más pequeños GPT-4o-mini y GPT-4.1-nano produjeron la misma traducción literal e incorrecta, pasando por alto el modismo por completo.
El mismo patrón se repitió en otros casos. La expresión alemana «ich verstehe nur Bahnhof», analizada en ocho subversiones de GPT y Claude, fue traducida de forma literal e incorrecta específicamente por GPT-4o-mini, mientras que un modelo más nuevo y pequeño en la misma prueba, GPT-4.1-nano, la tradujo correctamente. La generación y el tamaño del modelo no se correspondieron de manera coherente, un patrón que las pruebas de versiones de modelos de MachineTranslation.com cubren con mayor profundidad.
Qué cambió GPT-5 para la traducción
OpenAI presentó GPT-5 como un sistema unificado que enruta entre un modelo rápido predeterminado y un modelo de razonamiento más profundo según la tarea, un cambio estructural respecto al diseño de modelo único de GPT-4. La propia GPT-5 System Card de OpenAI informa que la tasa general de errores fácticos del modelo es aproximadamente un 45% menor que la de GPT-4 y un 80% menor que la de GPT-3, una mejora general de fiabilidad que también se refleja específicamente en la traducción. Las pruebas de MachineTranslation.com muestran las mejoras más claras donde los modelos de la era de GPT-4 tenían más dificultades: con el mismo modismo en español en el que fallaron GPT-4o-mini y GPT-4.1-nano, tanto GPT-5.4-mini como GPT-5.4 consiguieron traducciones correctas e idiomáticas, cada uno formulándola de manera ligeramente diferente, pero comprendiendo ambos el modismo en sí.
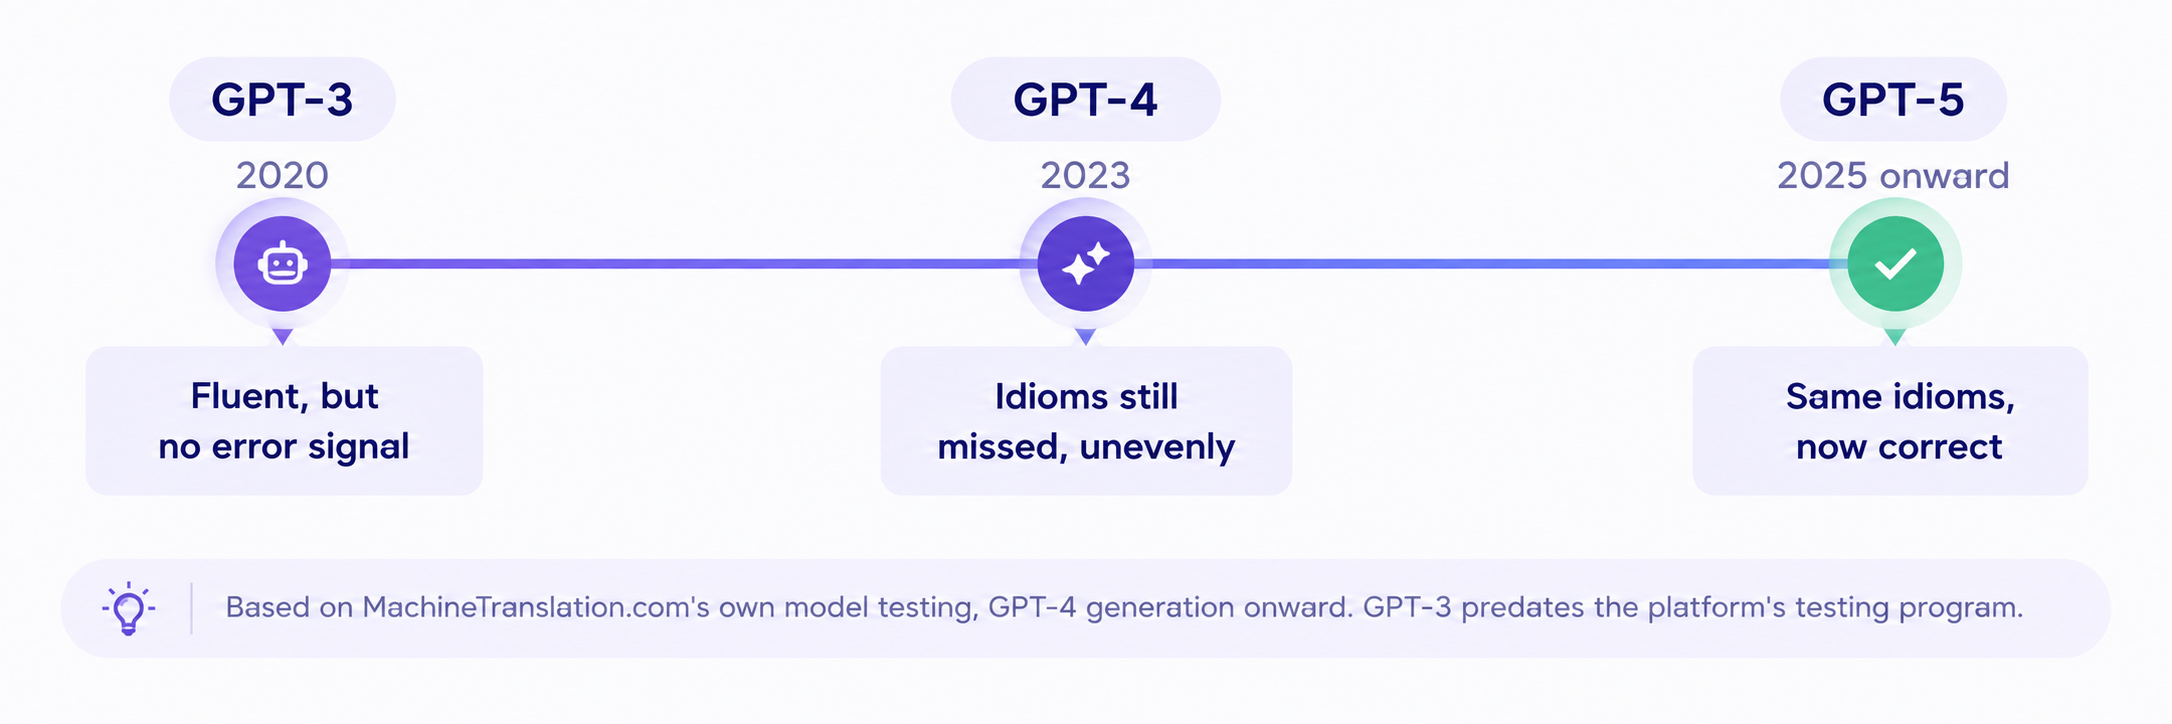
La brecha entre generaciones no fue un ascenso constante. Se concentró casi por completo en el lenguaje idiomático y ambiguo. En textos sencillos, los modelos de la era de GPT-4 y de la era de GPT-5 obtienen puntuaciones prácticamente idénticas.
| GPT-3 | GPT-4 | GPT-5 | |
|---|---|---|---|
| Lanzamiento | 2020 | Marzo de 2023 | 2025, actualmente en GPT-5.4/5.5 |
| Disponible hoy | No, retirado | Solo API, retirado de ChatGPT | Sí, generación actual |
| Manejo de modismos | No probado por MachineTranslation.com (anterior al programa) | Inconsistente; pasó por alto varios modismos por completo | Manejó correctamente los mismos modismos en los que GPT-4 falló |
| Texto empresarial estándar | No probado por MachineTranslation.com | Sólido, casi idéntico a modelos posteriores | Sólido, casi idéntico a GPT-4 |
Ese último punto es importante: una prueba independiente con una frase empresarial estándar, "por favor confirme la recepción de este documento", traducida al alemán, arrojó resultados casi idénticos en todos los modelos probados, incluidos GPT-4o-mini y los modelos de la generación GPT-5. La brecha generacional es específica del lenguaje figurado y ambiguo, no una diferencia general de calidad.
¿Una generación más nueva de GPT siempre significa una mejor traducción?
No. Al probar un modismo en hebreo entre distintas familias de modelos, GPT-5.4-mini y GPT-5.4 llegaron a dos interpretaciones diferentes y parciales de la misma frase, ninguna de ellas totalmente correcta, mientras que un modelo más antiguo y no relacionado se acercó más. Un modelo más nuevo no es automáticamente más preciso, y un modelo más grande o más reciente no es automáticamente la opción más segura para una oración determinada.
Dónde se sitúa GPT-5 en traducción hoy en día
Tanto GPT-3 como GPT-4 han sido retirados de ChatGPT; GPT-4 sigue siendo accesible únicamente a través de la API de OpenAI para integraciones existentes. La generación actual, GPT-5.4 y GPT-5.5, es la que MachineTranslation.com utiliza hoy en día, y ofrece un rendimiento competitivo frente a los modelos actuales de otros proveedores, aunque no de manera uniformemente superior en todos los pares de idiomas. Para ver más detalladamente cómo se comparan las subversiones actuales de GPT entre sí y frente a modelos como Claude y DeepSeek, consulte las pruebas comparativas directas de subversiones de MachineTranslation.com, que profundizan más de lo que puede hacerlo una visión general generacional.
Qué significa esto si localiza a gran escala
El hallazgo más importante para un programa de localización a gran escala no es que «GPT-5 supera a GPT-3». Es que la versión del modelo, y no solo la familia del modelo, determina si un modismo específico o una frase ambigua se traduce correctamente, y esto se aplica a todos los pares de idiomas, no solo al puñado que se muestra aquí. Esto es aún más relevante en contenidos que se basan principalmente en el tono y el lenguaje figurativo, especialmente los textos de marketing y el contenido generado por los usuarios, donde un solo modismo traducido literalmente puede cambiar por completo el significado de una publicación o un anuncio. Un programa que traslade contenidos a docenas de idiomas se topará exactamente con este tipo de lenguaje en cada uno de ellos. La serie de pruebas de subversiones y las pruebas completas de comparación de modelos de MachineTranslation.com abordan esto con mayor profundidad. El enfoque de la plataforma, que ejecuta los modelos GPT actuales junto con más de 20 modelos adicionales en cada traducción, existe específicamente porque el historial de versiones de un solo modelo no es una garantía suficientemente confiable por sí mismo.
Preguntas frecuentes
1. ¿Cuál es la diferencia real entre GPT-3, GPT-4 y GPT-5 para la traducción?
GPT-3 manejaba textos sencillos razonablemente bien, pero tenía serias dificultades con cualquier expresión idiomática o ambigua. GPT-4 redujo notablemente esa brecha, pero aun así redujo algunas frases genuinamente ambiguas a un solo significado en lugar de preservar la ambigüedad. Las subversiones posteriores de GPT-5 gestionaron correctamente modismos que los primeros modelos de la era de GPT-4 tradujeron de forma literal e incorrecta.
2. ¿Es GPT-5 siempre mejor que GPT-4 en traducción?
No. Las propias pruebas de MachineTranslation.com han detectado casos en los que una subversión más pequeña y reciente superó a una más grande y antigua, y la brecha de calidad entre generaciones suele limitarse al lenguaje idiomático o figurativo en lugar de representar una mejora general y uniforme.
3. ¿Sigue ofreciendo OpenAI GPT-3 o GPT-4?
No. Ambos han sido retirados de ChatGPT y sustituidos por modelos más recientes de la generación GPT-5. GPT-4 sigue siendo accesible únicamente a través de la API de OpenAI para integraciones existentes, no como una opción orientada al consumidor actual.
4. ¿Qué versión de GPT utiliza MachineTranslation.com?
MachineTranslation.com ejecuta modelos actuales de la generación GPT-5 (GPT-5.4 y GPT-5.5, según el nivel del plan) junto con más de otros 20 modelos de IA en cada traducción, en lugar de depender únicamente de GPT.
5. ¿Cómo se compara GPT-5 con otros modelos de IA actuales para la traducción?
Los modelos de la generación GPT-5 tienen un desempeño competitivo, pero no uniformemente superior al de modelos como Claude, Gemini o DeepSeek. Distintos modelos ganan en diferentes pares de idiomas y tipos de contenido, razón por la cual MachineTranslation.com los pone a prueba directamente entre sí en lugar de elegir uno por defecto.