October 9, 2026
Qwen vs ChatGPT: ¿Qué modelo de IA traduce mejor?
La generación actual de ChatGPT y Qwen forman parte del grupo de modelos que MachineTranslation.com ejecuta en cada traducción, y no son dos competidores externos que se evalúan frente a la propia plataforma. Al procesar el mismo texto a través de ambos en segmentos idénticos, ChatGPT gana en la mayor parte de los pares de idiomas en general. Si se dividen los resultados por dirección, el panorama se reduce drásticamente en un aspecto específico: al traducir al inglés, donde ambos están prácticamente empatados.
¿Hay alguna IA mejor que ChatGPT para la traducción?
El interés general por las alternativas a ChatGPT ha crecido a medida que los modelos competidores han mejorado, aunque las razones varían mucho según el caso de uso y no existe una explicación única. En el caso específico de la traducción, la pregunta más útil es qué modelo ofrece realmente un mejor rendimiento en un par de idiomas determinado, una cuestión verificable más que una simple cuestión de percepción.
Durante los últimos 28 días de tráfico de MachineTranslation.com, ambos modelos tradujeron textos de origen idénticos en 98 pares de idiomas. ChatGPT obtuvo una puntuación más alta en 77 de esos pares; Qwen obtuvo una puntuación más alta en 21. El promedio ponderado de los resultados comparados sitúa a ChatGPT en 9.10 sobre 10 y a Qwen en 8.98, una diferencia real pero modesta en promedio que oculta una división mucho más marcada una vez que se tiene en cuenta la dirección.
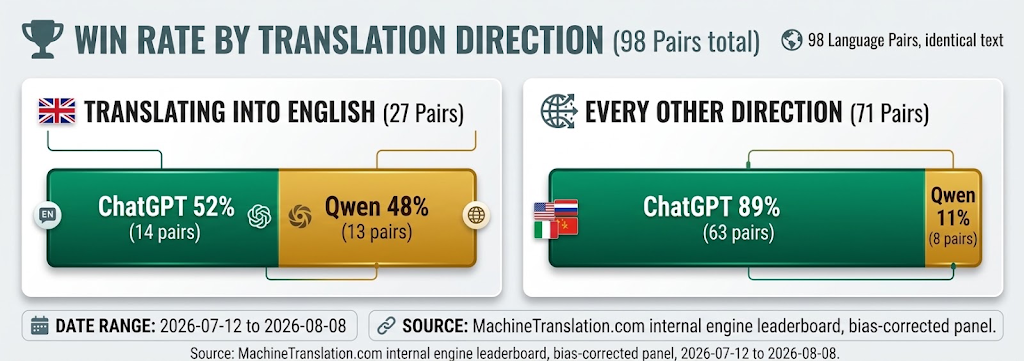
Hacia el inglés, los dos modelos están prácticamente empatados. En todas las demás direcciones, ChatGPT se impone en la gran mayoría de los pares evaluados.
| ChatGPT | Qwen | |
|---|---|---|
| Porcentaje de resultados evaluados | 54.76% | 42.6% |
| Puntuación promedio | 8.89 / 10 | 8.87 / 10 |
| 10% más bajo de las puntuaciones | 7.8 | 7.6 |
| Tasa de victorias, hacia el inglés | 52% | 48% |
| Tasa de victorias, en cualquier otra dirección | 89% | 11% |
¿Por qué la brecha casi desaparece al traducir al inglés?
Los datos muestran dónde se produce la división, no el porqué. Lo que está claro es que la competitividad de Qwen no se distribuye de manera uniforme. De los 27 pares donde el idioma de destino es el inglés, Qwen se lleva 13, lo que es prácticamente lanzar una moneda al aire. De los 71 pares restantes, tanto al traducir desde el inglés como entre dos idiomas distintos del inglés, ChatGPT gana 63, es decir, el 89% de ellos. Un equipo que asuma que el rendimiento de Qwen hacia el inglés se traslada a las traducciones hacia otros idiomas o entre pares que no incluyen el inglés estaría extrayendo la lección equivocada de la dirección equivocada.
¿Es Qwen una empresa china y tiene eso importancia para la traducción?
Qwen es desarrollado por Alibaba Cloud, con sede en China. Por sí solo, eso no cambia lo bien que el modelo traduce una frase determinada; los datos anteriores reflejan la calidad real del resultado independientemente de dónde se construya un modelo. En lo que sí puede influir es en el manejo de datos: las empresas que traducen contenido regulado o sensible (contratos, historiales médicos, información personal) deberían tratar la cuestión de dónde procesa y almacena ese contenido un proveedor de IA como un punto real de diligencia debida, al margen de la calidad de la traducción en sí. Esto se aplica a cualquier proveedor de IA, no a Qwen específicamente, y es parte de la razón por la que MachineTranslation.com publica directamente sus propias prácticas de seguridad y manejo de datos en lugar de dejar la pregunta sin respuesta.
¿Es alguno de los dos modelos más confiable para la traducción legal y empresarial?
No de manera constante, y la divergencia no siempre se reduce a qué modelo obtiene una puntuación más alta. Las pruebas de MachineTranslation.com con lenguaje contractual real descubrieron dos casos independientes que vale la pena conocer antes de confiar en cualquiera de los dos modelos para textos jurídicos. El lenguaje idiomático a veces funciona en sentido contrario: una prueba comparativa independiente reveló que ChatGPT tradujo un modismo alemán de manera literal e incorrecta, mientras que Qwen encontró el significado idiomático correcto, un recordatorio de que la ventaja general de ninguno de los modelos en los datos agregados se mantiene frase por frase.
| Caso de prueba | ChatGPT | Qwen |
|---|---|---|
| "At-will employment" al alemán | Redacción funcional y utilizable | Recurrió a un concepto jurídico no relacionado |
| Cláusula de limitación de responsabilidad al español | "que surjan de" | "derivados de" (diferencia que altera el alcance) |
| "Ich verstehe nur Bahnhof" (modismo alemán) | Traducido literalmente, incorrecto | Significado idiomático correcto |
Ninguno de los modelos gana de forma sistemática en estos tres casos: la puntuación agregada de un modelo no predice su comportamiento en un término o frase específicos. Esta es también la razón por la cual los textos jurídicos y contractuales se benefician de una etapa de verificación humana, independientemente del modelo que haya producido el primer borrador.
¿Qué hay de la cobertura de idiomas?
Ni ChatGPT ni Qwen publican una lista verificada e independientemente confirmada de pares de idiomas en los que la calidad de la traducción disminuye. Ambos son modelos de propósito general con un amplio entrenamiento multilingüe, lo cual es una afirmación diferente al rendimiento de traducción medido en un conjunto de idiomas específico. MachineTranslation.com evalúa y califica la calidad de la traducción directamente en más de 330 idiomas, en lugar de depender de la capacidad lingüística general de un modelo como un indicador de qué tan bien traduce en la práctica.
¿Qué no deberías pegar en ChatGPT o Qwen para traducción empresarial?
Ni ChatGPT ni Qwen fueron diseñados como plataformas de traducción dedicadas, y pegar contenido empresarial confidencial directamente en una interfaz de chat de propósito general conlleva las mismas dudas sobre el tratamiento de datos que pegarlo en cualquier otra herramienta de IA de consumo: dónde se procesa la información ingresada, si se retiene y quién puede acceder a ella. Los contratos, historiales médicos, documentos de inmigración y estados financieros son exactamente el tipo de contenido donde vale la pena responder a esa pregunta antes de traducir, no después. Esta es una razón real por la que una plataforma de traducción dedicada con prácticas de tratamiento de datos públicas y verificables es una propuesta diferente a una interfaz de chat de propósito general, independientemente de qué modelo se encuentre detrás de cualquiera de ellas.
Cómo utiliza realmente MachineTranslation.com ambos modelos
MachineTranslation.com ejecuta ChatGPT, Qwen y más de otros 20 modelos de IA en cada traducción, y luego presenta la versión en la que dichos modelos coinciden más. Dado lo drásticamente que difiere el rendimiento de Qwen y ChatGPT según la dirección de la traducción, elegir un modelo como predeterminado por defecto significaría equivocarse en una proporción predecible de pares de idiomas. El mismo patrón dependiente de la dirección aparece en la comparación de Qwen vs. DeepSeek de MachineTranslation.com. Para obtener un panorama completo de cómo se evalúan los modelos actuales entre sí, consulte las pruebas completas de comparación de modelos de MachineTranslation.com.
Preguntas frecuentes
1. ¿Es mejor Qwen o ChatGPT para la traducción?
En 98 pares de idiomas evaluados con un texto de origen idéntico, ChatGPT obtuvo una puntuación más alta en 77 de ellos. El desempeño más sólido de Qwen se da al traducir hacia el inglés, donde ambos están prácticamente empatados. En todas las demás direcciones, ChatGPT se impone en la gran mayoría de los pares, por lo que la respuesta sincera depende en gran medida de en qué dirección se traslade el contenido.
2. ¿ChatGPT o Qwen admiten más idiomas?
Ambos son modelos de IA de propósito general sin una lista publicada y verificada de limitaciones específicas por idioma. Ninguno publica datos de cobertura de pares de idiomas confirmados de forma independiente, lo cual difiere de una plataforma que evalúa y califica la calidad de la traducción directamente en más de 330 idiomas, en lugar de basarse en afirmaciones generales sobre el entrenamiento multilingüe.
3. ¿Es mejor Qwen o ChatGPT para la traducción jurídica y empresarial?
Ninguno es sistemáticamente mejor en todos los casos. Al probar un término del derecho laboral alemán, DeepSeek y ChatGPT produjeron una redacción funcional y utilizable, mientras que tanto Claude como Qwen recurrieron a un concepto legal no relacionado, lo que demuestra que la discrepancia varía según el término y el contexto, y no en función de qué modelo sea generalmente más potente.
4. ¿Compite MachineTranslation.com con ChatGPT y Qwen?
No. MachineTranslation.com ejecuta ChatGPT, Qwen y más de otros 20 modelos de IA en cada traducción y presenta la versión en la que dichos modelos coinciden más. Evalúa y combina modelos como estos en lugar de actuar como un modelo propio independiente y competidor.
5. ¿Qué modelo debería elegir para un proyecto de localización a gran escala?
Ninguno de los dos por sí solo es una opción predeterminada segura una vez que el contenido abarca muchos idiomas en ambas direcciones. La disparidad según la dirección documentada aquí significa que un modelo con buen rendimiento al traducir hacia el inglés puede funcionar de manera muy diferente al traducir desde este, a través de docenas de pares de idiomas a la vez.
6. ¿Qué modelo de Qwen es mejor para la traducción?
Esto aún no está disponible. El seguimiento de MachineTranslation.com registra actualmente a Qwen como un único motor sin una etiqueta de versión de modelo, a diferencia de otros proveedores, por lo que no existen datos de calidad por subversión para reportar. Una vez que esto se solucione, será posible hacer un desglose real entre Qwen3.8-Max y Qwen3.8-27B; por ahora, se trata de una brecha real, no solo de un detalle sin medir.