September 9, 2026
Qwen vs DeepSeek: ¿Qué modelo de IA traduce mejor?
Al pasar los mismos 12,000 segmentos de traducción por Qwen y DeepSeek, DeepSeek gana en la mayoría de los pares de idiomas. Esa no es toda la historia. Al dividir los resultados por dirección, aparece un patrón específico: Qwen reduce la mayor parte de la brecha y, a veces, toma la delantera, específicamente cuando el idioma de destino es el inglés. Al traducir desde el inglés a cualquier otro idioma, DeepSeek gana casi siempre.
Esa división importa más que un único ganador global si se traduce contenido en docenas de idiomas en lugar de un solo par de idiomas.
¿Qué son Qwen y DeepSeek?
Qwen es la familia de modelos de lenguaje grandes de Alibaba. La generación actual es Qwen3.8, lanzada en agosto de 2026: Qwen3.8-Max es el modelo insignia cerrado y solo disponible por API con 2.4 billones de parámetros, mientras que Qwen3.8-27B es un modelo de pesos abiertos más pequeño, lanzado bajo Apache 2.0 unos días después, dirigido a equipos que desean autoalojarlo.
DeepSeek es un laboratorio de IA chino conocido por sus modelos de mezcla de expertos que igualan el rendimiento de vanguardia a una fracción del costo de inferencia. Su generación actual, DeepSeek V4, se lanzó en abril de 2026 en dos variantes: V4 Pro (1.6 billones de parámetros totales, unos 49 mil millones activos por token) para trabajos enfocados en la calidad, y V4 Flash (284 mil millones totales, unos 13 mil millones activos) para cargas de trabajo sensibles a la latencia. Ambos se distribuyen como pesos abiertos con licencia MIT.
¿Cómo se comparan realmente Qwen y DeepSeek en traducción, y no solo en benchmarks?
La mayoría de las comparaciones entre Qwen y DeepSeek citan benchmarks de propósito general: programación, matemáticas y razonamiento. Ninguno de ellos mide la calidad de la traducción directamente, y ejecutar cada modelo en textos de origen diferentes hace que sea imposible aislar cualquier brecha de precisión de lo que el propio texto exigía.
El propio tráfico de traducción de MachineTranslation.com durante los últimos 28 días ofrece una respuesta más clara, ya que ambos modelos tradujeron el mismo texto de origen de manera idéntica. En 98 pares de idiomas y más de 12,000 segmentos emparejados, DeepSeek obtuvo una puntuación más alta en 83 pares; Qwen obtuvo una puntuación más alta en 15. Si se reduce a los 27 pares en los que el idioma de destino es el inglés, la brecha se reduce drásticamente: DeepSeek gana el 63% de ellos (17 de 27), Qwen gana el 37% (10 de 27). En los 71 pares restantes, en los que el inglés no es el idioma de destino, DeepSeek gana el 92% (66 de 71).
Tasa de éxito por dirección de traducción (98 pares de idiomas, texto idéntico)
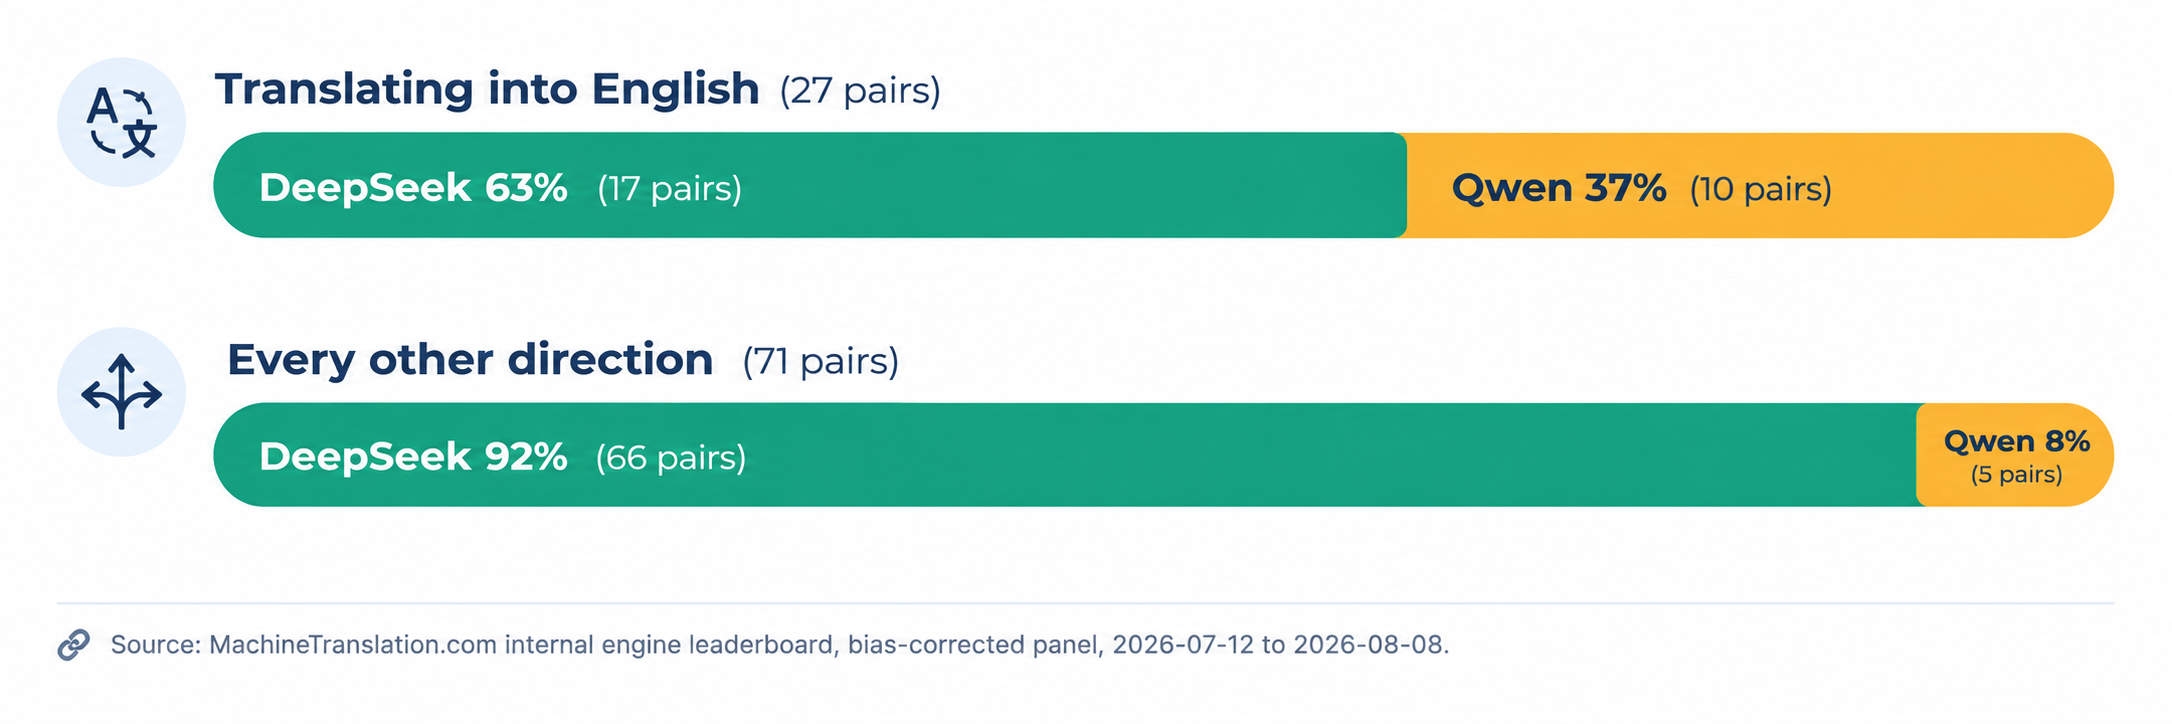
DeepSeek gana en la gran mayoría de los pares de idiomas en general. El margen competitivo de Qwen es estrecho pero real: traducir al inglés, donde se lleva más de un tercio de los pares. Datos: Tabla de clasificación de motores internos de MachineTranslation.com, panel con corrección de sesgo, del 12 de julio al 8 de agosto de 2026.
El promedio ponderado de todos los segmentos emparejados sitúa a DeepSeek en 9.13 de 10 y a Qwen en 8.98. Esa es una brecha real, pero no está distribuida de manera uniforme, lo cual es el dato más útil si su contenido se mueve en más de una dirección. Este es el mismo enfoque directo que utiliza MachineTranslation.com en todas sus pruebas comparativas de modelos completos, no solo para este par.
Las cifras agregadas también se mantienen en los casos de prueba individuales. Al probar la frase en francés "Elle est directrice adjointe du département commercial", DeepSeek y Qwen coincidieron en la misma traducción al inglés, "deputy director of commercial department". Puede comprobar ese resultado de la prueba en vivo directamente. Al probar "as soon as possible" traducido al español, DeepSeek se apartó del consenso de los cuatro modelos con "esté hecho" en lugar de "se haga", lo cual es un caso de divergencia real que refleja una distinción gramatical de proceso frente a resultado, no un error.
¿Por qué Qwen lo hace mejor al traducir específicamente al inglés?
Los datos no explican el porqué, sino solo el dónde. Algunos de los pares más fuertes de Qwen hacia el inglés son el tamil, el chino, el polaco, el italiano y el hebreo, que son idiomas de origen con corpus de entrenamiento en inglés amplios y bien documentados, disponibles en general para los creadores de modelos. Fuera de esa única dirección, la ventaja de DeepSeek se mantiene en casi todas partes: tanto desde el inglés como entre pares de idiomas distintos del inglés.
Lo que esto descarta es tratar a cualquiera de los dos modelos como una opción predeterminada universal. Un equipo que traduzca listados de productos del español a seis idiomas y espere la misma clasificación de rendimiento que vio al traducir un ticket de soporte de chino a inglés estaría aplicando la lección equivocada de la dirección equivocada, que es la misma asimetría que aparece en el desglose de modelos de español a inglés de MachineTranslation.com, donde los modelos líderes no son los mismos que lideran en la dirección opuesta.
¿Son Qwen y DeepSeek gratuitos y de código abierto?
La concesión de licencias se divide de manera diferente para cada uno. DeepSeek ofrece licencias tanto para V4 Pro como para V4 Flash bajo MIT, uno de los términos de código abierto más permisivos disponibles, por lo que ambos se pueden autoalojar de forma gratuita y sin restricciones. Qwen se divide: Qwen3.8-27B se distribuye bajo Apache 2.0 y se puede autoalojar de forma gratuita, pero el modelo insignia, Qwen3.8-Max, sigue siendo cerrado, disponible solo mediante API y bajo la propia licencia personalizada de Alibaba.
En la práctica, eso significa que existe una opción de pesos totalmente abiertos y con licencia MIT del lado de DeepSeek en ambos niveles de calidad. Por el lado de Qwen, optar por un modelo de pesos abiertos significa renunciar al modelo insignia.
¿Cuánto cuesta ejecutar Qwen y DeepSeek a escala?
Tras la reducción permanente de precios de DeepSeek en mayo de 2026, sus tarifas de API publicadas actualmente son de $0.435 per million input tokens (cache miss) and $0.87 por millón de tokens de salida para V4 Pro, con V4 Flash a un precio inferior para su nivel optimizado para latencia.
Para los equipos que autoalojan cualquiera de los dos modelos en lugar de utilizar una API alojada, la comparación de costos se traslada por completo a la infraestructura de GPU y pasa a ser una función del número de parámetros y de la eficiencia de los parámetros activos, en lugar de una tarifa por token.
¿Es alguno de los dos modelos lo suficientemente seguro para contenido legal, médico o regulado?
Ninguno de los dos modelos publica certificaciones de seguridad específicas para traducción, y los puntos de referencia de seguridad de propósito general no evalúan los modos de falla que importan en el contenido regulado: una dosis mal traducida, una cláusula de responsabilidad alterada o un término legal inconsistente. Las propias pruebas de MachineTranslation.com han encontrado exactamente este tipo de divergencia entre modelos en el lenguaje legal y médico, incluyendo casos en los que los modelos utilizaron diferentes términos legales con diferentes alcances a pesar de que ambos obtuvieron una buena puntuación en las métricas de calidad general.
Para contratos, documentos de inmigración o contenido clínico, eso justifica combinar la salida de cualquiera de los dos modelos con un paso de verificación humana en lugar de confiar ciegamente en una única salida de IA, independientemente de qué modelo la haya generado.
¿Qué significa esto si está localizando a muchos idiomas a la vez?
Una comparación basada en un solo par de idiomas no dice casi nada sobre el par número cuarenta. La división hacia el inglés/desde el inglés documentada aquí se mantuvo en una muestra de 98 pares específicamente porque se probó a esa escala: una sola prueba de inglés a español, que es lo que ejecutan la mayoría de las comparaciones entre Qwen y DeepSeek, habría mostrado a DeepSeek cómodamente a la cabeza y no habría dicho nada sobre lo que sucede una vez que el tamil, el polaco o el hebreo entran en el proceso.
Ese es el argumento práctico para no vincular por defecto un gran programa de localización a la salida de un solo modelo. MachineTranslation.com ejecuta tanto Qwen y DeepSeek, junto con más de otros 20 modelos, en cada traducción y presenta la versión en la que la mayoría de esos modelos coinciden, de modo que un despliegue en 68 idiomas no dependa de qué modelo resultó ganar en el único par que alguien probó primero. Puede ver exactamente qué modelos coincidieron o discreparon en cualquier traducción dada en el desglose de modelos por traducción que la plataforma muestra para cada resultado.
Cada traducción se verifica con una gama de modelos más amplia de la que Qwen o DeepSeek pueden ofrecer por sí solos, lo cual es la respuesta directa a lo que sucede una vez que su contenido deja de moverse en una sola dirección.
Preguntas frecuentes
1. ¿Es mejor Qwen o DeepSeek para la traducción?
En 98 pares de idiomas probados con un texto de origen idéntico, DeepSeek obtuvo una puntuación más alta en 83 de ellos. Las victorias de Qwen se concentran en una dirección específica: la traducción al inglés, donde gana aproximadamente un tercio de las veces. En cualquier otra dirección, DeepSeek gana más del 90% de las veces.
2. ¿Es Qwen de uso gratuito?
Qwen3.8-27B es de pesos abiertos bajo Apache 2.0 y se puede autoalojar de forma gratuita. El modelo insignia Qwen3.8-Max es cerrado y solo está disponible a través de la API de pago de Alibaba Cloud.
3. ¿Es DeepSeek de uso gratuito?
Sí. Tanto DeepSeek V4 Pro como V4 Flash se distribuyen con pesos abiertos bajo licencia MIT, por lo que puede alojar cualquiera de los dos por su cuenta sin ningún costo de licencia. DeepSeek también ofrece una API de pago para equipos que no desean gestionar su propia infraestructura.
4. ¿Cuál es más rápido, Qwen o DeepSeek?
DeepSeek V4 Flash está diseñado específicamente para una baja latencia, con 13 000 millones de parámetros activos por token frente a los 49 000 millones de V4 Pro. La opción ligera equivalente de Qwen, Qwen3.8-27B, es densa en lugar de una mezcla de expertos, lo que generalmente la hace más lenta por token a una calidad comparable.
5. ¿Puedo utilizar Qwen y DeepSeek juntos para la traducción?
Sí. MachineTranslation.com ejecuta ambos modelos, además de más de otros 20, en cada traducción y muestra la versión en la que más coinciden, por lo que no se queda estancado eligiendo un modelo y esperando que sea la opción más sólida para ese par de idiomas específico.
6. ¿Cuál es la diferencia entre las licencias de Qwen y DeepSeek?
DeepSeek licencia ambas variantes de V4 bajo MIT, una de las licencias de código abierto más permisivas disponibles. Qwen divide su gama: los modelos más pequeños como Qwen3.8-27B se distribuyen bajo Apache 2.0, pero el modelo insignia Qwen3.8-Max sigue siendo cerrado bajo una licencia personalizada.