October 2, 2026
Qwen vs Grok: ¿Qué modelo de IA traduce mejor?
Qwen y Grok son modelos de IA de propósito general, no herramientas específicas de traducción, y ambos forman parte del conjunto de modelos que MachineTranslation.com ejecuta en cada traducción. Esto es importante para interpretar lo que sigue. Este es un vistazo a cómo dos de los propios modelos de la plataforma se desempeñan entre sí, con las salvedades reales que conlleva este tipo de datos, y no una competencia entre dos contendientes externos y la plataforma en sí.
¿Qué son Qwen y Grok?
Qwen es la familia de grandes modelos de lenguaje de Alibaba, actualmente en su generación Qwen3.8, y se agregó al conjunto de modelos de MachineTranslation.com como parte de la expansión continua de la plataforma. Grok es la línea de modelos de xAI, actualmente en Grok 4.7 al momento de escribir este artículo, tras haber pasado por varias versiones desde la que este artículo comparó originalmente, y se unió a la plataforma por separado. Ningún modelo fue creado específicamente para la traducción. Ambos son sistemas de propósito general que resultan manejar muchos idiomas como parte de una capacidad lingüística más amplia, lo cual es un punto de partida diferente al de una plataforma construida y probada específicamente en torno a la calidad de la traducción.
¿Cómo se comparan Qwen y Grok en los propios datos de MachineTranslation.com?
Durante los últimos 28 días de tráfico de la plataforma, Grok obtuvo una puntuación promedio más alta que Qwen: 9.26 sobre 10 frente a 8.87. El 10 % de las traducciones con peor puntuación de Grok aun así promedió 9.2, mientras que el 10 % con peor puntuación de Qwen cayó a 7.6, una brecha más amplia en el extremo inferior de lo que sugiere el promedio por sí solo.
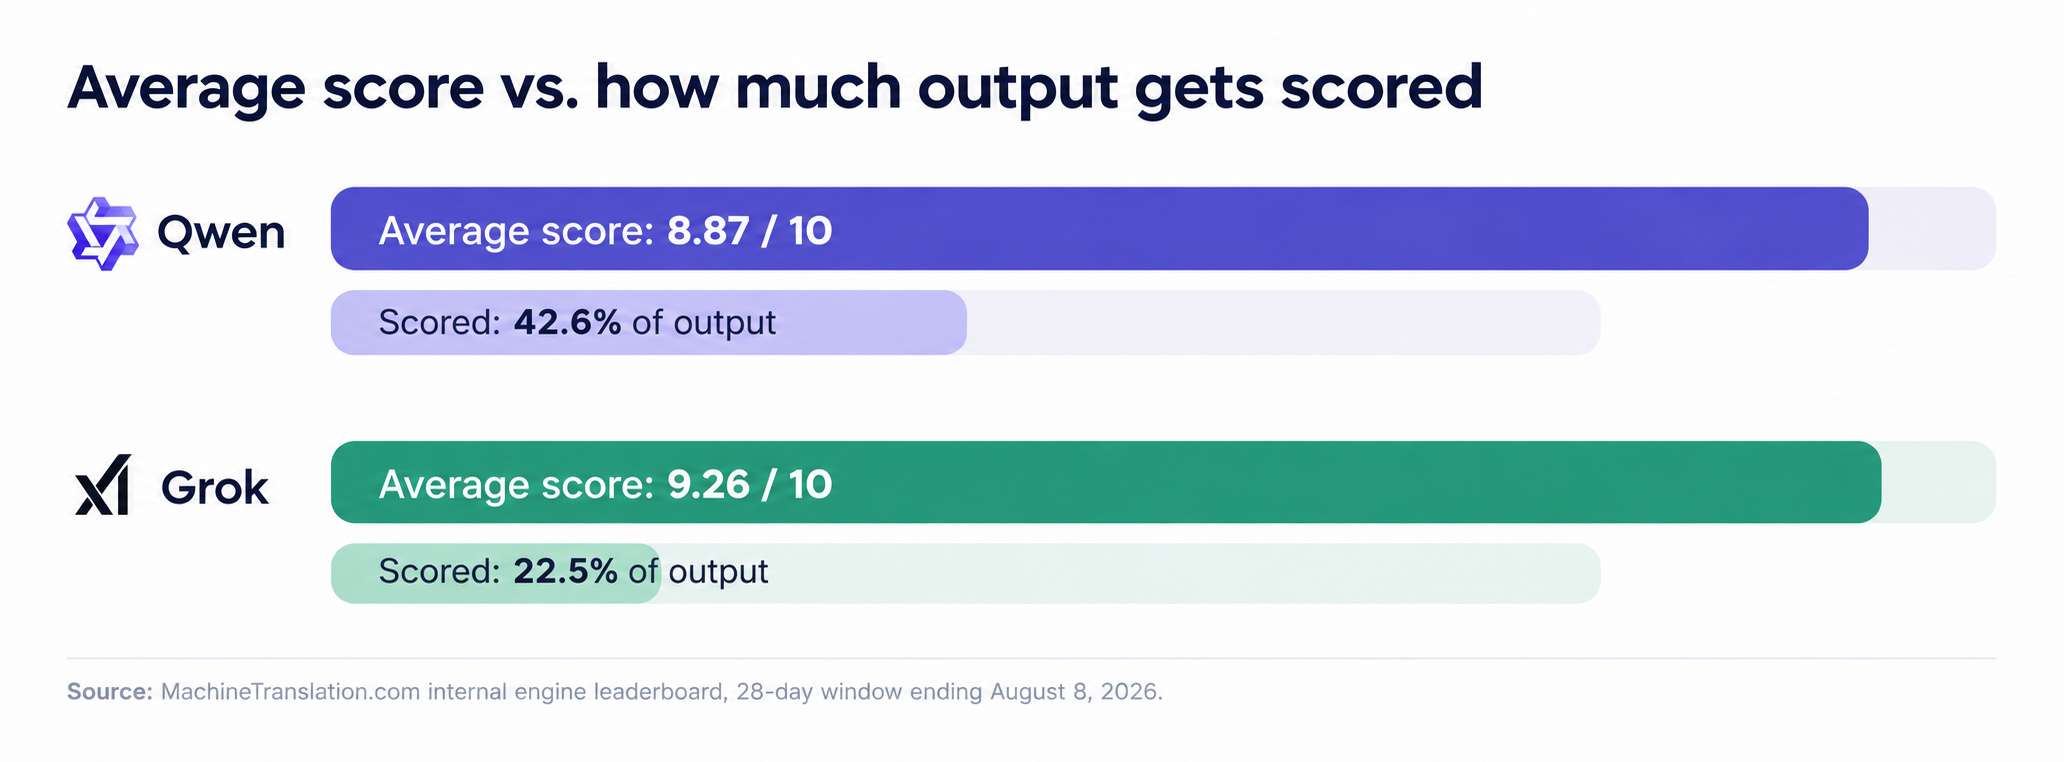
La puntuación promedio de Grok es más alta, pero se basa en la evaluación de menos de una cuarta parte de sus resultados, frente a casi la mitad en el caso de Qwen. Las dos barras cuentan partes diferentes de la misma historia.
| Qwen | Grok | |
|---|---|---|
| Porcentaje de resultados evaluados | 42.6% | 22.5% |
| Puntuación promedio | 8.87 / 10 | 9.26 / 10 |
| El 10% inferior de las puntuaciones | 7.6 | 9.2 |
Fuente: tabla de clasificación interna de motores de MachineTranslation.com, período de 28 días que finaliza el August 8, 2026.
¿Significa la puntuación más alta de Grok que es la mejor opción?
No por sí sola. Grok se utiliza con mucha menos frecuencia en la plataforma que Qwen, y menos de una cuarta parte de sus traducciones reciben puntuación, frente a casi la mitad de las de Qwen. Una muestra más pequeña y menos representativa puede hacer que un promedio parezca mejor o peor de lo que sería con el mismo volumen que ve Qwen. Los propios informes de MachineTranslation.com sobre estos datos tratan la cobertura de las puntuaciones como una limitación real, no como una nota al pie: un motor puntuado en una pequeña fracción de su tráfico no ha sido probado tan exhaustivamente como uno puntuado en casi la mitad de su producción.
La lectura honesta es que los números de Grok son prometedores pero más escasos. Los de Qwen son más bajos en promedio, pero se basan en una base mucho más grande y representativa. Ninguno de estos hechos anula al otro.
¿Qué pasa con la cobertura de idiomas?
Ni Qwen ni Grok publican una lista verificada de pares de idiomas en los que el rendimiento disminuye, y no existen pruebas independientes que confirmen alguna. Lo que se puede decir con confianza es que ninguno de los modelos fue creado en torno a la calidad de traducción en un conjunto de idiomas específico, como lo hace una plataforma de traducción dedicada. MachineTranslation.com prueba y admite más de 270 idiomas directamente, lo cual es una afirmación diferente a la capacidad multilingüe amplia pero no probada de un modelo de propósito general.
Cómo utiliza realmente MachineTranslation.com a Qwen y Grok
MachineTranslation.com ejecuta Qwen, Grok y más de otros 20 modelos de IA en cada traducción, y luego muestra la versión en la que más coinciden esos modelos. Ninguno de los modelos se excluye por tener una puntuación más baja en promedio. Ejecutar muchos modelos a la vez significa detectar los casos en los que un modelo con una puntuación media más baja acierta en una frase específica en la que un modelo con mayor puntuación falla. El rendimiento de Qwen también se divide por dirección y par de idiomas en formas que vale la pena conocer antes de elegir un solo modelo, lo cual se cubre con más profundidad en la comparación de Qwen vs DeepSeek de MachineTranslation.com. Para un análisis más detallado de cómo se prueban los modelos directamente entre sí, consulte las pruebas completas de comparación de modelos de MachineTranslation.com.
Preguntas frecuentes
1. ¿Es mejor Qwen o Grok para la traducción?
Según los propios datos de motores de 28 días de MachineTranslation.com, Grok obtiene en promedio una puntuación más alta que Qwen, 9.26 frente a 8.87 sobre 10. Pero Grok es evaluado en una porción mucho más pequeña y menos representativa de su producción, por lo que esto no es una comparación directa y justa de la forma en que lo sería una prueba de segmentos emparejados.
2. ¿Por qué Grok tiene una puntuación promedio más alta pero menos traducciones evaluadas?
Grok se usa con menos frecuencia en la plataforma y solo alrededor del 22.5% de su producción es evaluada, frente al 42.6% de Qwen. Una muestra más pequeña y menos representativa puede inflar o subestimar un promedio, por lo que esta comparación debe interpretarse como orientativa, no definitiva.
3. ¿Qwen o Grok admiten más idiomas?
Ambos son modelos de IA de propósito general sin una lista publicada y verificada de limitaciones específicas de idiomas. Ninguno de los dos está creado específicamente para la traducción, lo cual es diferente de una plataforma que prueba y evalúa directamente la calidad de la traducción en más de 270 idiomas, en lugar de depender de un amplio entrenamiento multilingüe como sustituto de un rendimiento de traducción medido.
4. ¿MachineTranslation.com compite con Qwen y Grok?
No. MachineTranslation.com ejecuta Qwen, Grok y más de 20 modelos de IA en cada traducción y muestra la versión en la que esos modelos más coinciden. Prueba y combina modelos como estos en lugar de competir contra ellos como si fuera un modelo independiente propio.
5. ¿Qué modelo de IA recomienda MachineTranslation.com para la traducción?
Ninguno por defecto. Los diferentes modelos se desempeñan de manera diferente según el par de idiomas y el tipo de contenido, y la brecha entre ellos puede inclinarse hacia un lado u otro dependiendo de lo que se esté traduciendo. Esa variación es exactamente la razón por la que la plataforma ejecuta múltiples modelos en cada traducción en lugar de elegir uno como recomendación permanente.