May 8, 2026
Grok vs. Claude tõlkimiseks: mida näitavad võrdlustestid (2026)
Grok (xAI) ja Claude (Anthropic) on mõlemad võimekad AI-tõlketööriistad, kuid neil on strukturaalselt erinevad tugevused. Enamiku üldiste tõlkeülesannete puhul ei märka te nende vahel olulist erinevust. Kahe konkreetse stsenaariumi puhul (hiljutisi sündmusi käsitleva sisu tõlkimine ja täpsust nõudvate ametlike dokumentide tõlkimine) on erinevus reaalne ja tuleneb sellest, kuidas kumbki mudel on üles ehitatud.
See artikkel käsitleb seda, mida kumbki mudel tegelikult tõlkimiseks pakub, kuhu sõltumatud võrdlustestid need paigutavad ja mida kasutada siis, kui kummagi mudeli enda väljundist ei piisa.
Kuidas Grok ja Claude tõlkekvaliteedi poolest võrreldavad on?
Lühike vastus: Claude on liider sõltumatutes professionaalse tõlke võrdlustestides. Grok'i konkreetne eelis on reaalajas juurdepääs teadmistele, mitte üldine tõlkekvaliteet.
MachineTranslation.com-i sisemistes võrdlustestides saavutab Claude (3.5 Sonnet tase) tõlkekvaliteedis — täpsus, terminoloogia ja stiil kombineerituna — skoori 93.8 punkti 100-st. Grok ei kuulu 14 parima lahenduse hulka Intento raportis „State of Translation Automation 2025“, mis hindas 46 masintõlkemootorit ja LLM-i 11 keelepaari lõikes. Claude Opus 4 ja Claude Sonnet 3.7 kuuluvad mõlemad top 14 hulka. Allikas: MachineTranslation.com sisesed võrdlustestid; Intento State of Translation Automation 2025.
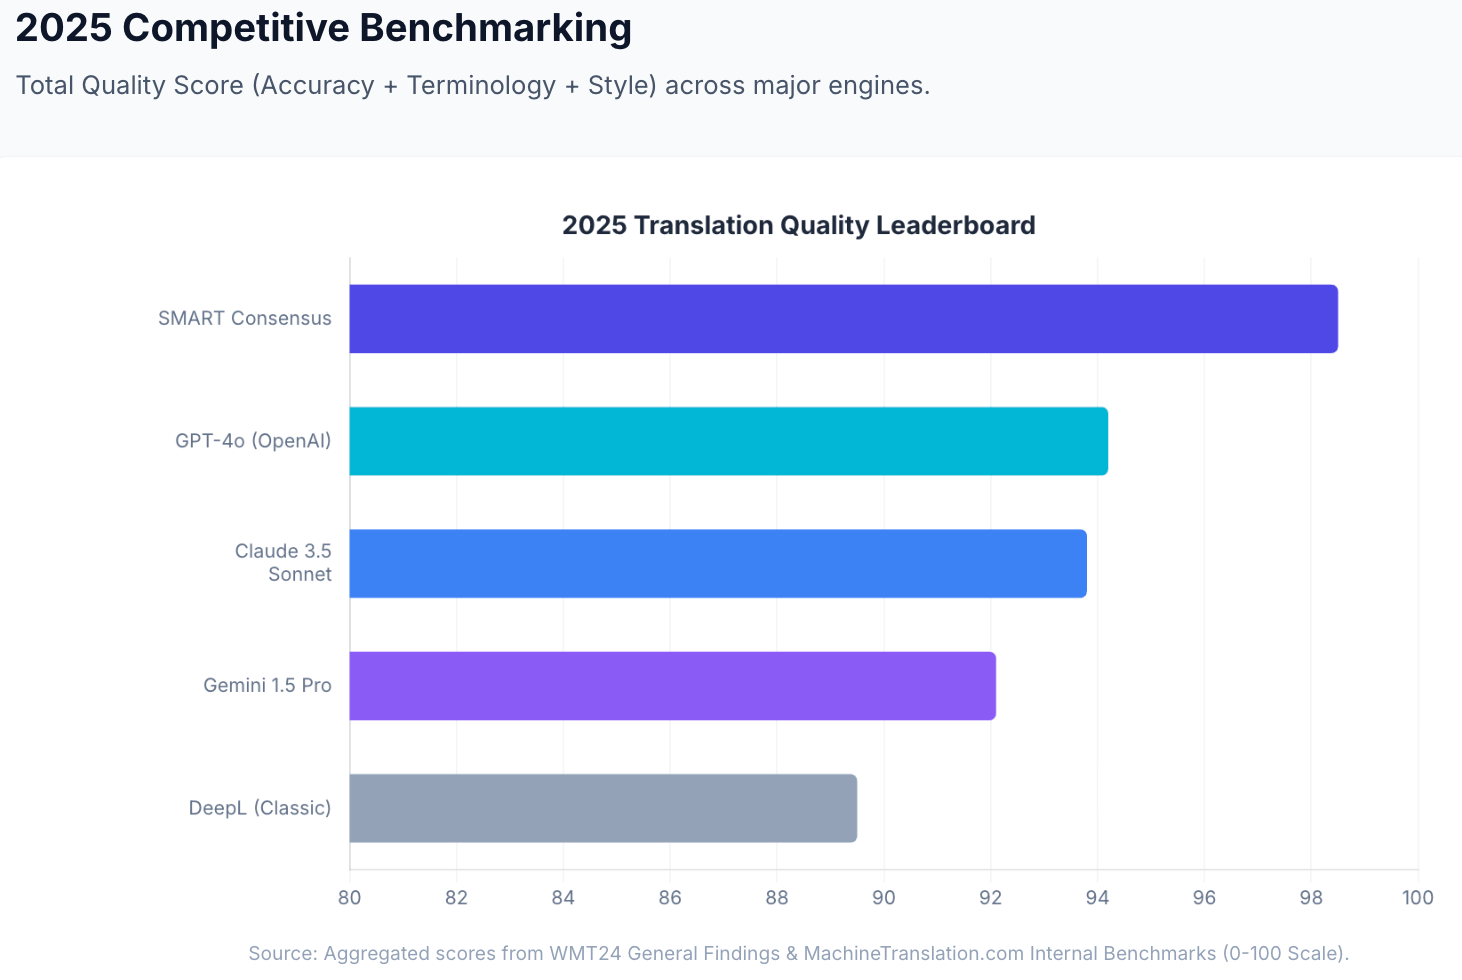
WMT24-l (tõlketööstuse peamisel sõltumatul võrdlustestide võistlusel) saavutas Claude 3.5 esikoha 9 keelepaaris 11-st, edestades GPT-4 ja spetsiaalseid neuraalseid masintõlkemootoreid. Lokalise'i 2025. aasta professionaalsete tõlkijate pimeuuringus hinnati 78% Claude 3.5 tõlgetest heaks — see on kõrgeim näitaja kõigi testitud LLM-ide seas.
Groki ei ole hinnatud WMT24-s ega Intento sõltumatus LQA-hindamises võrreldaval tasemel. The Slator Pro Guide (2025) loetleb Groki üheks üldotstarbeliseks LLM-iks, mida kasutatakse professionaalsetes keskkondades tõlkimiseks kõrvuti GPT ja Claude'iga, kuid ei hinda seda neist kumbastki kõrgemaks.
| Võrdlustest | Grok | Claude |
|---|---|---|
| MachineTranslation.com sisemine kvaliteediskoor | Pole võrdlustesti tasemel mõõdetud | 93.8/100 (3.5 Sonnet tase) |
| Intento 2025 14 parimat lahendust | Pole loetletud | Nii Claude Opus 4 kui ka Sonnet 3.7 on loetletud |
| WMT24 keelepaarid | Pole hinnatud | 1. koht 9/11 keelepaaris |
| Lokalise 2025 pimeuuring | Pole hinnatud | 78% hea (kõrgeim kõigist LLM-idest) |
Allikas: MachineTranslation.com-i sisesed võrdlustestid; Intento State of Translation Automation 2025; WMT24 üldised masintõlke tulemused; Lokalise 2025.
Kus on Grokil tõeline eelis?
Reaalajas ja päevakajaliste sündmuste tõlge. Groki määrav arhitektuuriline tunnus on selle integratsioon platvormi X (endine Twitter) andmete ja reaalajas internetiotsinguga. Erinevalt Claude'ist ja enamikust teistest LLM-idest, mida treenitakse staatilistel andmekogudel ja millel on fikseeritud teadmiste piirid, lõimib Grok oma väljunditesse reaalajas teavet. Tõlkeülesannete puhul, mis hõlmavad hiljutisi sündmusi, äsja välja antud tooteid, kujunevat poliitilist terminoloogiat, päevakajalisi uudiseid või sisu, mis viitab viimaste nädalate jooksul toimunule, on Grokil juurdepääs kontekstile, mis Claude'il puudub.
See on oluline eelkõige: hiljutisi sündmusi käsitlevate uudisteartiklite tõlkimisel, kiiresti muutuvate turgude tooteteadaannete lokaliseerimisel, sellise uue terminoloogia või slängi käsitlemisel, mis on tekkinud pärast teiste mudelite treeningandmete kogumist, ning mis tahes sisu puhul, mille tähendus sõltub hiljuti toimunu teadmisest.
Kujunev ja arenev terminoloogia. Tehnilised valdkonnad, tööstusharud ja kultuurikontekstid loovad pidevalt uut terminoloogiat. Tõlkeülesannete puhul, mis hõlmavad hiljuti loodud termineid, uut regulatiivset keelt või uut tootenomenklatuuri, annavad Groki uuendatud treening ja reaalajas otsing sellele juurdepääsu kasutusmustritele, mida vanemad treeningandmete hetktõmmised ei jäädvusta.
Grok 4.1 kontekstiaken ja arutlusvõime. Grok 4.1 (2025. aasta lõpu seisuga) sisaldab 131K tokeni suurust kontekstiakent ja täiustatud arutlusvõimet, mis teeb selle suutlikuks keerukate, mitmekihiliste dokumentide puhul, kus lauseosade vahelised seosed ja loogiline sidusus on olulised.
Kus on Claude'il tõeline eelis?
Tõlkekvaliteet sõltumatutes võrdlustestides. Claude'i eelis on dokumenteeritud pigem sõltumatu professionaalse hindamise kui iseenda esitatud väidetega. WMT24 reastas Claude 3.5 esikohale 9 keelepaaris 11-st kogu konkurentide seas. Lokalise'i 2025. aasta pimeuuringust selgus, et professionaalsed tõlkijad eelistasid Claude 3.5 väljundit 78%-lise hea määraga — mis on kõrgem kui GPT-4, DeepL ja Google Translate samas hindamises. Need on pimehindamised: professionaalsed tõlkijad hindasid väljundit, teadmata, milline mudel selle tootis.
Konkreetsed keelepaarid vastavalt Intento 2025-le. Claude Opus 4 ja Sonnet 3.7 kuuluvad Intento inimeste läbiviidud LQA-hindamises kategooriasse parim inglise-saksa, inglise-jaapani, inglise-itaalia, inglise-korea, inglise-hollandi, inglise-araabia ja inglise-prantsuse tõlkesuundade puhul. Nende paaride puhul on Claude neist kahest tugevam dokumenteeritud valik.
Tooni täpsus ja nüansseeritud sisu. Professionaalsed tõlkijad Lokalise uuringus eelistasid Claude'i väljundit kõigist LLM-idest enim — peegeldades Claude'i dokumenteeritud tugevust registri, autorihääle ja kontekstuaalse tähenduse säilitamisel. Ilukirjandusliku tõlke, juriidiliste dokumentide, ametliku suhtluse ja turundustekstide puhul, kus see, kuidas midagi öeldakse, on sama oluline kui see, mida öeldakse, saavutab Claude sõltumatutes hindamistes järjepidevalt häid tulemusi.
Pikkade dokumentide sidusus. Claude 4.6 Sonnet toetab 200K tokeni suurust kontekstiakent, kusjuures Claude Opus 4.6 toetab beetaversioonis 1M tokenit. Pikkade ametlike dokumentide puhul (lepingud, tehnilised juhendid, kliiniliste uuringute aruanded) suudab Claude töödelda kogu dokumenti ühe korraga, säilitades läbivalt terminoloogia ühtsuse. Fragmentidena töödeldud dokumendid näitavad 28% suuremat terminoloogilise ebakõla määra võrreldes tervikdokumendi töötlemisega. Allikas: MachineTranslation.com siseandmed.
Kuidas nad võrdlevad keeletoe ja hinnakujunduse poolest?
Keeletugi: Nii Grok 4.1 kui ka Claude 4.6 toetavad tõlkimist enamikus maailma suuremates keeltes. Claude'i on sõltumatult hinnatud Euroopa ja Ida-Aasia keelepaaride lõikes tugevate tulemustega. Groki mitmekeelne tugi on järjestikuste versioonide jooksul paranenud. Vähese ressursiga keelte puhul langeb mõlema mudeli kvaliteet — inimkontroll on asjakohane vähese ressursiga keelpaaride sisu puhul, olenemata sellest, millist mudelit kasutatakse.
Hinnakiri:
| Pakett | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Tavatarbija (kuus) | SuperGrok: $30/kuu | Claude Pro: $20/kuu |
| API sisend (M tokeni kohta) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| API väljund (M tokeni kohta) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Tasuta pakett | Jah (piirangutega X/Grok.com kaudu) | Jah (piirangutega claude.ai kaudu) |
Tavatarbija tasemel on Claude Pro ($20/month) is cheaper than SuperGrok ($30/kuu). API tasemel on Grok 4.1-l väike kulueelis Claude Sonnet 4.6 ees suure sisendmahuga tõlketöövoogude puhul.
Kumb on parem konkreetsete sisutüüpide puhul?
| Sisutüüp | Soovitatav mudel | Põhjus |
|---|---|---|
| Värsked uudised / päevasündmused | Grok | Reaalajas juurdepääs andmetele; staatiliselt treenitud mudelitel puudub ajakohane kontekst |
| Uus terminoloogia / uute toodete turuletoomised | Grok | Otseotsingu integratsioon tuvastab hiljutised kasutusmustrid |
| Ametlikud juriidilised dokumendid | Claude | WMT24 ja Lokalise 2025 sõltumatu hindamine; tooni täpsus |
| Meditsiiniline / kliiniline sisu | Claude | Positsioon sõltumatutes võrdlustestides; registri säilitamine |
| Turundustekstid / loovsisu | Claude | Eelistus Lokalise 2025 pimeuuringus; tonaalsuse nüansid |
| Tehniline dokumentatsioon (pikk) | Claude | 200K-1M kontekstiaken; terminoloogia järjepidevus kogu pikkuses |
| Sotsiaalmeedia / vestluslik sisu | Mõlemad | Mõlemad tulevad hästi toime suure ressurssiga vestluspaaridega |
| Arendaja / API integratsioon | Mõlemad | Mõlemad pakuvad API-juurdepääsu; Grok on sisendtokenite osas veidi odavam |
Mida kasutada, kui ühest mudelist ei piisa
Nii Grok kui ka Claude on ühe mudeli tööriistad. Iga üksik AI-mudel (sõltumata sellest, kui võimekas see on) teeb vigu, mida see ei suuda omaenda väljundis tuvastada. Sujuv ja enesekindel tõlge kas Grokilt või Claudelt võib sellegipoolest olla semantiliselt vale ning ilma ristkontrollita pole seda kuidagi võimalik teada.
Nii Grok kui ka Claude kuuluvad MachineTranslation.com-i SMART-süsteemi 22 mudeli hulka. SMART käitab kõiki 22 mudelit samaaegselt (sealhulgas Grok ja Claude) ning tagastab väljundi, millega enamus nõustub.
Mida see tähendab Grok vs. Claude küsimuse jaoks: Groki reaalaja tugevus ja Claude'i kontekstuaalne sügavus panustavad mõlemad samasse konsensusesse. Kui nad nõustuvad, on see nõustumine tugev kvaliteedisignaal.
MachineTranslation.com-i sisemistes võrdlustestides saavutavad üksikud tipptaseme mudelid tõlkekvaliteedis tulemuseks 93–94 punkti 100-st. SMART-i konsensuse väljund ulatub 98.5/100-ni. Allikas: MachineTranslation.com sisesed võrdlustestid ja WMT24 üldise masintõlke tulemused.
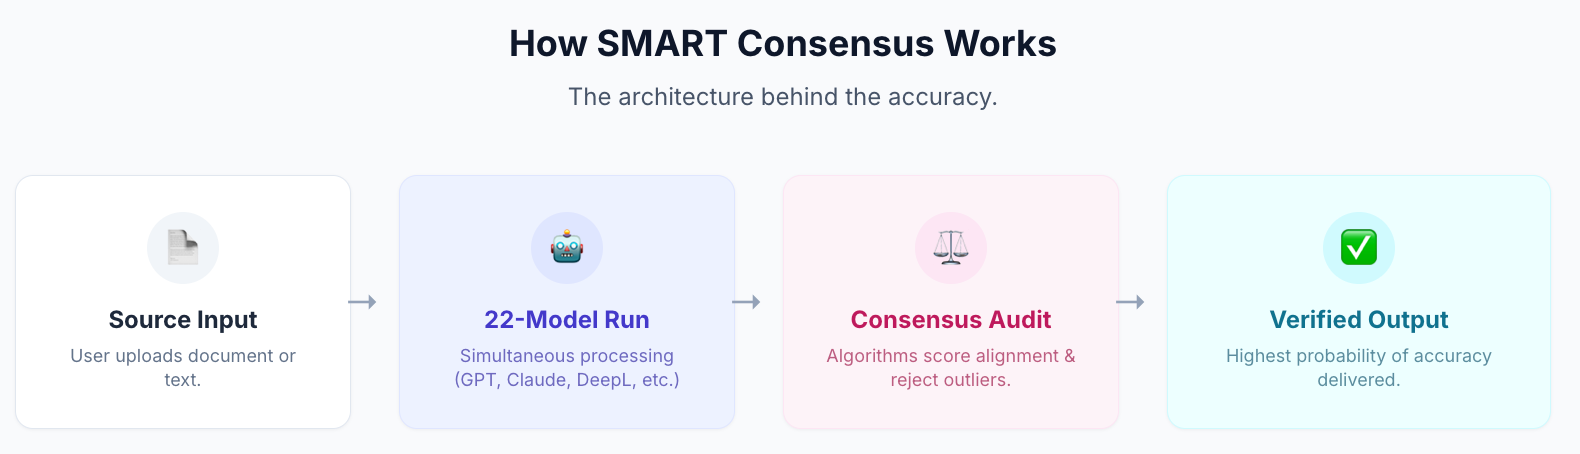
Kasutajad, kes läksid ühe tõlkemootoriga tõlkelt üle SMART-ile, kulutasid 27% vähem aega väljundite kontrollimisele ja parandamisele. Allikas: MachineTranslation.com siseandmed.
Kriitilise tähtsusega sisu (juriidilised dokumendid, regulatiivsed dokumendid, meditsiinilised juhised) puhul suunab Human Verification SMART-konsensuse edasi sertifitseeritud professionaalsele ülevaatajale samal platvormil. Välisagentuur puudub. 100% täpsus garanteeritud.
Tõlgi mudelitega Grok, Claude ja veel 20 teist mudelit aadressil MachineTranslation.com — tasuta, registreerimist ei nõuta.
Korduma kippuvad küsimused
1. Kas Grok on tõlkimises parem kui Claude?
Enamiku standardsete tõlkeülesannete puhul on Claude sõltumatutes võrdlustestides esikohal: esimesel kohal 9 keelepaaris 11-st WMT24-l, 78% hea hinnang Lokalise'i 2025. aasta pimeuuringus ja 93.8/100 MachineTranslation.com-i sisemistes kvaliteedi võrdlustestides. Groki konkreetne eelis on sisu puhul, mis nõuab teadmisi päevakajalistest sündmustest, selle reaalajas juurdepääs andmetele annab sellele konteksti, mida staatiliselt treenitud mudelitel, sealhulgas Claude'il, ei ole. Värskete uudiste, tekkiva terminoloogia ja ajatundliku sisu puhul on Grok tugevam valik.
2. Mis on Groki eelis Claude'i ees tõlkimisel?
Grok integreerib reaalajaandmeid X-ist (endine Twitter) ja reaalajas internetiotsingut. Erinevalt Claude'ist ja enamikust teistest staatilistel andmekogudel treenitud LLM-idest, pääseb Grok tõlgete genereerimisel ligi teabele hiljutiste sündmuste, äsjaloodud terminoloogia ja praeguse konteksti kohta. See muudab selle eriti tugevaks uudiste sisu, hiljuti välja lastud toodete ja mis tahes materjali tõlkimisel, mille tähendus sõltub viimase paari nädala sündmustest või keelemustritest.
3. Mis on Claude'i eelis Groki ees tõlkimisel?
Claude'i eelis on dokumenteeritud sõltumatu professionaalse hindamise kaudu. Claude 3.5 saavutas esikoha 9-s 11-st keelepaarist WMT24-l ning professionaalsed tõlkijad Lokalise 2025. aasta pimeuuringus eelistasid selle väljundit 78%-lise hea määraga — mis on kõrgeim kõigi testitud LLM-ide seas. Claude on samuti esindatud Intento 14 parima lahenduse hulgas mitme keelepaari lõikes inimeste teostatud LQA-hindamises, samas kui Grok mitte. Formaalsete, professionaalsete ja kõrgete panustega tõlkeülesannete puhul on Claude'i sõltumatu võrdlustestide positsioon dokumenteeritud eristajaks.
4. Kumb on õigustõlkeks parem, Grok või Claude?
Claude on sõltumatu hindamise põhjal õigustõlkeks tugevam valik. Claude 3.5 saavutas WMT24-l esikoha enamikus suure ressursiga Euroopa keelepaarides ja sai professionaalsetelt tõlkijatelt kõrgeimad pimeuuringu eelistushinnangud. Sertifitseeritud täpsust nõudva juriidilise sisu puhul ei ole kumbki mudel üksi piisav — MachineTranslation.com-i Human Verification tagab 100% täpsuse sertifitseeritud professionaalselt ülevaatajalt samal platvormil, ilma et oleks vaja välist tarnijat.
5. Kas nii Grok kui ka Claude on saadaval lehel MachineTranslation.com?
Jah. Mõlemad kuuluvad MachineTranslation.com-i SMART-süsteemi 22 mudeli hulka. Iga SMART-tõlge käitab samaaegselt Groki, Claude'i ja veel 20 mudelit, tagastades väljundi, millega enamus nõustub. Selle asemel, et nende vahel valida, saate kõigi AI-mudelite konsensuse.
6. Kuidas Grok ja Claude hindade poolest võrreldavad on?
Tavatarbija tasemel maksab Claude Pro $20/month versus SuperGrok at $30/kuus. API tasemel on Grok 4.1 veidi odavam sisendtokenite ($2/M vs. $3/M Claude Sonnet 4.6 puhul) ja väljundi ($10/M vs. $15/M) osas. MachineTranslation.com-i tasuta pakett sisaldab mõlemat mudelit osana SMART-i 22 mudeli konsensusest, registreerumine pole vajalik.
7. Milline AI-mudel on parim uudisteartiklite tõlkimiseks?
Uudisteartiklite tõlkimisel on Grokil struktuurne eelis: selle reaalajas andmeintegratsioon tähendab, et sellel on ajakohane kontekst kirjeldatavate sündmuste kohta, mis staatiliselt treenitud mudelitel võib puududa. Üldise uudistetõlke puhul, kus ajakohasus ei ole kriitiline, on Claude'i võrdlustestide tulemuslikkus tugevam. Suuremahulise uudiste tõlkimise puhul, kus on olulised nii ajakohasus kui ka täpsus, käivitab MachineTranslation.com-i SMART mõlemad mudelid ja tagastab nende konsensusliku väljundi.