November 13, 2026
Qwen vs Gemini tõlkimisel ja miks suund on oluline
Teil on kaks mudelit ja loend keelepaaridest ning te peate otsustama, millist mudelit oma projekti puhul usaldada. Enamik Qwen vs Gemini võrdlusi annab vastuseks ühe koondhinde. Minu arvates varjab üks hinne seda, mis tulemuse tegelikult otsustab, nimelt tõlkesuunda.
Töötan selle kallal, kuidas me testime platvormil MachineTranslation.com töötavaid mudeleid, seega saan võrrelda mudeleid Qwen ja Gemini 98 keelepaaris, mida hinnati identse teksti põhjal. Gemini sai kõrgema hinde neist 68 paaris ja Qwen 29 paaris ning keskmine vahe on 0,08 punkti 10-st. Ainult koondtulemused ei ütle teile, millist mudelit valida urdu keelest inglise keelde või inglise keelest haiti kreooli keelde tõlkimiseks.
See artikkel näitab, kus need kaks mudelit on tasavägised ja kus kumbki juhib. Samuti räägib see sellest, mida ma veel öelda ei saa. Minu andmed lõppevad 8. augustil 2026, enne kui Google teatas oktoobris mudelist Gemini 4, mistõttu kirjeldavad need mõlema mudeli varasemaid versioone.
Peamised järeldused
- Kõigist 98 keelepaarist, mida hinnati identse teksti põhjal (12. juulist kuni 8. augustini 2026), sai Gemini kõrgema hinde 68 paaris, Qwen 29 paaris ja üks paar jäi viiki.
- Keskmine vahe on väike, Geminil 9,06 punkti ja Qwenil 8,98 punkti, ning 60 paari 98-st jäävad 0,1 punkti piiridesse.
- Inglise keelde tõlkimisel juhib Qwen rohkem kui 0,1 punktiga 7 paaris 27-st ja Gemini 3 paaris; ülejäänud 17 paari jäävad 0,1 punkti piiridesse.
- Inglise keelest tõlkimisel juhib Gemini rohkem kui 0,1 punktiga 13 paaris 29-st ja Qwen mitte üheski.
- Andmed lõppevad enne seda, kui Google teatas 2026. aasta oktoobris mudelist Gemini 4, seega kirjeldavad need Gemini varasemaid versioone ning vajavad uut testimist, enne kui keegi saab neid pidada ajakohaseks.
Kas tõlkimiseks on parem Qwen või Gemini?
See sõltub suunast, sest need kaks mudelit on tasavägised, kui sihtkeel on inglise keel, ning Gemini saab kõrgema hinde enamikus muudes paarides. Kõigist 98 paarist sai Gemini kõrgema tulemuse 68 paaris. MachineTranslation.com tulemustes vahemikus 12. juulist kuni 8. augustini 2026 oli Gemini keskmine tulemus 9,06 punkti 10-st ja Qwenil 8,98, mis teeb keskmiseks vaheks 0,08 punkti.
Valim arvestab ainult segmente, kus ChatGPT, Claude, DeepSeek, Gemini ja Qwen said kõik tegeliku hinde, mistõttu hinnatakse iga mudelit identse lähteteksti põhjal. Igas keelepaaris on vähemalt 30 segmenti. Kasutan seda valimit, sest see välistab levinud vea, milleks on mudelite võrdlemine erinevate tekstide põhjal.
Paaride arvu järgi juhib Gemini 68 paaris (69%), Qwen 29 paaris (30%) ja üks paar on viigis. Ainult paaride arv liialdab vahe suurusega, sest 60 paari 98-st jäävad 0,1 punkti piiridesse. Järgmised jaotised jagavad tulemused suuna ja punktivahe järgi.
Millised tõlkesuunad sobivad kummalegi mudelile?
Gemini juhib siis, kui inglise keel on lähtekeel või kui kumbki keel pole inglise keel, ning Qwen on sellega samal tasemel või ees, kui sihtkeeleks on inglise keel. Inglise keelest tõlkimisel juhib Gemini rohkem kui 0,1 punktiga 13 paaris 29-st ja Qwen mitte üheski. Inglise keelde tõlkimisel juhib Qwen selle vahega 7 paaris 27-st ja Gemini 3 paaris.
| Suund | Paarid | Gemini juhib rohkem kui 0,1 võrra | 0,1 punkti piires | Qwen juhib rohkem kui 0,1 võrra | Keskmine vahe |
|---|---|---|---|---|---|
| Inglise keelde | 27 | 3 | 17 | 7 | Qwen +0,04 |
| Inglise keelest | 29 | 13 | 16 | 0 | Gemini +0,16 |
| Kumbki keel pole inglise keel | 42 | 14 | 27 | 1 | Gemini +0,13 |
Inglise keelde tõlkimisel jäävad 27 paarist 17 paari 0,1 punkti piiridesse, Qwen juhib 7 ja Gemini 3 paaris. Inglise keelest tõlkimisel jäävad 29 paarist 16 paari 0,1 punkti piiridesse, Gemini juhib 13 paaris ja Qwen mitte üheski. Kui kumbki keel pole inglise keel, jäävad 42 paarist 27 paari 0,1 punkti piiridesse, Gemini juhib 14 ja Qwen 1 paaris.
Qwen jääb Gemini suhtes 0,1 punkti piiridesse või juhib 24 paaris 27-st inglise keelde tõlgitavast paarist. Suuna lõikes keskmistatult on Qwen inglise keelde tõlkimisel ees umbes 0,04 punktiga, samal ajal kui Gemini juhib inglise keelest tõlkimisel umbes 0,16 punktiga ja kahe mitteingliskeelse keele vahel 0,13 punktiga.
Ma ei tea, miks selline erinevus tekib, ja need andmed ei anna sellele vastust. Üks selgitus, mida ma esimesena kontrolliksin, on iga mudeli taga olev treeningtekstide kooslus, kuid ma ei ole seda katset teinud. Qwen näitab ChatGPT suhtes sarnast mustrit. Samal valimil leidis meie Qwen vs ChatGPT võrdlus, et inglise keelde tõlkimisel olid need kaks peaaegu võrdsed, kusjuures ChatGPT oli ees 89% ülejäänud paaridest.
Milliste keelepaaride puhul on vahed kõige suuremad?
Kõige suuremad vahed räägivad Gemini kasuks. See juhib 0,51 kuni 0,95 punktiga paarides vene keelest kasahhi keelde, inglise keelest haiti kreoolkeelde, inglise keelest tagalogi keelde, hispaania keelest kreeka keelde ja araabia keelest pärsia keelde. Qweni suurimad edumaad on väiksemad, jäädes 0,15 ja 0,26 punkti vahele, ning neli selle viiest parimast on paarid inglise keelde.
| Keelepaar | Gemini skoor | Qwen skoor | Vahe |
|---|---|---|---|
| Vene keelest kasahhi keelde | 9,27 | 8,32 | Gemini +0,95 |
| Inglise keelest haiti kreooli keelde | 9,19 | 8,27 | Gemini +0,92 |
| Inglise keelest tagalogi keelde | 9,14 | 8,43 | Gemini +0,70 |
| Hispaania keelest kreeka keelde | 8,90 | 8,33 | Gemini +0,57 |
| Araabia keelest pärsia keelde | 8,84 | 8,34 | Gemini +0,51 |
| Urdu keelest inglise keelde | 8,56 | 8,81 | Qwen +0,26 |
| Hiina keelest inglise keelde | 9,00 | 9,19 | Qwen +0,19 |
| Rootsi keelest inglise keelde | 8,29 | 8,46 | Qwen +0,16 |
| Hiina keelest indoneesia keelde | 9,03 | 9,19 | Qwen +0,16 |
| Birma keelest inglise keelde | 8,94 | 9,09 | Qwen +0,15 |
Ma ei käsitleks neid lõplike pingeridadena. Kaks suurimat vahet, vene keelest kasahhi keelde ja inglise keelest haiti kreoolkeelde, põhinevad mediaanpaarist väiksematel valimitel. Inglise keelest tagalogi keelde, hispaania keelest kreeka keelde ja araabia keelest pärsia keelde põhinevad suurematel, mistõttu usaldaksin neid kolme rohkem. Testiksin neid kahte väikese valimiga vahet uuesti, enne kui neile toetun.
Mida tähendab 0,1 punkti suurune vahe?
Minu hinnangul on alla 0,1 punkti suurune vahe liiga väike, et võitjat välja kuulutada. 98 paarist 60 jääb selle piiri sisse ja iga paari hinnatakse piiratud arvu segmentide põhjal. 0,1 piir on minu enda töölävi ning ma ei ole nende paaride puhul olulisustesti teinud.
Hinne ei peegelda samuti kõiki erinevusi. Meie levinud fraaside testides lasime araabiakeelse sõna "sorry" läbi 22 AI mudeli. Nii Gemini kui ka Qwen valisid vaba väljenduse آسف. ChatGPT ja koondtulemus valisid ametliku väljenduse عذرًا. Iga mudel sai tulemuseks 9,5, seega erinevad need kaks sõna registri poolest ja hinne ei muutunud.
Seetõttu vaatangi marginaali ja registrinäiteid koos. Väike vahe koos märgatava registrierinevusega nõuab inimese otsust. Suur vahe väikese valimi põhjal vajab uuesti testimist.
Kas Qwen ja Gemini teevad erinevat tüüpi vigu?
Jah, sest meie 2026. aasta maailmameistrivõistluste tsitaaditestis tegid mõlemad mudelid vähemalt ühe valiku, mida teised mudelid ei teinud, ja hinded peaaegu ei muutunud. Gemini tõlkis Mbappé fraasi kui "with each game" ja tõlkis Wirtzi tsitaadi sõna-sõnalt, samal ajal kui Qwen andis Scaloni tsitaadile teistsuguse tõlgenduse. Nende juhtumite hinded jäid vahemikku 9,2 kuni 9,5.
Üksikasjad pärinevad meie maailmameistrivõistluste tsitaaditestist. Mbappé tulevikku vaatava tsitaadi puhul jätsid teised mudelid alles sõna "match", samal ajal kui Gemini kirjutas "with each game", mis oli väike registrivääratus ja sai hindeks 9,4. Wirtzi tsitaadi puhul tõlkis Gemini fraasi sõna-sõnalt ja muutis tähendust, saades samuti 9,4. Scaloni tsitaadi puhul jõudis enamik mudeleid ühele ja samale tõlgendusele, samal ajal kui Qwen kirjutas "that is what matters" ja sai hindeks 9,4. Mbappé taktikalise tsitaadi puhul valisid Claude ja DeepSeek Briti jalgpalliinglise keele, samas kui Gemini, Qwen ja teised valisid Ameerika inglise keele, ning Qwen sai tulemuseks 9,2, mis oli madalam kui ülejäänutel.
Mina tõlgendan neid kui väikseid harjumusi. Gemini näited puudutavad registrit ja sõnasõnalist sõnastust. Qweni omad puudutavad seda, milline lause tõlgendus valida. Neli näidet on liiga vähe, et seda mustriks nimetada, kuid need näitavad, milliseid erinevusi üksainus hinne varjata võib.
Milline Qweni mudel on tõlkimiseks parim?
Meie andmete põhjal ei saa ma seda öelda, sest MachineTranslation.com-i hinded käsitlevad Qweni ühe mudelina ilma versioonimärgiseta. Alibaba Qwen3.8 perekond jõudis Hugging Face'i 2026. aasta augustis, seega eksisteerib nüüd mitu versiooni ning selles artiklis toodud hinded neid ei erista.
Tahaksin seda versioonide kaupa eristada, kuid praegu ma seda veel teha ei saa. Platvormi taseme number võib olla selle ajavahemiku jooksul töötanud mitme Qweni versiooni keskmine. Kui valite projekti jaoks Qweni versioonide vahel, soovitaksin neid võrrelda omaenda teksti näidisel.
Millised on mõned alternatiivid Geminile tõlkimisel?
ChatGPT, Claude, DeepSeek, Qwen, Grok ja Mistral AI töötavad kõik keskkonnas MachineTranslation.com ning õige alternatiiv sõltub paarist. Meie 12. juuli kuni 8. augusti 2026 tulemustes on Qwen inglise keele suunal 27 paarist 24 puhul Geminist 0,1 punkti raadiuses või ees. Meie Mistral AI prantsuse keele tulemused näitavad, et selle prantsuse keelest inglise keelde keskmine on 0,40 punkti võrra kõrgem kui Geminil.
Kui teie alternatiiviks on ChatGPT, jaguneb vastus samuti paaride kaupa. Meie avaldatud hispaania keelest inglise keelde jaotuses võitis Gemini 31% segmentidest ja ChatGPT 21%. Prantsuse keele puhul ei võida kumbki mudel mõlemas suunas. Kuna valik sõltub paarist, ei vali MachineTranslation.com ühte kindlat alternatiivi. See käitab neid koos.
Minu soovitus on alustada paarist ja suunast ning seejärel vaadata, milline alternatiiv sobib.
Kuidas näitab MachineTranslation.com, kus Qwen ja Gemini on eriarvamusel?
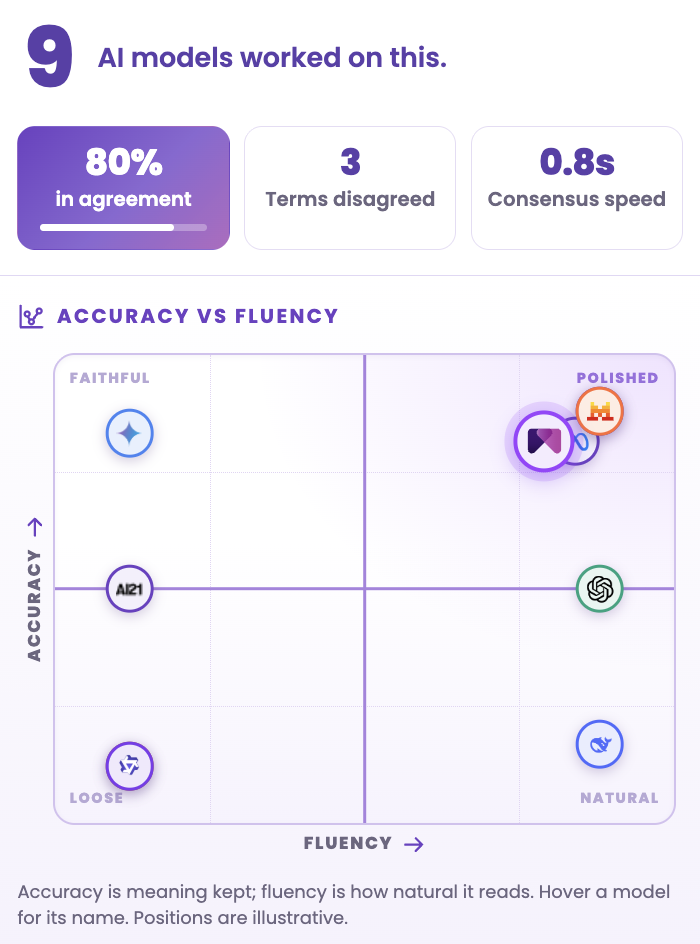
MachineTranslation.com käitab mõlemat mudelit igal tõlkel ning näitab, kus mudelid nõustuvad ja kus nende arvamused lahknevad. Üksmeelepaneel annab teada, mitu tehisintellekti mudelit tekstiga töötas, kui suur osa oli ühel meelel, mitu terminit olid vaidlusalused ja kui kiiresti konsensus saavutati.
Kui ajakohased need tulemused on?
Need tulemused hõlmavad ajavahemikku 12. juulist kuni 8. augustini 2026, seega kirjeldavad need sel ajal töötanud Gemini ja Qweni versioone. Google teatas Gemini 4 tulekust 2026. aasta oktoobris. Alibaba Qwen3.8 mudelipere saabus 2026. aasta augustis. Minu soovitus on enne uue projekti jaoks nendele numbritele toetumist paneel uuesti käivitada.
Eeldan, et identse teksti võrdlemise meetod koos müradiferentsiga peab paika. Ootan, et vahede suurus muutub. Käsitleksin iga paari, kus liider uuel käitamisel vahetub, märgina sellest, et varasem vahe jäi müra piiridesse.
Kuidas ma valiksin projekti jaoks Qweni ja Gemini vahel?
Minu seisukoht on valida paari ja suuna järgi ning vältida ühe valiku tegemist kogu projekti jaoks. Praktikas tähendab see alla 0,1 punkti jääva vahe käsitlemist viigina ja arvestamist, et juhtiv mudel eri paaride vahel muutub. See on järjekord, mida ma järgiksin.
- Pange kirja iga projektis olev keelepaar ja märkige selle suund.
- Kontrollige iga paari vahet selles artiklis. Käsitlege alla 0,1 punkti suurust vahet viigina.
- Seal, kus vahe on suurem, alustage juhtiva mudeliga ja katsetage oma teksti näidisega.
- Kui teie sisu liigub mõlemas suunas, arvestage, et liider võib paaride lõikes muutuda.
- Kontrollige uuesti, kui kumbki mudel annab välja uue versiooni.
Mõlemad mudelid töötavad platvormil MachineTranslation.com iga tõlke puhul kõrvuti 20 teisega. Tagastatakse versioon, millega enamik neist nõustub, seega ei pea valikut tegema korraga terve projekti jaoks. Täielik mudelitulemuste komplekt asub meie mudelite võrdlustestides.
Korduma kippuvad küsimused
1. Kas tõlkimiseks on parem Qwen või Gemini?
See sõltub suunast, sest Qwen on Geminiga 0,1 punkti piires või eespool 24 paari puhul 27-st suunal inglise keelde. Gemini sai siiski kõrgema skoori 68 paari puhul 98-st MachineTranslation.com-i 12. juuli kuni 8. augusti 2026 tulemustes. Keskmine vahe on 0,08 punkti 10-st, seega valiksin paari järgi.
2. Milline Qweni mudel on tõlkimiseks parim?
Meie andmete põhjal ei saa seda öelda, sest MachineTranslation.com-i tulemused käsitlevad Qweni ühe mudelina ilma versioonimärgiseta. Alibaba Qwen3.8 perekond jõudis keskkonda Hugging Face 2026. aasta augustis, seega on nüüd olemas mitu versiooni. Kuni tulemused neid ei erista, võrdleksin enne projekti jaoks valimist versioone oma teksti näidisel.
3. Millised on mõned alternatiivid Geminile tõlkimiseks?
ChatGPT, Claude, DeepSeek, Qwen, Grok ja Mistral AI töötavad kõik platvormil MachineTranslation.com. Meie 12. juuli kuni 8. augusti 2026 tulemustes on Qwen Geminiga 0,1 punkti piires või eespool 24 paari puhul 27-st suunal inglise keelde. Mistral AI keskmine suunal prantsuse keelest inglise keelde oli 0,40 punkti võrra kõrgem kui Geminil. Õige alternatiiv sõltub paarist.
4. Kas Gemini on tõlkimiseks parem kui ChatGPT?
See sõltub keelepaarist, sest ükski tehisintellekti mudel ei võida igal pool. Meie avaldatud jaotuses hispaania keelest inglise keelde võitis Gemini 31% segmentidest ja ChatGPT 21%. Prantsuse keele puhul ei võida kumbki mudel mõlemas suunas. Enne nende vahel valimist kontrolliksin vajalikku paari ja suunda.
5. Kas Gemini on tõlkimisel täpne?
Jah, sest Gemini sai MachineTranslation.com-i July 12 to August 8, 2026 tulemustes 98 keelepaari lõikes keskmiselt 9,06 punkti 10-st. Täpsus varieerub siiski paariti. Selle edumaa on suurim inglise keelest tõlkimisel ja Qwen on sellest enam kui 0,1 punkti võrra ees 7 paaris 27-st inglise keelde.