May 8, 2026
Grok vs. Claude kääntämisessä: mitä vertailutestit osoittavat (2026)
Grok (xAI) ja Claude (Anthropic) ovat molemmat kyvykkäitä AI-käännöstyökaluja, mutta niillä on rakenteellisesti erilaiset vahvuudet. Useimmissa yleisissä käännöstehtävissä et huomaa merkittävää eroa niiden välillä. Kahden erityisen skenaarion kohdalla (ajankohtaisia tapahtumia koskevan sisällön kääntäminen ja tarkkuutta vaativien virallisten asiakirjojen kääntäminen) ero on todellinen ja perustuu siihen, miten kukin malli on rakennettu.
Tässä artikkelissa käsitellään sitä, mitä kukin malli todellisuudessa tarjoaa kääntämiseen, mihin riippumattomat vertailutestit ne asettavat ja mitä käyttää silloin, kun kummankaan mallin tuotos yksistään ei riitä.
Miten Grok ja Claude vertautuvat toisiinsa käännöslaadussa?
Lyhyt vastaus: Claude on kärjessä riippumattomissa ammattimaisen kääntämisen vertailutesteissä. Grokin erityinen etu on reaaliaikainen pääsy tietoon, ei yleinen käännöslaatu.
MachineTranslation.comin sisäisissä vertailutesteissä Claude (3.5 Sonnet -taso) saa käännöslaadusta 93.8 pistettä 100:sta — tarkkuus, terminologia ja tyyli yhdistettynä. Grok ei esiinny 14 parhaan ratkaisun joukossa Intenton State of Translation Automation 2025 -raportissa, jossa arvioitiin 46 MT-moottoria ja LLM-mallia 11 kieliparissa. Claude Opus 4 ja Claude Sonnet 3.7 löytyvät molemmat 14 parhaan joukosta. Lähde: MachineTranslation.comin sisäiset vertailutestit; Intento State of Translation Automation 2025.
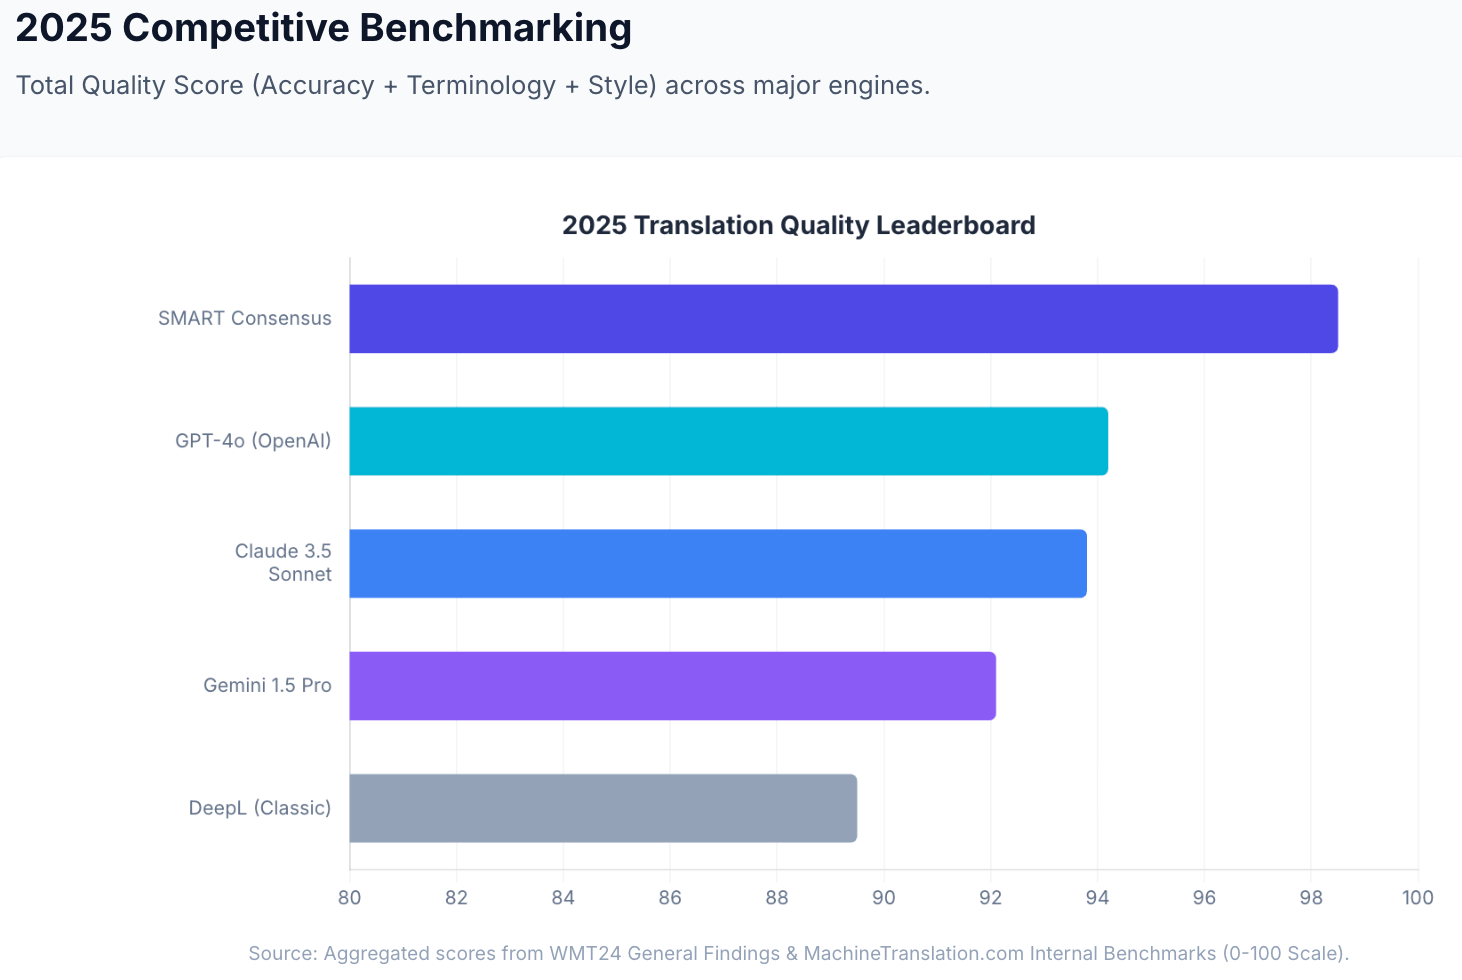
WMT24:ssä (käännösalan tärkeimmässä riippumattomassa vertailukilpailussa) Claude 3.5 sijoittui ensimmäiseksi 9:ssä 11 kieliparista, ohittaen GPT-4:n ja erikoistuneet neuroverkkokonekäännösmoottorit. Lokalisen ammattikääntäjien tekemässä vuoden 2025 sokkotutkimuksessa 78 % Claude 3.5 -käännöksistä arvioitiin hyviksi — korkeimmaksi kaikista testatuista LLM-malleista.
Grokia ei ole arvioitu WMT24:ssä tai Intenton riippumattomassa LQA-arvioinnissa vastaavalla tasolla. The Slator Pro Guide (2025) listaa Grokin yhdeksi yleiskäyttöisistä LLM-malleista, joita käytetään kääntämiseen ammattimaisissa ympäristöissä GPT:n ja Clauden rinnalla, mutta ei sijoita sitä kumpaakaan korkeammalle.
| Benchmark | Grok | Claude |
|---|---|---|
| MachineTranslation.com:n sisäinen laatupistemäärä | Ei mitattu benchmark-tasolla | 93.8/100 (3.5 Sonnet -taso) |
| Intento 2025 top 14 -ratkaisut | Ei listattu | Sekä Claude Opus 4 että Sonnet 3.7 listattu |
| WMT24-kieliparit | Ei arvioitu | 1. sija 9/11 kieliparissa |
| Lokalise 2025 -sokkotutkimus | Ei arvioitu | 78 % hyvä (korkein kaikista LLM-malleista) |
Lähde: MachineTranslation.comin sisäiset vertailutestit; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Missä Grokilla on todellinen etu?
Reaaliaikainen ja ajankohtaisten tapahtumien kääntäminen. Grokin määrittelevä arkkitehtuurinen piirre on sen integraatio X (entinen Twitter) -alustan dataan ja reaaliaikaiseen internethakuun. Toisin kuin Claude ja useimmat muut LLM-mallit, jotka on koulutettu staattisilla tietoaineistoilla, joissa on kiinteät tiedon katkaisuajankohdat, Grok sisällyttää reaaliaikaista tietoa tuotoksiinsa. Käännöstehtävissä, jotka koskevat viimeaikaisia tapahtumia, hiljattain julkaistuja tuotteita, uutta poliittista terminologiaa, ajankohtaisia uutisia tai sisältöä, joka viittaa viime viikkojen aikana tapahtuneisiin asioihin, Grokilla on pääsy sellaiseen kontekstiin, johon Claudella ei ole.
Tämä on erityisen tärkeää: viimeaikaisia tapahtumia koskevien uutisartikkelien kääntämisessä, tuotejulkistusten lokalisoinnissa nopeasti muuttuville markkinoille, sellaisen uuden terminologian tai slangin käsittelyssä, joka on syntynyt muiden mallien koulutusdatan ajankohdan jälkeen, sekä kaikessa sellaisessa sisällössä, jonka merkitys riippuu siitä, että tiedetään, mitä hiljattain on tapahtunut.
Nouseva ja kehittyvä terminologia. Tekniset alat, teollisuudenalat ja kulttuuriset kontekstit tuottavat jatkuvasti uutta terminologiaa. Käännöstehtävissä, joihin liittyy hiljattain luotuja termejä, uutta sääntelykieltä tai uutta tuotenimistöä, Grokin päivitetty koulutus ja reaaliaikainen haku antavat sille pääsyn sellaisiin käyttötapoihin, joita vanhemmat koulutusdatan tilannevedokset eivät tavoita.
Grok 4.1 -konteksti-ikkuna ja päättely. Grok 4.1 (loppuvuodesta 2025) tarjoaa 131K tokenin konteksti-ikkunan ja parannetut päättelykyvyt, mikä tekee siitä kykenevän käsittelemään monimutkaisia, monikerroksisia asiakirjoja, joissa lauseiden välisillä suhteilla ja loogisella johdonmukaisuudella on merkitystä.
Missä Claudella on todellinen etu?
Käännöslaatu riippumattomissa vertailutesteissä. Clauden etu on dokumentoitu riippumattoman ammatillisen arvioinnin perusteella itse ilmoitettujen väitteiden sijaan. WMT24 sijoitti Claude 3.5:n ensimmäiseksi 9:ssä 11 kieliparista koko kilpailijakenttää vastaan. Lokalisen vuoden 2025 sokkotutkimus havaitsi ammattikääntäjien pitävän Claude 3.5:n tuotosta parempana 78 %:n hyvä-osuudella — mikä on korkeampi kuin GPT-4:n, DeepL:n ja Google Translaten osuus samassa arvioinnissa. Nämä ovat sokkoarviointeja: ammattikääntäjät arvioivat tuotoksia tietämättä, mikä malli ne oli tuottanut.
Tietyt kieliparit Intento 2025:n mukaan. Claude Opus 4 ja Sonnet 3.7 sijoittuvat paras-kategoriaan kielipareissa englannista saksaksi, englannista japaniksi, englannista italiaksi, englannista koreaksi, englannista hollanniksi, englannista arabiaksi ja englannista ranskaksi Intenton ihmisarvioijien tekemässä LQA-arvioinnissa. Näiden parien kohdalla Claude on näistä kahdesta dokumentoidusti vahvempi valinta.
Sävyn tarkkuus ja vivahteikas sisältö. Lokalisen tutkimuksessa ammattikääntäjät suosivat Clauden tuotosta eniten kaikista LLM-malleista — mikä heijastaa Clauden dokumentoitua vahvuutta rekisterin, kirjoittajan äänen ja kontekstuaalisen merkityksen säilyttämisessä. Kaunokirjallisessa kääntämisessä, juridisissa asiakirjoissa, virallisessa viestinnässä ja markkinointiteksteissä, joissa se, miten jokin sanotaan, merkitsee yhtä paljon kuin se, mitä sanotaan, Claude suoriutuu johdonmukaisesti hyvin riippumattomissa arvioinneissa.
Pitkien asiakirjojen koherenssi. Claude 4.6 Sonnet tukee 200K tokenin konteksti-ikkunaa, ja Claude Opus 4.6 tukee 1M tokenia betavaiheessa. Pitkien virallisten asiakirjojen (sopimusten, teknisten oppaiden, kliinisten tutkimusraporttien) kohdalla Claude voi käsitellä koko asiakirjan yhdellä kertaa säilyttäen terminologian johdonmukaisuuden kauttaaltaan. Fragmenteittain käsitellyissä asiakirjoissa terminologian epäjohdonmukaisuuden aste on 28 % korkeampi verrattuna kokonaisten asiakirjojen käsittelyyn. Lähde: MachineTranslation.comin sisäiset tiedot.
Miten ne vertautuvat kielituen ja hinnoittelun osalta?
Kielituki: Sekä Grok 4.1 että Claude 4.6 tukevat kääntämistä useimmilla maailman pääkielistä. Claude on arvioitu riippumattomasti eurooppalaisissa ja itäaasialaisissa kielipareissa vahvoin tuloksin. Grokin monikielinen tuki on parantunut peräkkäisten versioiden myötä. Vähäresurssisten kielten kohdalla molempien mallien laatu heikkenee — ihmisen tekemä tarkistus on tarpeen vähäresurssisten kieliparien sisällölle riippumatta siitä, kumpaa mallia käytetään.
Hinnoittelu:
| Tilaus | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Kuluttaja (kuukausittain) | SuperGrok: $30/kk | Claude Pro: $20/kk |
| API-syöte (per M tokenia) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| API-tuloste (per M tokenia) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Maksuton taso | Kyllä (käyttörajoitettu X/Grok.comin kautta) | Kyllä (käyttörajoitettu claude.ai:n kautta) |
Kuluttajatasolla Claude Pro ($20/month) is cheaper than SuperGrok ($30/kk). API-tasolla Grok 4.1:llä on pieni kustannusetu Claude Sonnet 4.6 -malliin nähden syötepainotteisissa käännöstyönkuluissa.
Mikä on parempi tietyille sisältötyypeille?
| Sisältötyyppi | Suositeltu malli | Syy |
|---|---|---|
| Tuoreet uutiset / ajankohtaiset tapahtumat | Grok | Reaaliaikainen pääsy tietoon; staattisesti koulutetuilta malleilta puuttuu ajankohtainen konteksti |
| Uusi terminologia / uudet tuotelanseeraukset | Grok | Reaaliaikainen hakukoneintegraatio tavoittaa viimeaikaiset käyttötavat |
| Viralliset oikeudelliset asiakirjat | Claude | WMT24- ja Lokalise 2025 -riippumaton arviointi; äänensävyn tarkkuus |
| Lääketieteellinen / kliininen sisältö | Claude | Asema riippumattomissa suorituskykytesteissä; tyylirekisterin säilyttäminen |
| Markkinointitekstit / luova sisältö | Claude | Lokalise 2025 -sokkotutkimuksen mieltymys; sävyvivahteet |
| Tekninen dokumentaatio (pitkä) | Claude | 200K–1M konteksti-ikkuna; terminologian johdonmukaisuus koko pituudelta |
| Sosiaalinen media / keskustelusisältö | Kumpikin | Molemmat suoriutuvat hyvin korkean resurssitason keskustelupareista |
| Kehittäjä- / API-integraatio | Kumpikin | Molemmat tarjoavat API-pääsyn; Grok on hieman halvempi syötetokenien osalta |
Mitä käyttää, kun yksi malli ei riitä
Sekä Grok että Claude ovat yhden mallin työkaluja. Jokainen yksittäinen tekoälymalli (riippumatta siitä, kuinka kyvykäs se on) tuottaa virheitä, joita se ei pysty havaitsemaan omassa tuotoksessaan. Sujuva ja vakuuttava käännös joko Grokilta tai Claudelta voi silti olla semanttisesti virheellinen, eikä sitä voi mitenkään tietää ilman ristiintarkistusta.
Sekä Grok että Claude kuuluvat MachineTranslation.comin SMART-järjestelmän 22 mallin joukkoon. SMART ajaa kaikki 22 mallia samanaikaisesti (mukaan lukien Grok ja Claude) ja palauttaa tuloksen, josta enemmistö on samaa mieltä.
Mitä tämä tarkoittaa Grok vs. Claude -kysymyksen kannalta: Grokin reaaliaikainen vahvuus ja Clauden kontekstuaalinen syvyys myötävaikuttavat molemmat samaan konsensukseen. Kun ne ovat samaa mieltä, tämä yksimielisyys on vahva laatusignaali.
MachineTranslation.comin sisäisissä vertailutesteissä yksittäiset huipputason mallit saavat käännöslaadussa 93-94 pistettä sadasta. SMARTin konsensustuotos saavuttaa 98.5/100. Lähde: MachineTranslation.comin sisäiset vertailutulokset ja WMT24:n yleisen konekääntämisen havainnot.
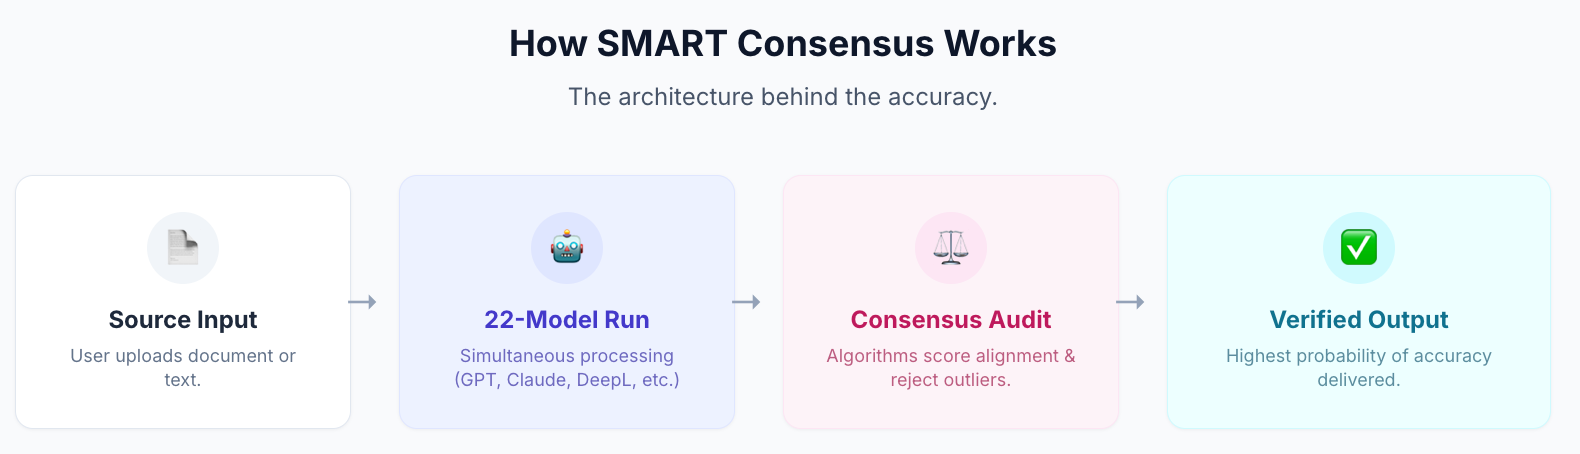
Käyttäjät, jotka siirtyivät yhden kääntimen käytöstä SMARTiin, käyttivät 27 % vähemmän aikaa tulosten tarkistamiseen ja korjaamiseen. Lähde: MachineTranslation.comin sisäiset tiedot.
Kriittiselle sisällölle (oikeudelliset asiakirjat, viranomaisilmoitukset, lääketieteelliset ohjeet) Human Verification siirtää SMART-konsensuksen sertifioidulle ammattitarkastajalle saman alustan sisällä. Ei ulkopuolista toimistoa. 100 % tarkkuus taattu.
Käännä käyttäen malleja Grok, Claude ja 20 muuta mallia osoitteessa MachineTranslation.com — ilmaiseksi, rekisteröitymistä ei vaadita.
Usein kysytyt kysymykset
1. Onko Grok parempi kuin Claude kääntämisessä?
Useimmissa tavallisissa käännöstehtävissä Claude johtaa riippumattomissa vertailutesteissä: ensimmäisenä 9:ssä 11 kieliparista WMT24:ssä, 78% ”hyvä”-arviolla Lokalisen vuoden 2025 sokkotutkimuksessa ja tuloksella 93.8/100 MachineTranslation.comin sisäisissä laatuvertailuissa. Grokin erityinen etu on sisällössä, joka vaatii ajankohtaistietoa; sen reaaliaikainen pääsy tietoon antaa sille sellaista kontekstia, jota staattisesti koulutetuilla malleilla, mukaan lukien Claude, ei ole. Viimeisimpien uutisten, nousevan terminologian ja aikaherkän sisällön osalta Grok on vahvempi valinta.
2. Mikä on Grokin etu Claudeen nähden kääntämisessä?
Grok integroi reaaliaikaista tietoa X:stä (entinen Twitter) ja reaaliaikaista verkkohakua. Toisin kuin Claude ja useimmat muut staattisilla tietoaineistoilla koulutetut LLM-mallit, Grok voi hyödyntää tietoa viimeaikaisista tapahtumista, vastaluodusta terminologiasta ja ajankohtaisesta kontekstista käännöksiä luodessaan. Tämä tekee siitä erityisesti vahvemman uutissisällön, äskettäin julkaistujen tuotteiden ja kaiken sellaisen materiaalin kääntämisessä, jonka merkitys riippuu viime viikkojen tapahtumista tai kielenkäyttömalleista.
3. Mikä on Clauden etu verrattuna Grokiin kääntämisessä?
Clauden etu on dokumentoitu riippumattoman ammatillisen arvioinnin kautta. Claude 3.5 sijoittui ensimmäiseksi 9:ssä 11 kieliparista WMT24:ssä, ja ammattikääntäjät Lokalisen vuoden 2025 sokkotutkimuksessa pitivät sen tuotosta parempana 78 %:n hyvä-osuudella — korkeimpana kaikista testatuista LLM-malleista. Claude esiintyy myös Intenton 14 parhaan ratkaisun joukossa useissa kielipareissa ihmisten tekemässä LQA-arvioinnissa, kun taas Grok ei. Muodollisissa, ammatillisissa ja korkean panoksen käännöstehtävissä Clauden riippumaton benchmark-asema on dokumentoitu erottava tekijä.
4. Kumpi on parempi oikeudelliseen kääntämiseen, Grok vai Claude?
Claude on vahvempi valinta oikeudelliseen kääntämiseen riippumattoman arvioinnin perusteella. Claude 3.5 sijoittui ensimmäiseksi useimmissa runsaasti resursoiduissa eurooppalaisissa kielipareissa WMT24:ssä ja sai korkeimmat sokkotutkimuksen mieltymysarviot ammattikääntäjiltä. Sertifioitua tarkkuutta vaativalle juridiselle sisällölle kumpikaan malli yksinään ei riitä — MachineTranslation.comin Human Verification tarjoaa 100 %:n tarkkuuden sertifioidun ammattitarkastajan tekemänä samalla alustalla, ilman tarvetta ulkopuoliselle toimittajalle.
5. Ovatko sekä Grok että Claude saatavilla MachineTranslation.com-palvelussa?
Kyllä. Molemmat kuuluvat MachineTranslation.comin SMART-järjestelmän 22 malliin. Jokainen SMART-käännös ajaa Grok-, Claude- ja 20 muuta mallia samanaikaisesti palauttaen tuloksen, josta enemmistö on samaa mieltä. Sen sijaan, että valitsisit niiden väliltä, saat kaikkien AI-mallien konsensuksen.
6. Miten Grok ja Claude vertautuvat hinnoittelultaan?
Kuluttajatasolla Claude Pro maksaa $20/month versus SuperGrok at $30/kk. API-tasolla Grok 4.1 on hieman halvempi syötetokeneissa ($2/M vs. $3/M Claude Sonnet 4.6:lle) ja tulostetokeneissa ($10/M vs. $15/M). MachineTranslation.comin ilmainen paketti sisältää molemmat mallit osana SMARTin 22 mallin konsensusta, rekisteröitymistä ei vaadita.
7. Mikä tekoälymalli on paras uutisartikkelien kääntämiseen?
Uutisartikkelien kääntämisessä Grokilla on rakenteellinen etu: sen reaaliaikainen dataintegraatio tarkoittaa, että sillä on ajantasainen konteksti kuvatuista tapahtumista, mikä staattisesti koulutetuilta malleilta saattaa puuttua. Yleisessä uutisten kääntämisessä, jossa ajantasaisuus ei ole kriittistä, Clauden benchmark-suorituskyky on vahvempi. Suuren volyymin uutiskäännöksissä, joissa sekä ajantasaisuus että tarkkuus ovat tärkeitä, MachineTranslation.comin SMART ajaa molemmat mallit ja palauttaa niiden konsensustuloksen.