November 13, 2026
Qwen vs Gemini kääntämisessä ja miksi suunnalla on väliä
Käytettävissäsi on kaksi mallia ja lista kielipareja, ja sinun on päätettävä, kumpaan malliin luotat projektissasi. Useimmat Qwenin ja Geminin väliset vertailut vastaavat yhdellä kokonaispistemäärällä. Mielestäni yksi pistemäärä peittää sen, mikä ratkaisee lopputuloksen, eli käännössuunnan.
Työskentelen sen parissa, miten testaamme MachineTranslation.comissa ajettavia malleja, joten voin vertailla Qweniä ja Geminiä 98 kieliparissa, jotka on pisteytetty identtisen tekstin pohjalta. Gemini sai korkeammat pisteet 68:ssa näistä pareista ja Qwen 29:ssä, ja keskimääräinen ero on 0,08 pistettä kymmenestä. Pelkät kokonaistulokset eivät kerro, kumpi malli kannattaa valita urdusta englantiin tai englannista haitinkreoliin.
Tämä artikkeli näyttää, missä mallit ovat lähellä toisiaan ja missä kumpikin johtaa. Se kertoo myös sen, mitä en voi vielä kertoa. Aineistoni päättyy 8. elokuuta 2026, ennen kuin Google julkisti Gemini 4:n lokakuussa, joten se kuvaa kummankin mallin aiempia versioita.
Tärkeimmät havainnot
- Identtisen tekstin pohjalta pisteytetyissä 98 kieliparissa (12. heinäkuuta ja 8. elokuuta 2026 välisenä aikana) Gemini sai korkeammat pisteet 68 parissa, Qwen 29:ssä ja yksi pari päättyi tasapeliin.
- Keskimääräinen ero on pieni, Geminille 9,06 vastaan Qwenin 8,98, ja 60 paria 98:sta sijoittuu 0,1 pisteen sisälle.
- Käännettäessä englantiin Qwen johtaa yli 0,1 pisteellä 7:ssä 27 parista ja Gemini 3:ssa; loput 17 ovat 0,1 pisteen sisällä.
- Käännettäessä englannista Gemini johtaa yli 0,1 pisteellä 13:ssa 29 parista ja Qwen ei yhdessäkään.
- Aineisto päättyy ennen kuin Google julkisti Gemini 4:n lokakuussa 2026, joten se kuvaa Geminin aiempia versioita ja vaatii uuden ajon ennen kuin sitä voi pitää ajantasaisena.
Onko Qwen vai Gemini parempi kääntämiseen?
Se riippuu suunnasta, sillä mallit ovat lähellä toisiaan, kun kohdekielenä on englanti, ja Gemini saa korkeammat pisteet useimmissa muissa pareissa. Kaikista 98 parista Gemini sai korkeammat pisteet 68:ssa. MachineTranslation.comin tuloksissa 12. heinäkuuta ja 8. elokuuta 2026 välisenä aikana Gemini sai keskimäärin 9,06 pistettä kymmenestä ja Qwen 8,98, mikä tarkoittaa 0,08 pisteen keskimääräistä eroa.
Paneeli huomioi vain segmentit, joissa ChatGPT, Claude, DeepSeek, Gemini ja Qwen saivat kaikki todellisen pistemäärän, joten jokainen malli arvioidaan identtisen lähdetekstin pohjalta. Jokaisessa kieliparissa on vähintään 30 segmenttiä. Käytän tätä paneelia, koska se poistaa yleisen virheen, nimittäin mallien vertailun eri tekstien pohjalta.
Määrällisesti tarkasteltuna Gemini on edellä 68 parissa (69 %), Qwen 29:ssä (30 %) ja yksi pari päättyi tasapeliin. Pelkkä määrä liioittelee eroa, sillä 60 paria 98:sta on 0,1 pisteen sisällä. Seuraavissa osioissa tulokset jaetaan suunnan ja eron suuruuden mukaan.
Mitkä käännössuunnat suosivat kumpaakin mallia?
Gemini johtaa, kun englanti on lähtökielenä tai kun kumpikaan kieli ei ole englanti, ja Qwen on sen kanssa tasoissa tai edellä, kun englanti on kohdekielenä. Englannista käännettäessä Gemini johtaa yli 0,1 pisteellä 13:ssa 29 parista ja Qwen ei yhdessäkään. Englantiin käännettäessä Qwen johtaa tällä marginaalilla 7:ssä 27 parista ja Gemini 3:ssa.
| Suunta | Kieliparit | Gemini edellä yli 0,1 pisteellä | 0,1 pisteen sisällä | Qwen edellä yli 0,1 pisteellä | Keskimääräinen ero |
|---|---|---|---|---|---|
| Englantiin | 27 | 3 | 17 | 7 | Qwen +0,04 |
| Englannista | 29 | 13 | 16 | 0 | Gemini +0,16 |
| Kumpikaan kieli ei ole englanti | 42 | 14 | 27 | 1 | Gemini +0,13 |
Englantiin käännettäessä 17 paria 27:stä on 0,1 pisteen sisällä toisistaan, Qwen johtaa 7:ssä ja Gemini johtaa 3:ssa. Englannista käännettäessä 16 paria 29:stä on 0,1 pisteen sisällä toisistaan, Gemini johtaa 13:ssa ja Qwen ei yhdessäkään. Silloin kun kumpikaan kieli ei ole englanti, 27 paria 42:sta on 0,1 pisteen sisällä toisistaan, Gemini johtaa 14:ssä ja Qwen johtaa 1:ssä.
Englantiin käännettäessä Qwen on 0,1 pisteen sisällä Geministä tai edellä 24:ssä 27 parista. Suunnan mukaan keskiarvoistettuna Qwen on noin 0,04 pistettä edellä englantiin käännettäessä, kun taas Gemini on noin 0,16 pistettä edellä englannista käännettäessä ja 0,13 pistettä kahden muun kuin englannin kielen välillä.
En tiedä, miksi tämä ero syntyy, eikä tämä aineisto voi sitä kertoa. Yksi selitys, jota testaisin ensimmäisenä, on kunkin mallin taustalla oleva koulutustekstien jakauma, mutta en ole tehnyt tätä testiä. Qwen osoittaa samanlaista kaavaa myös ChatGPT:tä vastaan. Samassa paneelissa toteutettu vertailumme Qwenin ja ChatGPT:n välillä havaitsi näiden kahden olevan lähes tasoissa englantiin käännettäessä, ja ChatGPT oli edellä 89 %:ssa muista pareista.
Missä kielipareissa erot ovat suurimmat?
Suurimmat erot ovat Geminin eduksi. Se johtaa 0,51 pisteestä 0,95 pisteeseen pareissa venäjästä kazakkiin, englannista haitinkreoliin, englannista tagalogiin, espanjasta kreikkaan ja arabiasta persiaan. Qwenin suurimmat johdot ovat pienempiä, 0,15 ja 0,26 pisteen välillä, ja neljä sen viidestä parhaasta parista suuntautuu englantiin.
| Kielipari | Geminin pisteet | Qwenin pisteet | Ero |
|---|---|---|---|
| Venäjästä kazakkiin | 9,27 | 8,32 | Gemini +0,95 |
| Englannista haitinkreoliin | 9,19 | 8,27 | Gemini +0,92 |
| Englannista tagalogiin | 9,14 | 8,43 | Gemini +0,70 |
| Espanjasta kreikkaan | 8,90 | 8,33 | Gemini +0,57 |
| Arabiasta persiaan | 8,84 | 8,34 | Gemini +0,51 |
| Urdusta englantiin | 8,56 | 8,81 | Qwen +0,26 |
| Kiinasta englantiin | 9,00 | 9,19 | Qwen +0,19 |
| Ruotsista englantiin | 8,29 | 8,46 | Qwen +0,16 |
| Kiinasta indonesiaksi | 9,03 | 9,19 | Qwen +0,16 |
| Burmasta englantiin | 8,94 | 9,09 | Qwen +0,15 |
En pitäisi näitä lopullisina sijoituksina. Kaksi suurinta eroa, venäjästä kazakkiin ja englannista haitinkreoliin, perustuvat mediaaniparia pienempiin otoksiin. Englannista tagalogiin, espanjasta kreikkaan ja arabiasta persiaan perustuvat suurempiin otoksiin, joten luottaisin niihin kolmeen enemmän. Testaisin nuo kaksi pienen otoksen eroa uudelleen ennen niihin luottamista.
Mitä 0,1 pisteen ero tarkoittaa?
Mielestäni alle 0,1 pisteen ero on liian pieni voittajan julistamiseen. Parista 98 peräti 60 asettuu tämän marginaalin sisälle, ja jokainen pari pisteytetään rajallisen segmenttimäärän perusteella. Tuo 0,1 pisteen raja on oma työkynnykseni, enkä ole tehnyt näille pareille tilastollisen merkitsevyyden testausta.
Pisteytys jättää myös huomiotta joitakin eroja. Yleisten fraasien testeissämme ajoimme sanan ”sorry” arabiaksi 22 tekoälymallin läpi. Gemini ja Qwen valitsivat kumpikin arkikielisen ilmaisun آسف. ChatGPT ja yhdistetty tulos valitsivat puolestaan muodollisen ilmaisun عذرًا. Jokainen malli sai pisteet 9,5, joten sanat eroavat tyylilajiltaan, mutta pistemäärä ei muuttunut lainkaan.
Siksi luen marginaalia ja tyylilajiesimerkkejä yhdessä. Pieni ero selkeän tyylilajieron kera vaatii ihmisen tekemän päätöksen. Suuri ero suppealla otoksella vaatii uutta testausta.
Tekevätkö Qwen ja Gemini erilaisia virheitä?
Kyllä, sillä vuoden 2026 World Cup -sitaattitestissämme molemmat mallit tekivät vähintään yhden sellaisen valinnan, jota muut mallit eivät tehneet, ja pisteet tuskin liikahtivat. Gemini käänsi erään Mbappén ilmaisun muotoon ”with each game” ja käänsi Wirtzin sitaatin sanasta sanaan, kun taas Qwen antoi eriävän tulkinnan Scalonin sitaatista. Pisteet näissä tapauksissa asettuivat välille 9,2 ja 9,5.
Yksityiskohdat ovat peräisin World Cup -sitaattitestistämme. Mbappén tulevaisuuteen katsomista koskevassa sitaatissa muut mallit säilyttivät sanan ”match”, kun taas Gemini kirjoitti ”with each game”, mikä oli pieni tyylilajin horjahdus ja sai tuloksen 9,4. Wirtzin sitaatissa Gemini käänsi ilmauksen sanasta sanaan ja muutti merkitystä, saaden niin ikään tuloksen 9,4. Scalonin sitaatissa useimmat mallit päätyivät samaan tulkintaan, kun taas Qwen kirjoitti ”that is what matters” ja sai tuloksen 9,4. Mbappén taktisessa sitaatissa Claude ja DeepSeek valitsivat brittiläisen jalkapalloenglannin, kun taas Gemini, Qwen ja muut valitsivat amerikanenglannin, ja Qwen sai tuloksen 9,2, joka oli muita heikompi.
Pidän näitä pieninä tottumuksina. Geminin esimerkit liittyvät tyylilajiin ja sanatarkkaan ilmaisuun. Qwenin esimerkit koskevat sitä, mikä tulkinta lauseesta valitaan. Neljä esimerkkiä on liian vähän säännönmukaisuuden vahvistamiseen, mutta ne osoittavat, millaisia eroja yksittäinen pistemäärä kätkee.
Mikä Qwen-malli on paras kääntämiseen?
En voi sanoa sitä datamme perusteella, sillä MachineTranslation.comin pisteet käsittelevät Qweniä yhtenä mallina ilman versiotunnistetta. Alibaban Qwen3.8-perhe saapui Hugging Faceen elokuussa 2026, joten versioita on nyt useita, eivätkä tämän artikkelin pisteet erottele niitä toisistaan.
Haluaisin eritellä tämän versioittain, mutta se ei ole vielä mahdollista. Alustatason luku saattaa muodostua keskiarvona useammasta Qwen-versiosta, jotka olivat käytössä tarkastelujaksolla. Jos valitset Qwen-versioiden välillä jotakin projektia varten, suosittelen vertailemaan niitä otoksella omaa tekstiäsi.
Mitä vaihtoehtoja Geminille on kääntämiseen?
ChatGPT, Claude, DeepSeek, Qwen, Grok ja Mistral AI toimivat kaikki MachineTranslation.comissa, ja sopiva vaihtoehto riippuu kieliparista. Tuloksissamme ajalta 12. heinäkuuta ja 8. elokuuta 2026 väliltä Qwen on korkeintaan 0,1 pisteen päässä Geministä tai sen edellä 24 parissa 27:stä englantiin käännettäessä. Mistral AI:n ranskan kielen tuloksemme osoittavat sen ranskan ja englannin välisen keskiarvon olevan 0,40 pistettä Geminin yläpuolella.
Jos vaihtoehtosi on ChatGPT, vastaus vaihtelee myös kieliparin mukaan. Julkaistussa espanjan ja englannin välisessä erittelyssämme Gemini voitti 31 % segmenteistä ja ChatGPT voitti 21 %. Ranskan osalta kumpikaan malli ei voita molempiin suuntiin. Koska valinta vaihtelee parin mukaan, MachineTranslation.com ei valitse vain yhtä vaihtoehtoa. Se ajaa niitä rinnakkain.
Ehdotukseni on aloittaa kieliparista ja suunnasta, ja tarkastella sitten, mikä vaihtoehto sopii.
Miten MachineTranslation.com näyttää kohdat, joissa Qwen ja Gemini ovat eri mieltä?
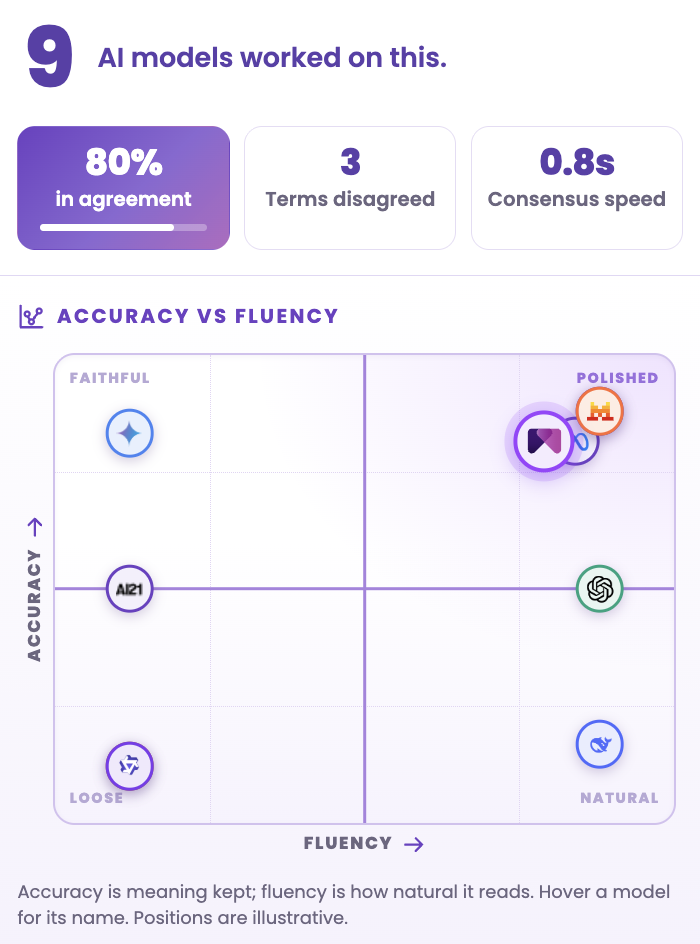
MachineTranslation.com ajaa molemmat mallit jokaiselle käännökselle ja näyttää, missä kohdissa mallit ovat samaa mieltä ja missä niiden näkemykset eroavat toisistaan. Yksimielisyyspaneeli ilmoittaa, kuinka monta tekoälymallia työskenteli tekstin parissa, yhtä mieltä olevien osuuden, kuinka monesta termistä oli erimielisyyttä ja kuinka nopeasti konsensus muodostui.
Kuinka ajantasaisia nämä tulokset ovat?
Nämä tulokset kattavat ajan 12. heinäkuuta ja 8. elokuuta 2026 väliltä, joten ne kuvaavat silloin toimineita Geminin ja Qwenin versioita. Google julkisti Gemini 4 lokakuussa 2026. Alibaban Qwen3.8-perhe saapui elokuussa 2026. Suositukseni on ajaa paneeli uudelleen ennen kuin näihin lukuihin luotetaan uudessa projektissa.
Odotan, että menetelmä identtisen tekstin vertailemiseksi kohinamarginaalilla pitää paikkansa. Odotan, että erojen suuruus muuttuu. Suhtautuisin mihin tahansa pariin, jossa johtaja vaihtuu uudella ajolla, merkkinä siitä, että aiempi ero mahtui kohinan sisään.
Miten valitsisin Qwenin ja Geminin välillä projektia varten?
Näkemykseni on valita kieliparin ja suunnan mukaan ja välttää valinnan tekemistä kerralla koko projektille. Käytännössä se tarkoittaa alle 0,1 pisteen eron pitämistä tasapelinä ja varautumista siihen, että johtava malli vaihtuu parien välillä. Tämä on järjestys, jota noudattaisin.
- Listaa projektin jokainen kielipari ja merkitse sen suunta.
- Tarkista kunkin parin ero tästä artikkelista. Pidä alle 0,1 pisteen eroa tasapelinä.
- Jos ero on suurempi, aloita johtavalla mallilla ja testaa näytettä omasta tekstistäsi.
- Jos sisältöäsi käännetään molempiin suuntiin, varaudu siihen, että johtava malli vaihtelee parien välillä.
- Tarkista tilanne uudelleen, kun jompikumpi malleista julkaisee uuden version.
Molemmat mallit toimivat 20 muun mallin rinnalla jokaisessa käännöksessä palvelussa MachineTranslation.com. Palvelu palauttaa version, josta suurin osa niistä on yhtä mieltä, joten valintaa ei tarvitse tehdä kerralla koko projektille. Kaikki mallikohtaiset tulokset löytyvät mallivertailutestistämme.
Usein kysytyt kysymykset
1. Onko Qwen vai Gemini parempi kääntämiseen?
Se riippuu suunnasta, sillä Qwen on enintään 0,1 pisteen päässä Geministä tai edellä 24 parissa 27:stä englantiin käännettäessä. Gemini sai silti paremmat pisteet 68 parissa 98:sta MachineTranslation.comin tuloksissa 12. heinäkuuta ja 8. elokuuta 2026 väliseltä ajalta. Keskimääräinen ero on 0,08 pistettä 10:stä, joten tekisin valinnan kieliparin mukaan.
2. Mikä Qwen-malli on paras kääntämiseen?
En osaa sanoa tietojemme perusteella, koska MachineTranslation.comin tulokset käsittelevät Qweniä yhtenä mallina ilman versiotunnistetta. Alibaban Qwen3.8-tuoteperhe saapui Hugging Faceen elokuussa 2026, joten versioita on nyt useita. Ennen kuin tulokset erottelevat ne toisistaan, vertaisin versioita omasta tekstistä otetulla näytteellä ennen yhden valitsemista projektia varten.
3. Mitä vaihtoehtoja Geminille on kääntämiseen?
ChatGPT, Claude, DeepSeek, Qwen, Grok ja Mistral AI toimivat kaikki palvelussa MachineTranslation.com. Tuloksissamme 12. heinäkuuta ja 8. elokuuta 2026 väliseltä ajalta Qwen on enintään 0,1 pisteen päässä Geministä tai edellä 24 parissa 27:stä englantiin käännettäessä. Mistral AI:n keskiarvo ranskasta englantiin oli 0,40 pistettä Geminin keskiarvoa korkeampi. Oikea vaihtoehto riippuu parista.
4. Onko Gemini parempi kuin ChatGPT kääntämiseen?
Se riippuu kieliparista, sillä mikään yksittäinen tekoälymalli ei voita kaikkialla. Julkaisemassamme erittelyssä espanjasta englantiin Gemini voitti 31 % segmenteistä ja ChatGPT voitti 21 %. Ranskan osalta kumpikaan malli ei voita molempiin suuntiin. Tarkistaisin tarvitsemasi parin ja suunnan ennen kuin teet valinnan niiden välillä.
5. Is Gemini accurate for translation?
Kyllä, sillä Gemini sai keskiarvokseen 9,06 kymmenestä 98 kieliparissa MachineTranslation.comin tuloksissa ajalta July 12 to August 8, 2026. Tarkkuus vaihtelee silti parikohtaisesti. Sen johto on suurin englannista käännettäessä, ja Qwen on sitä edellä yli 0,1 pistettä 7 parissa 27 parista englantiin käännettäessä.