October 2, 2026
Qwen vs Grok: Kumpi tekoälymalli kääntää paremmin?
Qwen ja Grok ovat molemmat yleiskäyttöisiä tekoälymalleja, eivät käännöksiin erikoistuneita työkaluja, ja molemmat ovat osa mallivalikoimaa, jota MachineTranslation.com käyttää jokaisessa käännöksessään. Tämä on tärkeää huomioida seuraavaa lukiessa. Tässä katsauksessa tarkastellaan, kuinka kaksi alustan omaa mallia pärjäävät toisiaan vastaan, huomioiden tällaiseen dataan liittyvät todelliset varaukset, eikä kyseessä ole kilpailu kahden ulkopuolisen haastajan ja itse alustan välillä.
Mitä Qwen ja Grok ovat?
Qwen on Alibaban suurten kielimallien tuoteperhe, joka on tällä hetkellä Qwen3.8-sukupolvessa, ja se lisättiin MachineTranslation.comin mallivalikoimaan osana alustan jatkuvaa laajentumista. Grok on xAI:n mallisarja, joka on tätä kirjoitettaessa Grok 4.7 -versiossa. Se on käynyt läpi useita julkaisuja sen version jälkeen, jota tässä artikkelissa alun perin vertailtiin, ja se liittyi alustalle erikseen. Kumpaakaan mallia ei ole rakennettu nimenomaan kääntämistä varten. Molemmat ovat yleiskäyttöisiä järjestelmiä, jotka sattuvat käsittelemään monia kieliä osana laajempaa kielellistä kyvykkyyttään, mikä on aivan eri lähtökohta kuin alustalla, joka on rakennettu ja testattu nimenomaan käännöslaadun ehdoilla.
Miten Qwen ja Grok vertautuvat toisiinsa MachineTranslation.comin omassa datassa?
Viimeisten 28 päivän alustaliikenteen aikana Grok sai keskimäärin paremmat pisteet kuin Qwen: 9.26 kymmenestä Qwenin 8.87:ää vastaan. Grokin heikoimmin menestynyt 10 % käännöksistä saavutti silti 9.2 keskiarvon, kun taas Qwenin heikoimmin menestynyt 10 % putosi 7.6:een, mikä tekee heikoimman pään erosta suuremman kuin pelkkä keskiarvo antaa ymmärtää.
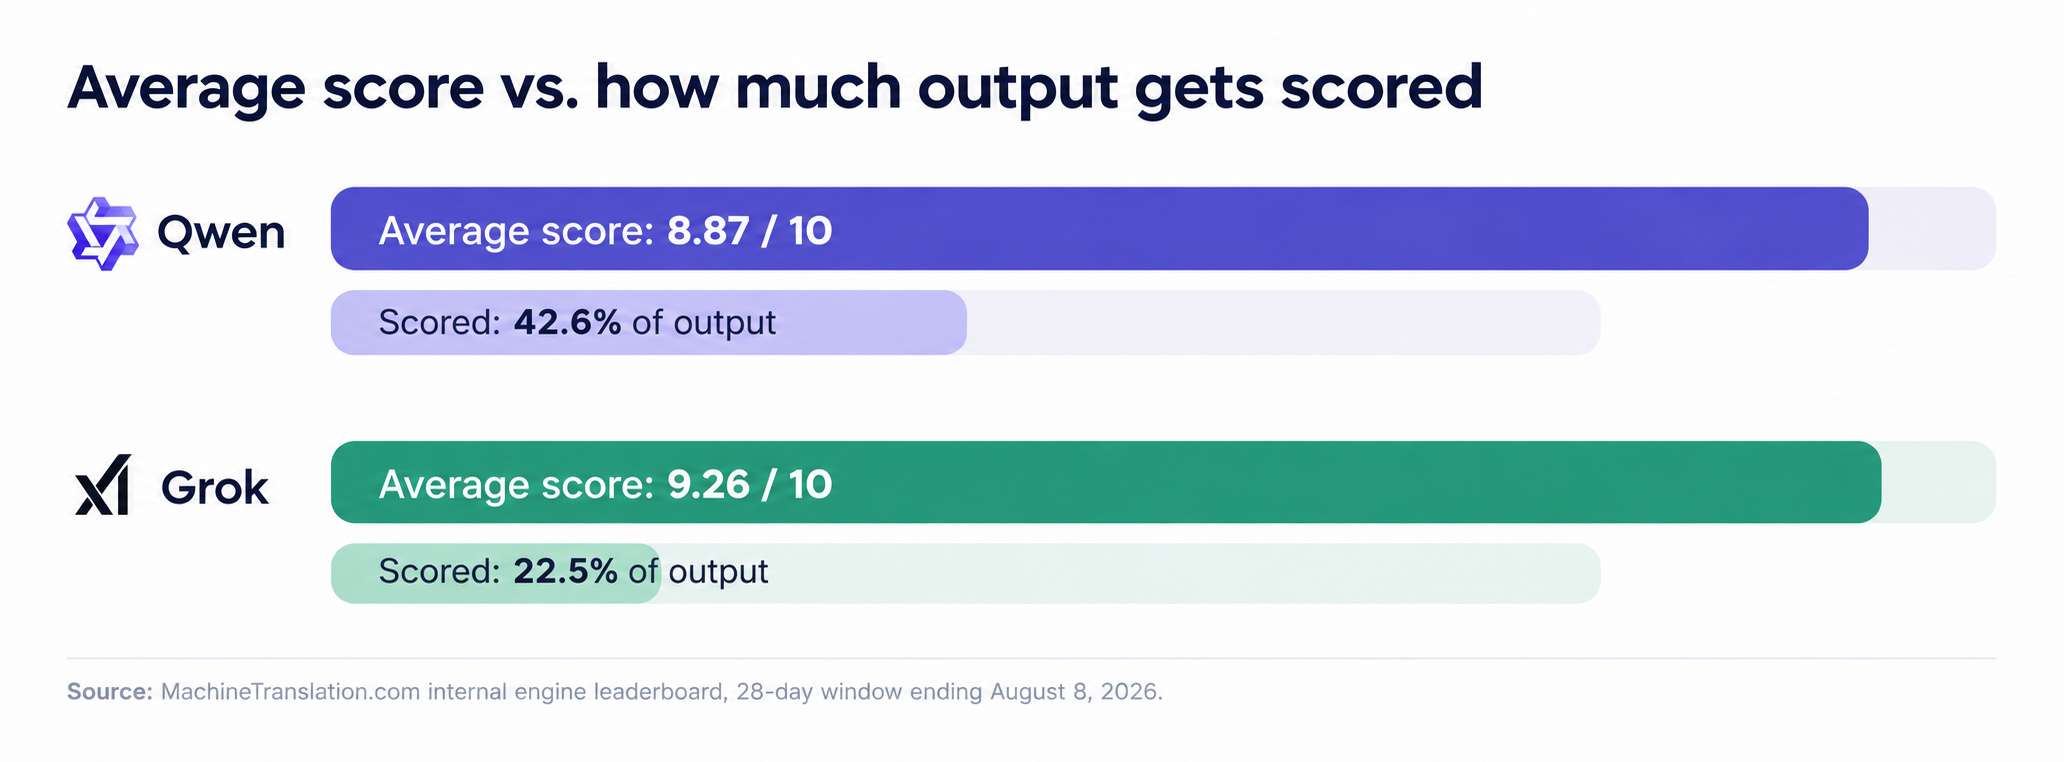
Grokin keskimääräinen pistemäärä on korkeampi, mutta se perustuu siihen, että alle neljännes sen tuotoksista on pisteytetty, kun taas Qwenin kohdalla vastaava luku on lähes puolet. Nämä kaksi pylvästä kertovat saman tarinan eri puolia.
| Qwen | Grok | |
|---|---|---|
| Pisteytetyn tuotoksen prosenttiosuus | 42.6% | 22.5% |
| Keskimääräinen pistemäärä | 8.87 / 10 | 9.26 / 10 |
| Alin 10 % pisteistä | 7.6 | 9.2 |
Lähde: MachineTranslation.comin sisäinen moottoreiden tulostaulukko, 28 päivän jakso, joka päättyi 8. elokuuta 2026.
Tarkoittaako Grokin korkeampi pistemäärä, että se on parempi valinta?
Ei yksinään. Grokia käytetään alustalla huomattavasti harvemmin kuin Qweniä, ja alle neljännes sen käännöksistä ylipäätään pisteytetään, kun taas Qwenin käännöksistä lähes puolet. Pienempi, vähemmän edustava otos voi saada keskiarvon näyttämään paremmalta tai huonommalta kuin mitä se olisi samalla volyymilla, jonka Qwen kohtaa. MachineTranslation.comin oma raportointi näistä tiedoista käsittelee pisteytyksen kattavuutta todellisena rajoitteena, ei vain alaviitteenä: moottoria, joka on pisteytetty vain kapeasta osasta sen liikennettä, ei ole testattu yhtä perusteellisesti kuin sellaista, joka on pisteytetty lähes puolesta sen tuotoksista.
Rehellinen tulkinta on, että Grokin luvut ovat lupaavia, mutta ohuempia. Qwenin luvut ovat keskimäärin alhaisempia, mutta ne perustuvat paljon suurempaan ja edustavampaan pohjaan. Kumpikaan tosiasia ei kumoa toistaan.
Entä kielten kattavuus?
Qwen ja Grok eivät kumpikaan julkaise vahvistettua luetteloa kielipareista, joissa suorituskyky heikkenee, eikä tämän vahvistamiseksi ole olemassa riippumatonta testausta. Varmuudella voidaan sanoa, että kumpaakaan mallia ei ole rakennettu tietyn kielijoukon käännöslaadun ympärille samalla tavalla kuin siihen erikoistunut käännösalusta on. MachineTranslation.com testaa ja tukee suoraan yli 270 kieltä, mikä on erityyppinen väite kuin yleiskäyttöisen mallin laaja mutta testaamaton monikielinen kyvykkyys.
Miten MachineTranslation.com todellisuudessa käyttää Qweniä ja Grokia
MachineTranslation.com käyttää Qweniä, Grokia ja yli 20 muuta tekoälymallia jokaisessa käännöksessä, ja nostaa sitten esiin sen version, josta nämä mallit ovat eniten samaa mieltä. Kumpaakaan mallia ei suljeta pois sen vuoksi, että sen keskiarvopisteet olisivat alhaisemmat. Monien mallien käyttäminen samanaikaisesti tarkoittaa sitä, että pystytään nappaamaan tapaukset, joissa keskimäärin heikommin pisteytetty malli saa silti tietyn lauseen oikein, kun taas korkeammat pisteet saanut malli epäonnistuu. Qwenin suorituskyky jakautuu myös suunnan ja kieliparin mukaan tavoilla, jotka on syytä tietää ennen yhden ainoan mallin valitsemista, ja tätä käsitellään syvällisemmin MachineTranslation.comin Qwen vs DeepSeek -vertailussa. Tarkemman katsauksen siihen, miten malleja testataan suoraan toisiaan vastaan, löydät MachineTranslation.comin kattavasta mallien vertailutestauksesta.
Usein kysytyt kysymykset
1. Onko Qwen vai Grok parempi kääntämisessä?
MachineTranslation.comin omien 28 päivän moottoritietojen perusteella Grok saa keskimäärin paremmat pisteet kuin Qwen, 9.26 vastaan 8.87 / 10. Mutta Grokin pisteet perustuvat huomattavasti pienempään ja vähemmän edustavaan osaan sen tuotoksista, joten tämä ei ole puhdas suora vertailu samalla tavalla kuin vertailukelpoisilla segmenteillä tehty testi olisi.
2. Miksi Grokilla on korkeampi keskiarvo, mutta vähemmän pisteytettyjä käännöksiä?
Grokia käytetään alustalla harvemmin ja vain noin 22.5% sen tuotoksista pisteytetään Qwenin 42.6% vastaan. Pienempi ja vähemmän edustava otos voi suurentaa tai pienentää keskiarvoa, minkä vuoksi tätä vertailua tulisi pitää suuntaa-antavana, ei lopullisena.
3. Tukeeko Qwen vai Grok useampia kieliä?
Molemmat ovat yleiskäyttöisiä tekoälymalleja, joilla ei ole julkaistua ja todennettua luetteloa kielikohtaisista rajoituksista. Kumpaakaan ei ole rakennettu erityisesti kääntämistä varten, mikä eroaa alustasta, joka testaa ja pisteyttää käännöslaatua suoraan 270+ kielellä sen sijaan, että se luottaisi laajaan monikieliseen koulutukseen mitatun käännössuorituskyvyn korvikkeena.
4. Kilpaileeko MachineTranslation.com Qwenin ja Grokin kanssa?
Ei. MachineTranslation.com käyttää Qwen-, Grok- ja yli 20 muuta tekoälymallia jokaisessa käännöksessä ja tuo esiin version, josta nämä mallit ovat eniten yksimielisiä. Se testaa ja yhdistää tällaisia malleja sen sijaan, että se kilpailisi niitä vastaan omana erillisenä mallinaan.
5. Mitä tekoälymallia MachineTranslation.com suosittelee kääntämiseen?
Ei yhtäkään oletuksena. Eri mallit suoriutuvat eri tavalla kieliparin ja sisältötyypin mukaan, ja niiden välinen ero voi olla kumpaan suuntaan tahansa riippuen siitä, mitä käännetään. Juuri tämän vaihtelun vuoksi alusta käyttää useita malleja jokaisessa käännöksessä sen sijaan, että se valitsisi yhden pysyväksi suositukseksi.