May 8, 2026
Grok vs Claude pour la traduction : ce que montrent les benchmarks (2026)
Grok (xAI) et Claude (Anthropic) sont tous deux des outils de traduction par IA performants, mais ils ont des forces structurellement différentes. Pour la plupart des tâches de traduction générale, vous ne remarquerez pas de différence significative entre eux. Pour deux scénarios précis (la traduction de contenu sur des événements récents et la traduction de documents officiels exigeant de la précision), la différence est réelle et repose sur la façon dont chaque modèle a été conçu.
Cet article présente ce que chaque modèle offre réellement en matière de traduction, la position que leur attribuent les analyses comparatives indépendantes, et ce qu'il convient d'utiliser lorsque les résultats de l'un ou l'autre modèle ne suffisent pas à eux seuls.
Comment Grok et Claude se comparent-ils en matière de qualité de traduction?
La réponse courte : Claude est en tête des tests de référence indépendants en traduction professionnelle. L'avantage spécifique de Grok est l'accès en temps réel aux connaissances, et non la qualité globale de la traduction.
Dans les analyses comparatives internes de MachineTranslation.com, Claude (niveau 3.5 Sonnet) obtient un score de 93.8 sur 100 pour la qualité de la traduction — précision, terminologie et style combinés. Grok ne figure pas parmi les 14 meilleures solutions du State of Translation Automation 2025 d'Intento, qui a évalué 46 moteurs de traduction automatique et LLM pour 11 paires de langues. Claude Opus 4 et Claude Sonnet 3.7 figurent tous deux dans le top 14. Source: Analyses comparatives internes de MachineTranslation.com; Intento State of Translation Automation 2025.
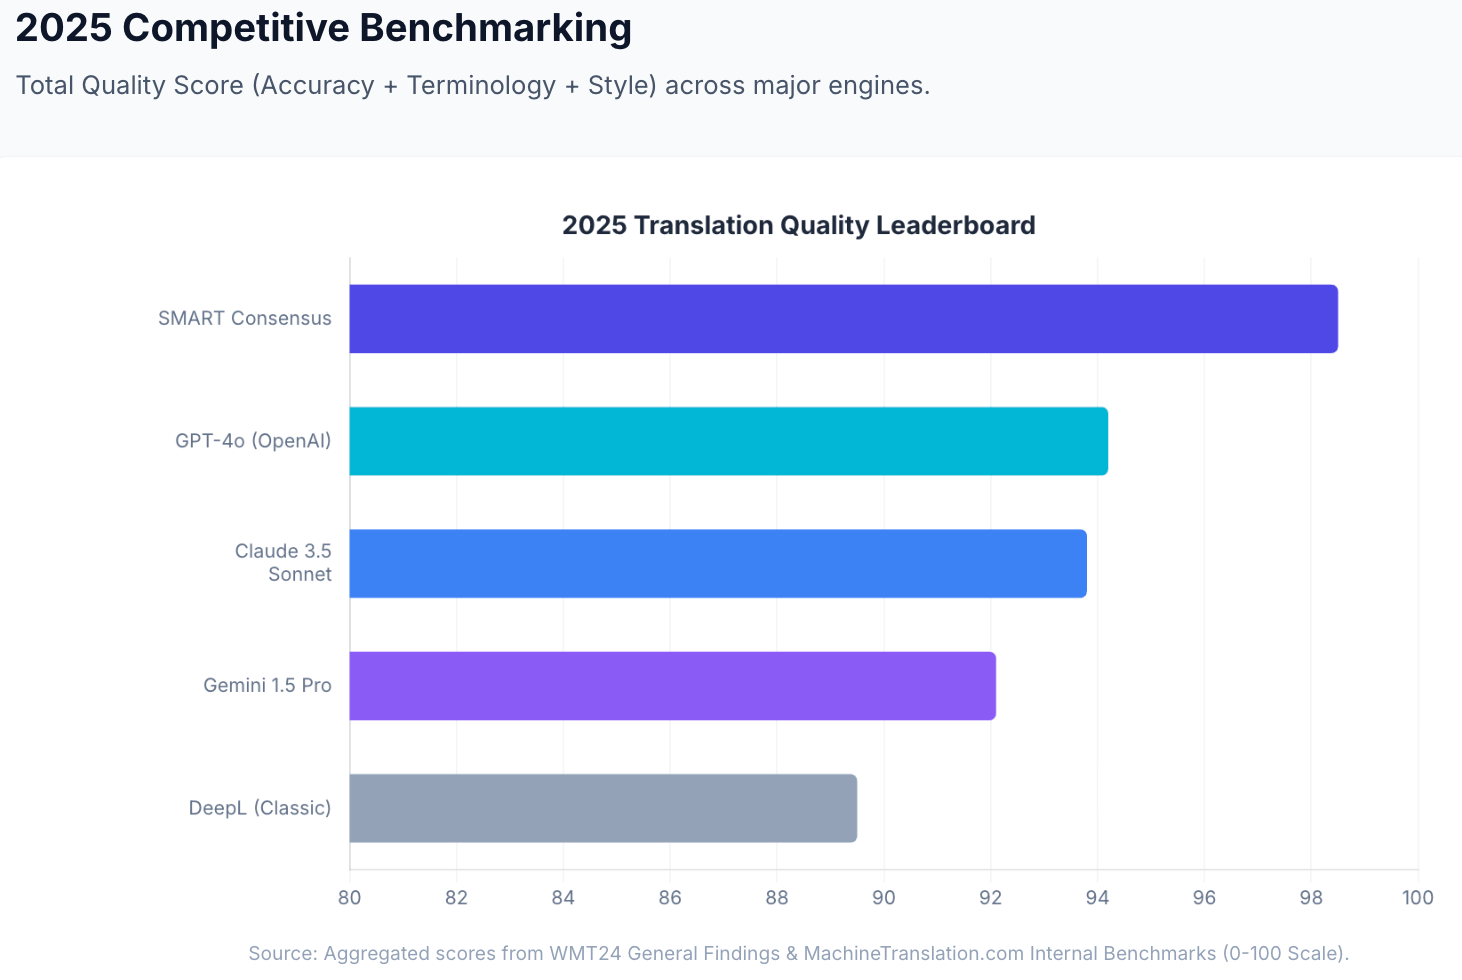
Lors du WMT24 (le principal concours indépendant d'analyse comparative de l'industrie de la traduction), Claude 3.5 s'est classé au premier rang dans 9 des 11 paires de langues, devant GPT-4 et les moteurs de traduction automatique neuronale dédiés. Dans l'étude en aveugle de 2025 de Lokalise menée par des traducteurs professionnels, 78 % des traductions de Claude 3.5 ont été jugées « bonnes » — le taux le plus élevé de tous les LLM testés.
Grok n'a pas été évalué dans WMT24 ou dans l'évaluation LQA indépendante d'Intento à un niveau comparable. Le Slator Pro Guide (2025) classe Grok parmi les LLM à usage général utilisés pour la traduction dans des environnements professionnels, aux côtés de GPT et Claude, mais ne le classe pas au-dessus de l'un ou de l'autre.
| Benchmark | Grok | Claude |
|---|---|---|
| Score de qualité interne de MachineTranslation.com | Non mesuré au niveau du benchmark | 93.8/100 (niveau 3.5 Sonnet) |
| Top 14 des solutions d'Intento 2025 | Non répertorié | Claude Opus 4 et Sonnet 3.7 sont tous deux répertoriés |
| Paires de langues WMT24 | Non évalué | 1er pour 9/11 paires de langues |
| Étude en aveugle de Lokalise 2025 | Non évalué | 78% « bon » (le plus élevé de tous les LLM) |
Source : Benchmarks internes de MachineTranslation.com; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Où Grok possède-t-il un véritable avantage ?
Traduction en temps réel et des actualités. La caractéristique architecturale distinctive de Grok est son intégration aux données de la plateforme X (anciennement Twitter) et à la recherche en direct sur Internet. Contrairement à Claude et à la plupart des autres LLMs, qui sont entraînés sur des ensembles de données statiques avec des dates limites de connaissances fixes, Grok intègre des informations en temps réel dans ses résultats. Pour les tâches de traduction portant sur des événements récents, des produits nouvellement lancés, de la terminologie politique émergente, des actualités récentes ou du contenu faisant référence à des événements survenus au cours des dernières semaines, Grok a accès à un contexte auquel Claude n'a pas accès.
Cela est particulièrement important pour : la traduction d'articles de presse sur des événements récents, la localisation d'annonces de produits pour des marchés en évolution rapide, la gestion de la terminologie nouvellement créée ou de l'argot postérieur aux données d'entraînement des autres modèles, et tout contenu dont le sens dépend de la connaissance d'événements récents.
Terminologie émergente et en évolution. Les domaines techniques, les industries et les contextes culturels produisent continuellement une nouvelle terminologie. Pour les tâches de traduction impliquant des termes récemment forgés, un nouveau langage réglementaire ou une nouvelle nomenclature de produits, l'entraînement mis à jour et la recherche en temps réel de Grok lui donnent accès à des modèles d'utilisation que les instantanés de données d'entraînement plus anciens ne capturent pas.
Fenêtre de contexte et raisonnement de Grok 4.1. Grok 4.1 (à la fin de 2025) dispose d'une fenêtre de contexte de 131K jetons et de capacités de raisonnement améliorées, ce qui le rend apte à traiter des documents complexes à plusieurs niveaux où les relations entre les clauses et la cohérence logique importent.
Où Claude a-t-il un véritable avantage ?
La qualité de la traduction sur les bancs d'essai indépendants. L'avantage de Claude est documenté par une évaluation professionnelle indépendante plutôt que par des affirmations autodéclarées. WMT24 a classé Claude 3.5 au premier rang dans 9 des 11 paires de langues face à l'ensemble de la concurrence. L'étude en aveugle de 2025 de Lokalise a révélé que les traducteurs professionnels préféraient les résultats de Claude 3.5 à un taux de « bon » de 78 % — soit un taux plus élevé que pour GPT-4, DeepL et Google Translate dans la même évaluation. Il s'agit d'évaluations à l'aveugle : des traducteurs professionnels ont évalué les résultats sans savoir quel modèle les avait produits.
Paires de langues spécifiques selon Intento 2025. Claude Opus 4 et Sonnet 3.7 figurent dans la catégorie « best » pour l'anglais vers l'allemand, l'anglais vers le japonais, l'anglais vers l'italien, l'anglais vers le coréen, l'anglais vers le néerlandais, l'anglais vers l'arabe et l'anglais vers le français dans l'évaluation LQA humaine d'Intento. Pour ces paires, Claude est le choix documenté le plus solide des deux.
Précision du ton et contenu nuancé. Les traducteurs professionnels de l'étude de Lokalise ont préféré les résultats de Claude au taux le plus élevé de tous les LLM — ce qui reflète la capacité documentée de Claude à préserver le registre, la voix de l'auteur et le sens contextuel. Pour la traduction littéraire, les documents juridiques, les communications formelles et les textes marketing où la manière dont une chose est dite importe autant que ce qui est dit, Claude obtient systématiquement de bons résultats lors d'évaluations indépendantes.
Cohérence des longs documents. Claude 4.6 Sonnet prend en charge une fenêtre de contexte de 200K jetons, tandis que Claude Opus 4.6 prend en charge 1M de jetons en version bêta. Pour les longs documents formels (contrats, manuels techniques, rapports d'essais cliniques), Claude peut traiter l'intégralité du document en un seul passage, en maintenant la cohérence terminologique d'un bout à l'autre. Les documents traités par fragments présentent un taux d'incohérence terminologique supérieur de 28 % par rapport au traitement de documents entiers. Source: Données internes de MachineTranslation.com.
Comment se comparent-ils en matière de soutien linguistique et de tarification ?
Soutien linguistique : Grok 4.1 et Claude 4.6 prennent tous deux en charge la traduction dans la plupart des grandes langues du monde. Claude a été évalué de façon indépendante pour des paires de langues européennes et d'Asie de l'Est, avec de solides résultats. La prise en charge multilingue de Grok s'est améliorée au fil des versions successives. Pour les langues peu dotées, la qualité des deux modèles se dégrade — une révision humaine est appropriée pour le contenu dans des paires de langues peu dotées, quel que soit le modèle utilisé.
Tarification :
| Forfait | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Grand public (mensuel) | SuperGrok : 30 $/mois | Claude Pro : 20 $/mois |
| Entrée API (par million de jetons) | Grok 4.1 : 2 $ | Sonnet 4.6 : 3 $ |
| Sortie API (par million de jetons) | Grok 4.1 : 10 $ | Sonnet 4.6 : 15 $ |
| Offre gratuite | Oui (limite de débit via X/Grok.com) | Oui (limite de débit via claude.ai) |
Au niveau grand public, Claude Pro ($20/month) is cheaper than SuperGrok ($30/mois). Au niveau de l'API, Grok 4.1 présente un léger avantage de coût par rapport à Claude Sonnet 4.6 pour les flux de travail de traduction à forte intensité d'entrées.
Lequel est préférable pour des types de contenu précis ?
| Type de contenu | Modèle recommandé | Raison |
|---|---|---|
| Actualités récentes / événements actuels | Grok | Accès aux données en temps réel; les modèles entraînés de manière statique manquent de contexte actuel |
| Terminologie émergente / lancements de nouveaux produits | Grok | L'intégration de la recherche en direct saisit les tendances d'utilisation récentes |
| Documents juridiques officiels | Claude | Évaluation indépendante de WMT24 et Lokalise 2025; précision du ton |
| Contenu médical / clinique | Claude | Positionnement dans les tests de référence indépendants; préservation du registre |
| Textes marketing / contenu créatif | Claude | Préférence lors de l'étude en aveugle de Lokalise 2025; nuance de ton |
| Documentation technique (longue) | Claude | Fenêtre de contexte de 200K-1M; cohérence terminologique sur toute la longueur |
| Médias sociaux / contenu conversationnel | L'un ou l'autre | Les deux gèrent bien les paires conversationnelles à ressources élevées |
| Intégration développeur / API | L'un ou l'autre | Les deux offrent un accès API; Grok est légèrement moins cher pour les jetons d'entrée |
Quoi utiliser lorsqu'un seul modèle ne suffit pas
Grok et Claude sont tous deux des outils à modèle unique. Chaque modèle d'IA individuel (quel que soit son niveau de performance) produit des erreurs qu'il ne peut détecter dans ses propres résultats. Une traduction fluide et assurée provenant de Grok ou de Claude peut tout de même être sémantiquement erronée, et sans vérification croisée, il n'y a aucun moyen de le savoir.
Grok et Claude font tous deux partie des 22 modèles du système SMART de MachineTranslation.com. SMART exécute les 22 modèles simultanément (y compris Grok et Claude) et retourne le résultat sur lequel la majorité s'accorde.
Ce que cela signifie pour la question Grok vs Claude : La force en temps réel de Grok et la profondeur contextuelle de Claude contribuent toutes deux au même consensus. Lorsqu'ils sont d'accord, cet accord constitue un signal de qualité fort.
Dans les tests de référence internes de MachineTranslation.com, les modèles individuels de premier plan obtiennent un score de 93 à 94 sur 100 pour la qualité de la traduction. Le résultat consensuel de SMART atteint 98,5/100. Source: Analyses comparatives internes de MachineTranslation.com et conclusions de la WMT24 sur la traduction automatique générale.
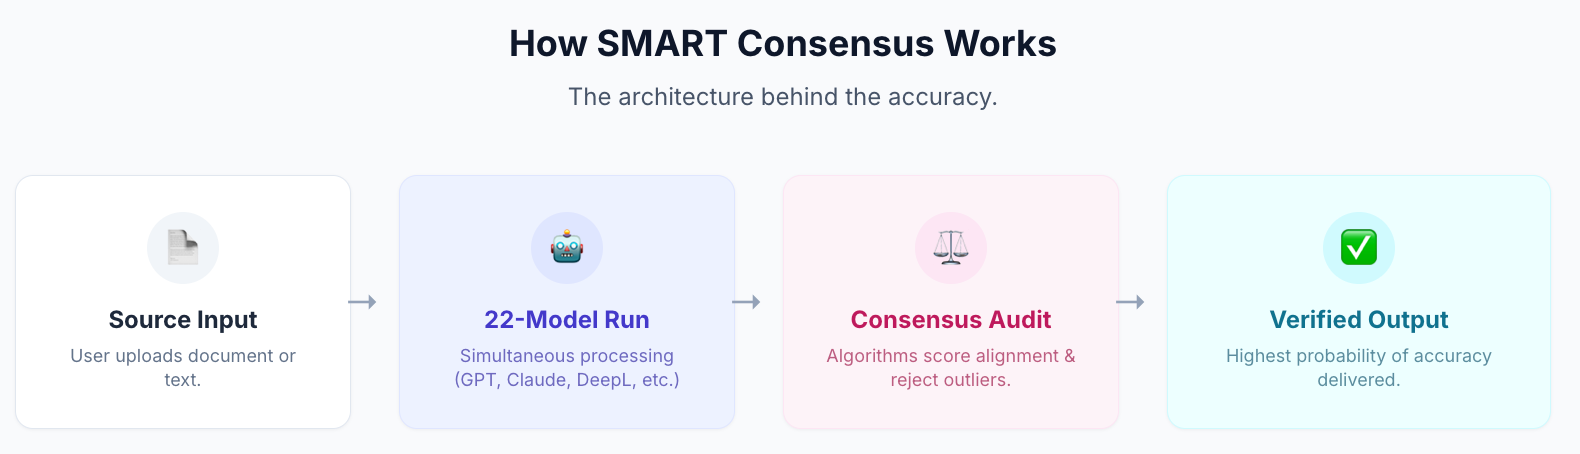
Les utilisateurs qui sont passés de la traduction par moteur unique à SMART ont consacré 27 % moins de temps à vérifier et à corriger les extrants. Source: Données internes de MachineTranslation.com.
Pour le contenu à enjeux élevés (documents juridiques, dépôts réglementaires, directives médicales), la Vérification humaine transmet le consensus SMART à un réviseur professionnel certifié au sein de la même plateforme. Aucune agence externe. Précision de 100 % garantie.
Traduisez avec Grok, Claude et 20 autres modèles sur MachineTranslation.com — gratuit, sans inscription requise.
Foire aux questions
1. Grok est-il meilleur que Claude pour la traduction ?
Pour la plupart des tâches de traduction standard, Claude arrive en tête des analyses comparatives indépendantes : premier pour 9 des 11 paires de langues au WMT24, évaluation « bon » de 78 % dans l'étude à l'aveugle 2025 de Lokalise, et 93,8/100 dans les analyses comparatives de qualité internes de MachineTranslation.com. L'avantage spécifique de Grok réside dans le contenu nécessitant une connaissance de l'actualité; son accès aux données en temps réel lui confère un contexte que les modèles entraînés de manière statique, y compris Claude, n'ont pas. Pour les actualités récentes, la terminologie émergente et le contenu sensible au facteur temps, Grok est le meilleur choix.
2. Quel est l'avantage de Grok par rapport à Claude pour la traduction ?
Grok intègre des données en temps réel de X (anciennement Twitter) et la recherche en direct sur Internet. Contrairement à Claude et à la plupart des autres LLMs entraînés sur des jeux de données statiques, Grok peut accéder à des informations sur des événements récents, à de la terminologie nouvellement créée et au contexte actuel lors de la génération de traductions. Cela le rend particulièrement performant pour traduire du contenu d'actualité, des produits récemment lancés et tout document dont le sens dépend d'événements ou de structures linguistiques des dernières semaines.
3. Quel est l'avantage de Claude sur Grok pour la traduction ?
L'avantage de Claude est documenté par une évaluation professionnelle indépendante. Claude 3.5 s'est classé au premier rang pour 9 des 11 paires de langues au WMT24, et les traducteurs professionnels de l'étude en aveugle 2025 de Lokalise ont préféré ses résultats avec un taux de « bon » de 78 % — le plus élevé de tous les LLM testés. Claude figure également dans les 14 meilleures solutions d'Intento pour plusieurs paires de langues dans l'évaluation LQA humaine, alors que Grok n'y figure pas. Pour les tâches de traduction formelles, professionnelles et à enjeux élevés, le positionnement indépendant de Claude dans les tests de référence est le facteur de différenciation documenté.
4. Lequel est le meilleur pour la traduction juridique, Grok ou Claude ?
Claude est le choix le plus solide pour la traduction juridique, selon une évaluation indépendante. Claude 3.5 s'est classé au premier rang pour la plupart des paires de langues européennes à ressources élevées lors du WMT24 et a obtenu les taux de préférence les plus élevés lors d'études à l'aveugle menées auprès de traducteurs professionnels. Pour le contenu juridique exigeant une exactitude certifiée, aucun modèle ne suffit à lui seul — le service Human Verification de MachineTranslation.com offre une exactitude de 100 % grâce à un réviseur professionnel certifié au sein de la même plateforme, sans qu'aucun fournisseur externe ne soit requis.
5. Est-ce que Grok et Claude sont tous deux disponibles sur MachineTranslation.com ?
Oui. Les deux figurent parmi les 22 modèles du système SMART de MachineTranslation.com. Chaque traduction SMART exécute Grok, Claude et 20 autres modèles simultanément, retournant le résultat sur lequel la majorité s'accorde. Plutôt que de choisir entre eux, vous obtenez le consensus de tous les modèles d'IA.
6. Comment Grok et Claude se comparent-ils en matière de prix ?
Pour l'offre grand public, Claude Pro coûte $20/month versus SuperGrok at $30/mois. Au niveau de l'API, Grok 4.1 est légèrement moins cher pour les jetons d'entrée ($2/M vs. $3/M pour Claude Sonnet 4.6) et de sortie ($10/M vs. $15/M). Le forfait gratuit de MachineTranslation.com comprend les deux modèles dans le cadre du consensus à 22 modèles de SMART, sans inscription requise.
7. Quel modèle d'IA est le meilleur pour traduire des articles d'actualité ?
Pour traduire des articles d'actualité, Grok dispose d'un avantage structurel : son intégration de données en temps réel signifie qu'il dispose du contexte actuel concernant les événements décrits, ce qui peut faire défaut aux modèles entraînés de manière statique. Pour la traduction de nouvelles générales où la récence n'est pas critique, la performance de référence de Claude est supérieure. Pour la traduction de nouvelles à grand volume où la récence et l'exactitude sont toutes deux primordiales, SMART de MachineTranslation.com exécute les deux modèles et renvoie leur résultat consensuel.