November 13, 2026
Qwen c. Gemini pour la traduction et pourquoi le sens de la traduction compte
Vous avez deux modèles et une liste de paires de langues, et vous devez décider à quel modèle confier le projet. La plupart des comparaisons entre Qwen et Gemini répondent par un seul score global. Je pense qu'un seul score masque ce qui détermine le résultat, c'est-à-dire la direction de la traduction.
Je travaille sur la façon dont nous testons les modèles qui tournent sur MachineTranslation.com, ce qui me permet de comparer Qwen et Gemini sur 98 paires de langues évaluées sur un texte identique. Gemini a obtenu un meilleur score dans 68 de ces paires et Qwen dans 29, et l'écart moyen est de 0,08 point sur 10. Les totaux à eux seuls ne vous indiquent pas quel modèle choisir pour traduire de l'ourdou vers l'anglais ou de l'anglais vers le créole haïtien.
Cet article montre où les deux modèles sont très proches et où chacun prend l'avantage. Il indique également ce que je ne peux pas encore vous dire. Mes données s'arrêtent au 8 août 2026, avant que Google n'annonce Gemini 4 en octobre, elles décrivent donc les versions antérieures des deux modèles.
Points à retenir
- Sur 98 paires de langues évaluées sur un texte identique (du 12 juillet au 8 août 2026), Gemini a obtenu un score plus élevé dans 68 paires, Qwen dans 29, et une paire a terminé à égalité.
- L'écart moyen est faible, soit 9,06 pour Gemini contre 8,98 pour Qwen, et 60 des 98 paires se situent dans une marge de 0,1 point.
- Pour la traduction vers l'anglais, Qwen mène par plus de 0,1 point dans 7 paires sur 27 et Gemini dans 3; les 17 autres se situent dans une marge de 0,1 point.
- Pour la traduction à partir de l'anglais, Gemini mène par plus de 0,1 point dans 13 paires sur 29 et Qwen dans aucune.
- Les données s'arrêtent avant que Google n'annonce Gemini 4 en octobre 2026, elles décrivent donc les versions antérieures de Gemini et nécessitent une nouvelle série de tests avant d'être considérées comme actuelles.
Qwen ou Gemini est-il meilleur pour la traduction?
Tout dépend de la direction, car les deux modèles sont très proches lorsque la langue cible est l'anglais et Gemini obtient de meilleurs scores dans la plupart des autres paires. Sur l'ensemble des 98 paires, Gemini a obtenu un score plus élevé dans 68 d'entre elles. Selon les scores de MachineTranslation.com du 12 juillet au 8 août 2026, Gemini a obtenu une moyenne de 9,06 sur 10 et Qwen 8,98, soit un écart moyen de 0,08 point.
L'échantillon ne prend en compte que les segments pour lesquels ChatGPT, Claude, DeepSeek, Gemini et Qwen ont tous reçu un véritable score, de sorte que chaque modèle est évalué sur un texte source identique. Chaque paire de langues compte au moins 30 segments. J'utilise cet échantillon parce qu'il élimine une erreur courante, soit celle de comparer des modèles sur des textes différents.
En nombre absolu, Gemini est en tête dans 68 paires (69 %), Qwen dans 29 (30 %), et une paire est à égalité. Le décompte à lui seul exagère l'écart, puisque 60 des 98 paires se situent dans une marge de 0,1 point. Les sections suivantes ventilent les résultats par direction et par marge.
Quelles directions de traduction avantagent chaque modèle?
Gemini mène lorsque l'anglais est la langue source ou lorsqu'aucune des langues n'est l'anglais, et Qwen est au même niveau ou en tête lorsque l'anglais est la langue cible. À partir de l'anglais, Gemini mène par plus de 0,1 point dans 13 paires sur 29 et Qwen dans aucune. Vers l'anglais, Qwen mène par cette marge dans 7 paires sur 27 et Gemini dans 3.
| Direction | Paires | Gemini en tête de plus de 0,1 | À moins de 0,1 point | Qwen en tête de plus de 0,1 | Écart moyen |
|---|---|---|---|---|---|
| Vers l'anglais | 27 | 3 | 17 | 7 | Qwen +0,04 |
| Depuis l'anglais | 29 | 13 | 16 | 0 | Gemini +0,16 |
| Aucune des deux langues en anglais | 42 | 14 | 27 | 1 | Gemini +0,13 |
Vers l'anglais, 17 paires sur 27 se situent à moins de 0,1 point, Qwen mène dans 7 cas et Gemini mène dans 3 cas. Depuis l'anglais, 16 paires sur 29 se situent à moins de 0,1 point, Gemini mène dans 13 cas et Qwen ne mène dans aucun cas. Lorsque ni l'une ni l'autre des langues n'est l'anglais, 27 paires sur 42 se situent à moins de 0,1 point, Gemini mène dans 14 cas et Qwen mène dans 1 cas.
Qwen se situe à moins de 0,1 point de Gemini ou devant dans 24 des 27 paires vers l'anglais. En moyenne par direction, Qwen a une avance d'environ 0,04 point vers l'anglais, tandis que Gemini a une avance d'environ 0,16 point depuis l'anglais et de 0,13 point entre deux langues autres que l'anglais.
Je ne sais pas pourquoi cette divergence apparaît, et ces données ne peuvent pas me l'indiquer. Une explication que je testerais en premier est la composition des textes d'entraînement derrière chaque modèle, mais je n'ai pas effectué ce test. Qwen présente un profil similaire face à ChatGPT. Sur le même panel, notre comparaison entre Qwen et ChatGPT a révélé que les deux modèles étaient presque à égalité vers l'anglais, ChatGPT étant en tête dans 89 % des autres paires.
Quelles paires de langues présentent les écarts les plus importants?
Les écarts les plus importants avantagent Gemini. Il mène de 0,51 à 0,95 point pour le russe vers le kazakh, l'anglais vers le créole haïtien, l'anglais vers le tagalog, l'espagnol vers le grec et l'arabe vers le persan. Les plus grandes avances de Qwen sont plus modestes, se situant entre 0,15 et 0,26 point, et quatre de ses cinq meilleures sont des paires vers l'anglais.
| Paire de langues | Score de Gemini | Score de Qwen | Écart |
|---|---|---|---|
| Russe vers kazakh | 9,27 | 8,32 | Gemini +0,95 |
| Anglais vers créole haïtien | 9,19 | 8,27 | Gemini +0,92 |
| Anglais vers tagalog | 9,14 | 8,43 | Gemini +0,70 |
| Espagnol vers grec | 8,90 | 8,33 | Gemini +0,57 |
| Arabe vers persan | 8,84 | 8,34 | Gemini +0,51 |
| Ourdou vers anglais | 8,56 | 8,81 | Qwen +0,26 |
| Chinois vers anglais | 9,00 | 9,19 | Qwen +0,19 |
| Suédois vers anglais | 8,29 | 8,46 | Qwen +0,16 |
| Chinois vers indonésien | 9,03 | 9,19 | Qwen +0,16 |
| Birman vers anglais | 8,94 | 9,09 | Qwen +0,15 |
Je ne considérerais pas ces résultats comme des classements définitifs. Les deux écarts les plus importants, russe vers kazakh et anglais vers créole haïtien, reposent sur des échantillons plus petits que la paire médiane. Anglais vers tagalog, espagnol vers grec et arabe vers persan reposent sur des échantillons plus grands, j'accorderais donc davantage de confiance à ces trois-là. Je testerais de nouveau les deux écarts aux échantillons restreints avant de m'y fier.
Que signifie un écart de 0,1 point?
Selon moi, un écart inférieur à 0,1 point est trop faible pour désigner un gagnant. Sur les 98 paires, 60 se situent à l'intérieur de cette marge, et chaque paire est évaluée sur un nombre limité de segments. La barre de 0,1 est mon propre seuil de travail, et je n'ai pas effectué de test de signification sur ces paires.
Un score passe aussi à côté de certaines différences. Dans nos tests d'expressions courantes, nous avons soumis « sorry » en arabe à 22 modèles d'IA. Gemini et Qwen ont tous deux choisi le terme informel آسف. ChatGPT et le résultat combiné ont choisi le terme formel عذرًا. Chaque modèle a obtenu 9,5, de sorte que les deux mots diffèrent quant au registre et que le score n'a pas bougé.
C'est pourquoi j'analyse la marge et les exemples de registre ensemble. Un faible écart avec une différence de registre visible nécessite une décision humaine. Un écart important sur un échantillon restreint nécessite un nouveau test.
Qwen et Gemini font-ils des types d'erreurs différents?
Oui, car dans notre test de citations de la Coupe du monde 2026, les deux modèles ont fait au moins un choix que les autres modèles n'ont pas fait, et les scores ont à peine bougé. Gemini a traduit une phrase de Mbappé par « with each game » et a rendu une citation de Wirtz mot à mot, tandis que Qwen a donné une interprétation différente d'une citation de Scaloni. Les scores pour ces cas variaient de 9,2 à 9,5.
Les détails proviennent de notre test de citations de la Coupe du monde. Sur la citation de Mbappé à propos de regarder vers l'avenir, les autres modèles ont conservé « match », tandis que Gemini a écrit « with each game », un léger glissement de registre qui a obtenu un score de 9,4. Sur une citation de Wirtz, Gemini a traduit une phrase mot à mot et en a changé le sens, obtenant également 9,4. Sur la citation de Scaloni, la plupart des modèles ont convergé vers une seule interprétation, tandis que Qwen a écrit « that is what matters » et a obtenu un score de 9,4. Sur la citation tactique de Mbappé, Claude et DeepSeek ont choisi l'anglais britannique du soccer, tandis que Gemini, Qwen et les autres ont choisi l'anglais américain, et Qwen a obtenu un score de 9,2, inférieur au reste.
J'interprète cela comme de petites habitudes. Les exemples de Gemini concernent le registre et la tournure littérale. Ceux de Qwen concernent le choix de l'interprétation d'une phrase. Quatre exemples sont trop peu pour parler d'une tendance, mais ils montrent le genre de différence qu'un score unique dissimule.
Quel modèle Qwen est le meilleur pour la traduction?
Je ne peux pas me prononcer à partir de nos données, car les scores de MachineTranslation.com traitent Qwen comme un seul modèle sans étiquette de version. Chez Alibaba, la famille Qwen3.8 est arrivée sur Hugging Face en août 2026, de sorte que plusieurs versions existent désormais, et les scores présentés dans cet article ne les distinguent pas.
J'aimerais ventiler ces données par version, mais je ne le peux pas encore. Le résultat au niveau de la plateforme pourrait être une moyenne de plus d'une version de Qwen ayant fonctionné durant cette période. Si vous devez choisir entre différentes versions de Qwen pour un projet, je vous conseille de les comparer sur un échantillon de vos propres textes.
Quelles sont les solutions de rechange à Gemini pour la traduction?
ChatGPT, Claude, DeepSeek, Qwen, Grok et Mistral AI fonctionnent tous sur MachineTranslation.com, et la bonne solution de rechange dépend de la paire. Dans nos scores du 12 juillet au 8 août 2026, Qwen se situe à moins de 0,1 point de Gemini ou devant lui dans 24 des 27 paires vers l'anglais. Nos scores pour Mistral AI en français montrent que sa moyenne du français vers l'anglais se situe 0,40 point au-dessus de celle de Gemini.
Si votre solution de rechange est ChatGPT, la réponse varie aussi selon la paire. Dans notre ventilation publiée de l'espagnol vers l'anglais, Gemini a remporté 31 % des segments et ChatGPT en a remporté 21 %. Pour le français, aucun des deux modèles ne l'emporte dans les deux directions. Comme le choix varie selon la paire, MachineTranslation.com ne retient pas une seule solution de rechange. Elle les exécute ensemble.
Je suggère de partir de la paire et de la direction, puis de regarder quelle solution de rechange convient le mieux.
Comment MachineTranslation.com montre-t-il les divergences entre Qwen et Gemini?
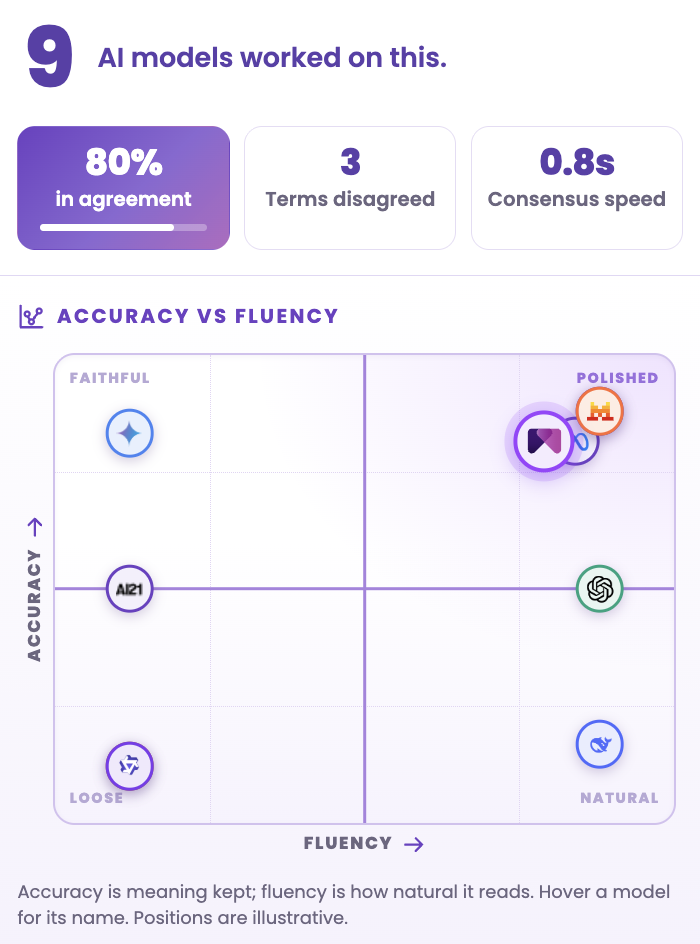
MachineTranslation.com exécute les deux modèles sur chaque traduction et montre où les modèles s'accordent et où ils divergent. Le panneau d'accord indique combien de modèles d'IA ont travaillé sur le texte, la proportion d'accord, le nombre de termes contestés et la vitesse à laquelle le consensus s'est formé.
À quel point ces résultats sont-ils récents?
Ces résultats couvrent la période du 12 juillet au 8 août 2026, ils décrivent donc les versions de Gemini et de Qwen qui tournaient à ce moment-là. Google a annoncé Gemini 4 en octobre 2026. La famille Qwen3.8 d'Alibaba est arrivée en août 2026. Ma recommandation est de réexécuter le panel avant de se fier à ces chiffres pour un nouveau projet.
Je m'attends à ce que la méthode consistant à comparer un texte identique avec une marge pour le bruit tienne le coup. Je m'attends à ce que la taille des écarts change. Je considérerais toute paire où le meneur change lors d'une nouvelle exécution comme un signe que l'écart précédent se situait dans la marge de bruit.
Comment choisirais-je entre Qwen et Gemini pour un projet?
Mon avis est de choisir selon la paire et la direction, et d'éviter de faire un choix unique pour l'ensemble d'un projet. En pratique, cela signifie considérer un écart de moins de 0,1 point comme une égalité et s'attendre à ce que le modèle en tête change d'une paire à l'autre. Voici l'ordre que je suivrais.
- Dressez la liste de chaque paire de langues du projet et notez sa direction.
- Vérifiez l'écart pour chaque paire dans cet article. Considérez un écart inférieur à 0,1 point comme une égalité.
- Lorsque l'écart est plus grand, commencez par le modèle en tête et testez un échantillon de votre propre texte.
- Si votre contenu va dans les deux directions, attendez-vous à ce que le meneur change d'une paire à l'autre.
- Vérifiez de nouveau lorsque l'un ou l'autre des modèles lance une nouvelle version.
Les deux modèles fonctionnent aux côtés de 20 autres pour chaque traduction sur MachineTranslation.com. La version sur laquelle la plupart s'entendent est retenue, de sorte que le choix n'a pas à être fait une fois pour l'ensemble du projet. L'ensemble complet des résultats des modèles se trouve dans nos tests de comparaison de modèles.
Foire aux questions
1. Est-ce que Qwen ou Gemini est meilleur pour la traduction?
Cela dépend de la direction, car Qwen se situe à moins de 0,1 point de Gemini ou le devance dans 24 des 27 paires vers l'anglais. Gemini a tout de même obtenu un meilleur résultat dans 68 des 98 paires selon les pointages du 12 juillet au 8 août 2026 de MachineTranslation.com. L'écart moyen est de 0,08 point sur 10, je choisirais donc par paire.
2. Quel modèle Qwen est le meilleur pour la traduction?
Je ne peux pas me prononcer à partir de nos données, car les pointages de MachineTranslation.com traitent Qwen comme un seul modèle sans étiquette de version. La gamme Qwen3.8 d'Alibaba est arrivée sur Hugging Face en août 2026, de sorte que plusieurs versions existent maintenant. En attendant que les pointages les distinguent, je comparerais les versions sur un échantillon de votre propre texte avant d'en choisir une pour un projet.
3. Quelles sont les solutions de rechange à Gemini pour la traduction?
ChatGPT, Claude, DeepSeek, Qwen, Grok et Mistral AI fonctionnent tous sur MachineTranslation.com. Dans nos pointages du 12 juillet au 8 août 2026, Qwen se situe à moins de 0,1 point de Gemini ou le devance dans 24 des 27 paires vers l'anglais. La moyenne de Mistral AI pour le français vers l'anglais se situait à 0,40 point au-dessus de celle de Gemini. La bonne solution de rechange dépend de la paire.
4. Est-ce que Gemini est meilleur que ChatGPT pour la traduction?
Cela dépend de la paire de langues, car aucun modèle d'IA ne l'emporte partout. Dans notre analyse détaillée publiée pour l'espagnol vers l'anglais, Gemini a remporté 31 % des segments et ChatGPT en a remporté 21 %. Pour le français, aucun des deux modèles ne l'emporte dans les deux directions. Je vérifierais la paire et la direction dont vous avez besoin avant de choisir entre les deux.
5. Est-ce que Gemini est précis pour la traduction?
Oui, car Gemini a obtenu une moyenne de 9,06 sur 10 pour 98 paires de langues dans les scores du July 12 to August 8, 2026 de MachineTranslation.com. La précision varie toujours selon la paire. Son avance est la plus importante à partir de l'anglais, et Qwen le devance de plus de 0,1 point sur 7 des 27 paires vers l'anglais.