October 2, 2026
Qwen vs Grok : quel modèle d'IA traduit le mieux?
Qwen et Grok sont tous deux des modèles d'IA à usage général, et non des outils spécifiques à la traduction, et font tous deux partie de l'ensemble de modèles que MachineTranslation.com exécute pour chaque traduction. Cela est important pour comprendre ce qui suit. Il s'agit d'un aperçu de la façon dont deux des propres modèles de la plateforme se comparent l'un à l'autre, avec les véritables mises en garde inhérentes à ce type de données, et non d'une compétition entre deux concurrents externes et la plateforme elle-même.
Que sont Qwen et Grok?
Qwen est la famille de grands modèles de langage d'Alibaba, actuellement à sa génération Qwen3.8, et a été ajouté à l'ensemble de modèles de MachineTranslation.com dans le cadre de l'expansion continue de la plateforme. Grok est la gamme de modèles de xAI, actuellement à Grok 4.7 au moment d'écrire ces lignes, ayant connu plusieurs versions depuis celle que cet article comparait à l'origine, et s'est joint à la plateforme séparément. Ni l'un ni l'autre de ces modèles n'a été conçu spécifiquement pour la traduction. Les deux sont des systèmes à usage général qui se trouvent à traiter de nombreuses langues dans le cadre de capacités linguistiques plus vastes, ce qui constitue un point de départ différent de celui d'une plateforme conçue et testée spécifiquement pour la qualité de la traduction.
Comment Qwen et Grok se comparent-ils selon les propres données de MachineTranslation.com?
Au cours des 28 derniers jours de trafic sur la plateforme, Grok a obtenu un score moyen plus élevé que Qwen : 9.26 sur 10 contre 8.87. Les 10 % des traductions de Grok ayant obtenu les scores les plus bas ont tout de même conservé une moyenne de 9.2, tandis que les 10 % de Qwen ont chuté à 7.6, soit un écart plus important dans le bas du classement que ce que la moyenne seule laisse entendre.
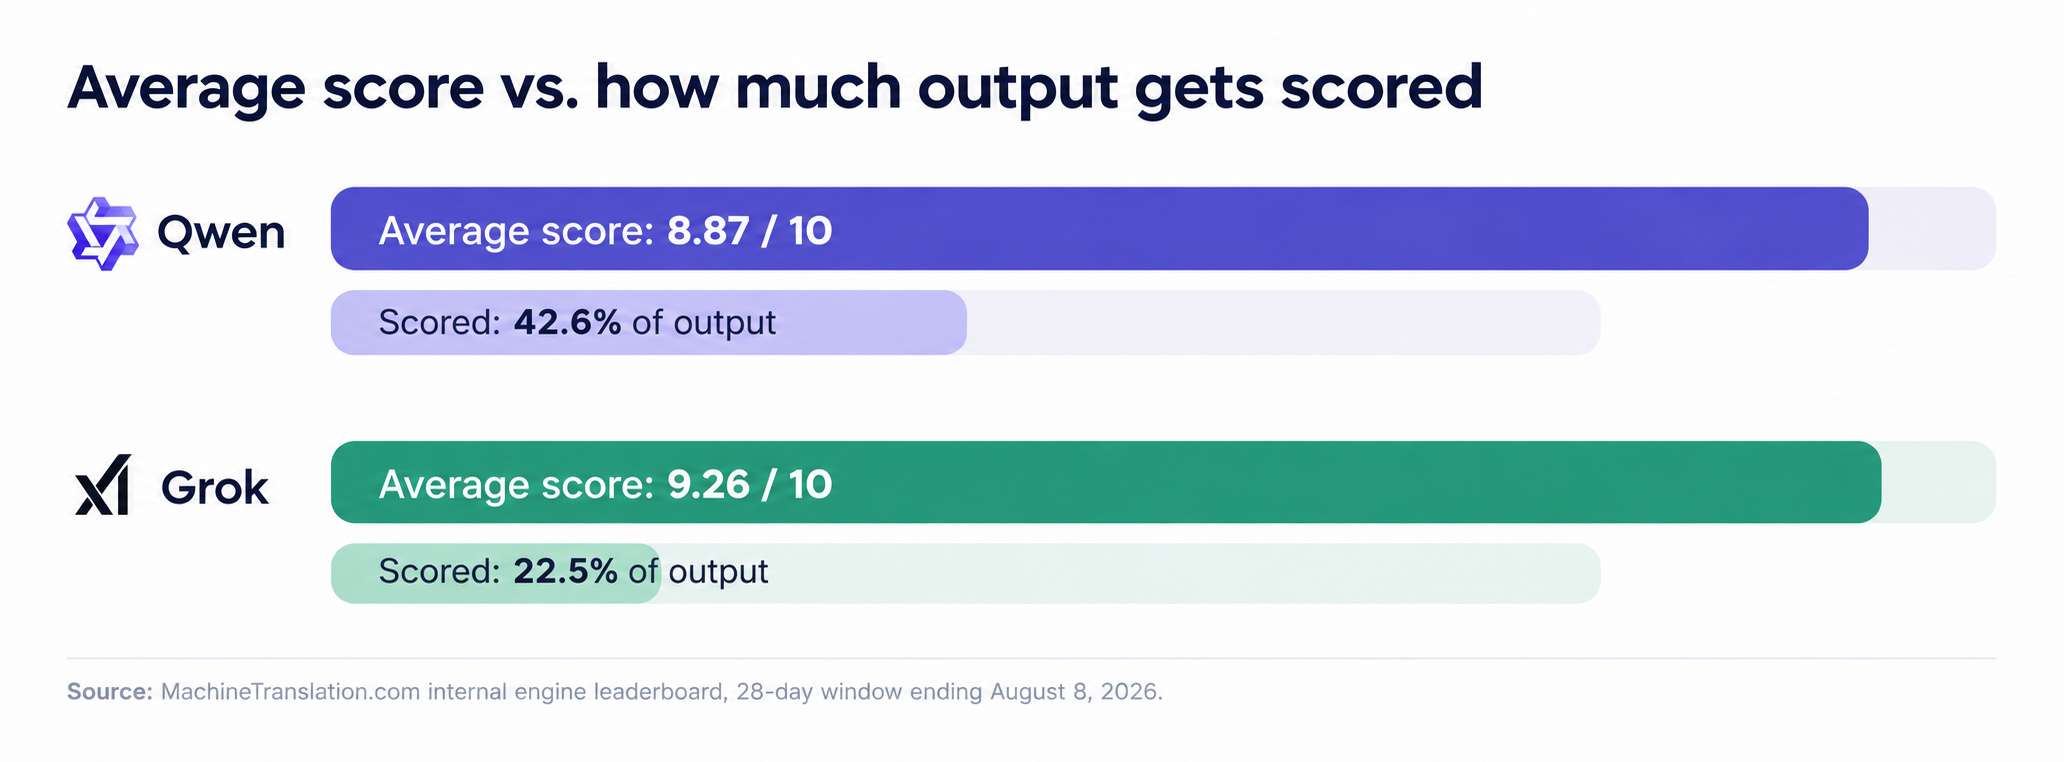
Le score moyen de Grok est plus élevé, mais il repose sur l'évaluation de moins du quart de sa production, contre près de la moitié pour Qwen. Les deux barres racontent différentes parties de la même histoire.
| Qwen | Grok | |
|---|---|---|
| Pourcentage de la production évaluée | 42.6% | 22.5% |
| Score moyen | 8.87 / 10 | 9.26 / 10 |
| Les 10 % des scores les plus bas | 7.6 | 9.2 |
Source : Classement interne des moteurs de MachineTranslation.com, fenêtre de 28 jours se terminant le 8 août 2026.
Le score plus élevé de Grok signifie-t-il que c'est le meilleur choix?
Pas à lui seul. Grok est utilisé beaucoup moins souvent sur la plateforme que Qwen, et moins d'un quart de ses traductions sont évaluées, contre près de la moitié pour Qwen. Un échantillon plus petit et moins représentatif peut faire paraître une moyenne meilleure ou pire qu'elle ne le serait sur le même volume traité par Qwen. Les propres rapports de MachineTranslation.com sur ces données traitent la couverture de l'évaluation comme une véritable limite, et non comme une note de bas de page : un moteur évalué sur une fraction étroite de son trafic n'a pas été testé aussi minutieusement qu'un moteur évalué sur près de la moitié de sa production.
L'interprétation la plus honnête est que les chiffres de Grok sont prometteurs mais moins étoffés. Ceux de Qwen sont plus bas en moyenne, mais reposent sur une base beaucoup plus large et plus représentative. Aucun de ces faits n'annule l'autre.
Qu'en est-il de la couverture linguistique?
Ni Qwen ni Grok ne publient de liste vérifiée de paires de langues pour lesquelles les performances diminuent, et il n'existe aucun test indépendant pour en confirmer une. Ce que l'on peut affirmer avec certitude, c'est qu'aucun de ces modèles n'a été conçu pour offrir une qualité de traduction sur un ensemble de langues spécifique de la même manière qu'une plateforme de traduction dédiée. MachineTranslation.com teste et prend en charge plus de 270 langues directement, ce qui représente un argument bien différent de la capacité multilingue vaste, mais non testée, d'un modèle d'usage général.
Comment MachineTranslation.com utilise réellement Qwen et Grok
MachineTranslation.com exécute Qwen, Grok et plus de 20 autres modèles d'IA sur chaque traduction, puis met en évidence la version sur laquelle ces modèles s'accordent le plus. Aucun modèle n'est exclu en raison d'un score moyen plus bas. L'exécution simultanée de plusieurs modèles permet de repérer les cas où un modèle avec un score moyen plus bas traduit correctement une phrase spécifique qu'un modèle mieux noté rate. Les performances de Qwen varient également selon le sens et la paire de langues d'une manière qu'il est utile de connaître avant de choisir un seul modèle, ce qui est couvert plus en détail dans la comparaison Qwen vs DeepSeek de MachineTranslation.com. Pour un aperçu plus détaillé de la façon dont les modèles sont testés directement les uns par rapport aux autres, consultez les tests complets de comparaison de modèles de MachineTranslation.com.
Foire aux questions
1. Qwen ou Grok est-il meilleur pour la traduction?
Selon les propres données de moteur de MachineTranslation.com sur 28 jours, Grok obtient une note moyenne plus élevée que Qwen, avec 9.26 contre 8.87 sur 10. Toutefois, Grok est évalué sur une part beaucoup plus petite et moins représentative de sa production. Il ne s'agit donc pas d'un véritable face-à-face, comme le serait un test sur des segments appariés.
2. Pourquoi Grok a-t-il une note moyenne plus élevée, mais moins de traductions évaluées?
Grok est utilisé moins souvent sur la plateforme et seulement environ 22.5% de sa production est évaluée, contre 42.6% pour Qwen. Un échantillon plus petit et moins représentatif peut gonfler ou sous-estimer une moyenne, c'est pourquoi cette comparaison doit être lue à titre indicatif, et non définitif.
3. Est-ce que Qwen ou Grok prend en charge plus de langues?
Les deux sont des modèles d'IA généralistes sans liste publiée et vérifiée de limites propres aux langues. Ni l'un ni l'autre n'est conçu spécifiquement pour la traduction, ce qui diffère d'une plateforme qui teste et évalue directement la qualité des traductions dans 270+ langues, au lieu de s'en remettre à un vaste entraînement multilingue en guise de substitut à des performances de traduction mesurées.
4. Est-ce que MachineTranslation.com est en concurrence avec Qwen et Grok?
Non. MachineTranslation.com exécute Qwen, Grok et plus de 20 autres modèles d'IA pour chaque traduction, puis propose la version sur laquelle ces modèles s'accordent le plus. La plateforme teste et combine de tels modèles au lieu d'être en concurrence avec eux en tant que modèle distinct à part entière.
5. Quel modèle d'IA MachineTranslation.com recommande-t-elle pour la traduction?
Aucun, par défaut. Les différents modèles offrent des performances qui varient selon la paire de langues et le type de contenu, et l'écart entre eux peut pencher dans un sens ou dans l'autre selon ce qui est traduit. C'est précisément en raison de cette variation que la plateforme exécute plusieurs modèles pour chaque traduction, au lieu d'en choisir un seul à titre de recommandation permanente.