September 25, 2026
מ-GPT-3 ל-GPT-5: כיצד השתנתה בפועל איכות תרגום ה-AI
GPT-3, GPT-4, ו-GPT-5 מרוחקים חמש שנים וכמה דורות ארכיטקטורה זה מזה, אך השאלה השימושית עבור תרגום אינה "מי מהם החכם ביותר". היא ממוקדת יותר: מה בדיוק השתנה באופן שבו המודלים הללו מתמודדים עם אותם חלקי שפה שאינם ניתנים לתרגום מילה במילה, דברים כמו ביטויים אידיומטיים (ניבים), עמימות ומשלב לשוני (register)? השיפור התרחש במקומות ספציפיים, בנקודות זמן ספציפיות, והוא לא התקדם בקו ישר מהישן לחדש יותר.
מה ש-GPT-3 באמת הציע לתרגום
OpenAI שחררה את GPT-3 בשנת 2020, עוד לפני שתוכנית הבדיקות העצמאית של MachineTranslation.com הייתה קיימת, כך ששום דבר כאן אינו מבחן ביצועים (benchmark) קנייני. זוהי היסטוריה מתועדת היטב, לא תוצאת בדיקה פנימית. GPT-3 היה המודל הראשון מסוגו שהיה מסוגל לייצר טקסט קולח, שנשמע אנושי במספר שפות ללא אימון ייעודי למשימה, מה שהפך אותו לאבן דרך אמיתית. ספציפית עבור תרגום, אותה רהיטות יצרה סיכון של ממש: GPT-3 היה יכול להפיק משפט בטוח בעצמו ובנוי היטב בשפת היעד שעדיין היה שגוי, כאשר שום דבר בפלט לא רמז על כך שהתרחשה טעות.
מה השתנה כש-GPT-4 הגיע
GPT-4 הושק במרץ 2023, ובדיקות המודלים העצמאיות של MachineTranslation.com מתחילות בערך מדור זה. השיפור היה אמיתי אך לא אחיד. בבדיקה של הביטוי האנגלי הדו-משמעי "That's sick" ביפנית, GPT-4.1-nano היה המודל היחיד מתוך שישה שנבדקו שצמצם את הכוונה הכפולה המכוונת של המשפט לפרשנות יחידה, בעוד חמשת האחרים שמרו על העמימות שהביטוי המקורי התכוון להעביר. ניבים היו נקודת תורפה גדולה יותר: בהרצת הביטוי הספרדי "llevarse el gato al agua" דרך חמש גרסאות GPT בו-זמנית, הדגמים הקטנים יותר GPT-4o-mini ו-GPT-4.1-nano הפיקו שניהם את אותו תרגום מילולי ושגוי, ופספסו לחלוטין את הניב.
אותו דפוס הופיע גם במקומות אחרים. הניב הגרמני, "ich verstehe nur Bahnhof", שהורץ דרך שמונה גרסאות-משנה של GPT ושל Claude, תורגם באופן מילולי ושגוי על ידי GPT-4o-mini באופן ספציפי, בעוד שמודל קטן וחדש יותר באותה בדיקה, GPT-4.1-nano, תרגם אותו נכון. דור וגודל המודל לא תאמו באופן עקבי, דפוס שבדיקות גרסאות המודלים של MachineTranslation.com מכסות לעומק רב יותר.
מה ש-GPT-5 שינה עבור תרגום
OpenAI הציגה את GPT-5 כמערכת מאוחדת המנתבת בין מודל ברירת מחדל מהיר לבין מודל חשיבה (reasoning) מעמיק יותר בהתאם למשימה, שינוי מבני בהשוואה לעיצוב המודל היחיד של GPT-4. ה-System Card של OpenAI עבור GPT-5 מדווח כי שיעור השגיאות העובדתיות הכולל של המודל נמוך בכ-45% מזה של GPT-4 וב-80% מזה של GPT-3, שיפור באמינות הכללית שבא לידי ביטוי ספציפית גם בתרגום. הבדיקות של MachineTranslation.com מראות את השיפורים הברורים ביותר במקומות שבהם מודלים מעידן GPT-4 התקשו ביותר: על אותו ניב ספרדי שבו GPT-4o-mini ו-GPT-4.1-nano טעו, גם GPT-5.4-mini וגם GPT-5.4 הגיעו לתרגומים אידיומטיים נכונים, כאשר כל אחד מהם ניסח זאת מעט אחרת אך שניהם הבינו את הניב עצמו.
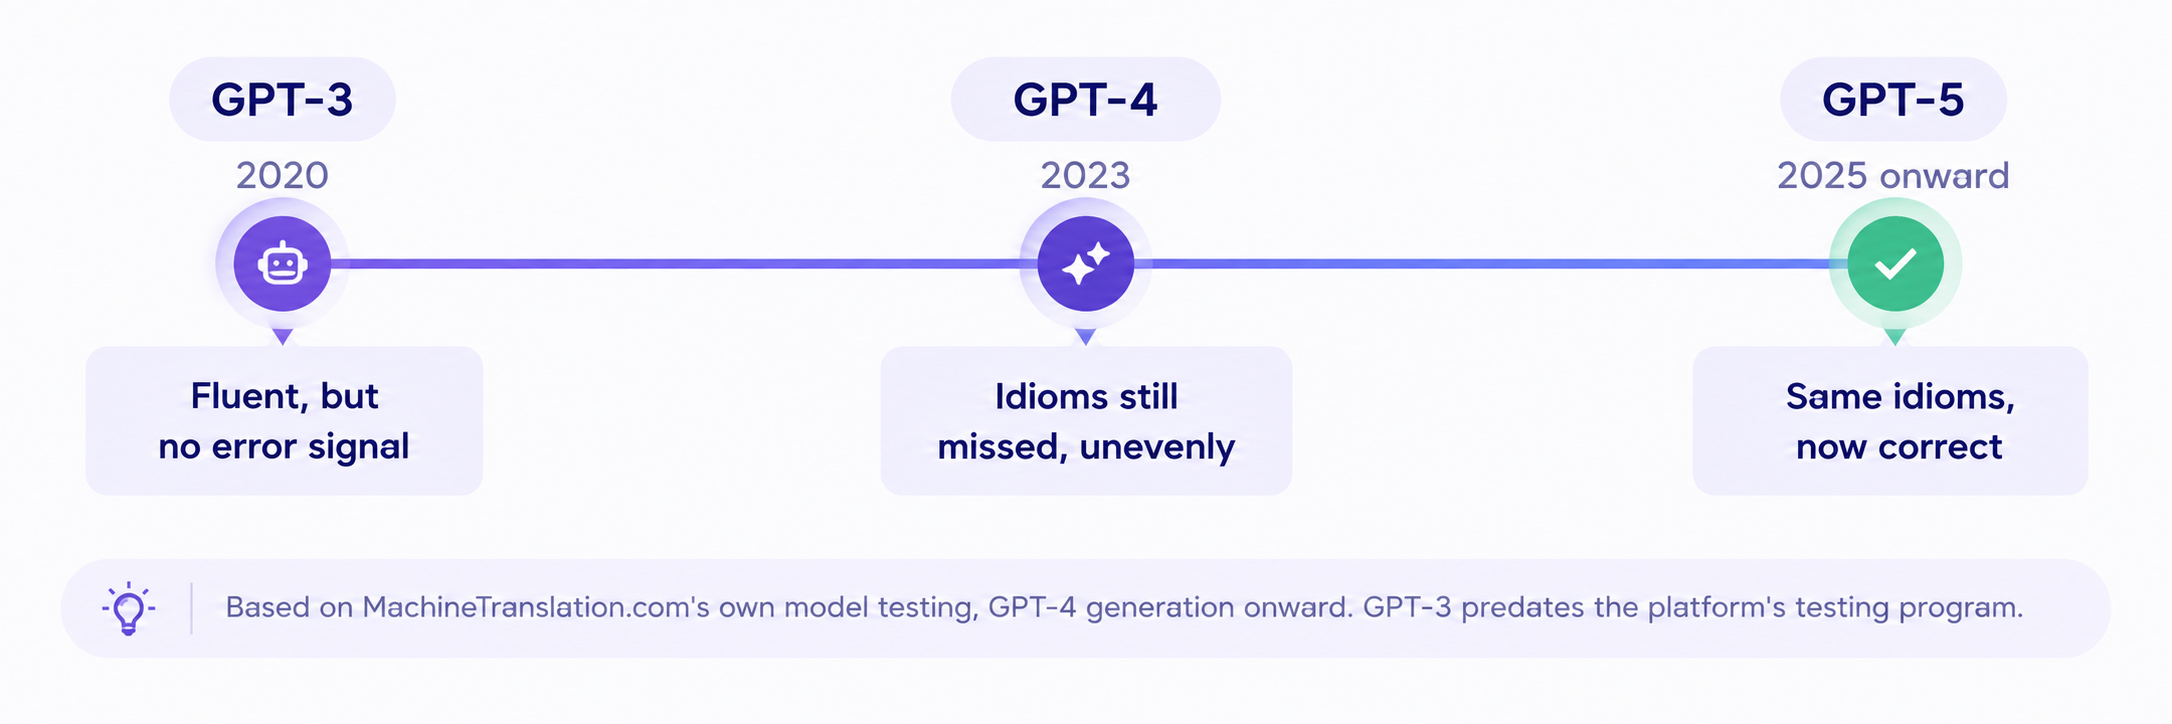
הפער בין הדורות לא היה עלייה הדרגתית ורציפה. הוא התרכז כמעט לחלוטין בשפה אידיומטית ועמומה. בטקסט פשוט וישיר, מודלים מעידן GPT-4 ומעידן GPT-5 משיגים ציונים כמעט זהים.
| GPT-3 | GPT-4 | GPT-5 | |
|---|---|---|---|
| שוחרר | 2020 | מרץ 2023 | 2025, כעת ב-GPT-5.4/5.5 |
| זמין כיום | לא, הוצא משימוש | ב-API בלבד, הוסר מ-ChatGPT | כן, הדור הנוכחי |
| טיפול בניבים | לא נבדק על ידי MachineTranslation.com (קדם לתוכנית) | לא עקבי; פספס לחלוטין מספר ניבים | התמודד נכון עם אותם הניבים ש-GPT-4 פספס |
| טקסט עסקי סטנדרטי | לא נבדק על ידי MachineTranslation.com | חזק, כמעט זהה למודלים מאוחרים יותר | חזק, כמעט זהה ל-GPT-4 |
הנקודה האחרונה הזו חשובה: בדיקה נפרדת של ביטוי עסקי סטנדרטי, "please confirm receipt of this document", שתורגם לגרמנית, החזירה פלט כמעט זהה בכל מודל שנבדק, כולל מודלים מדור GPT-4o-mini ו-GPT-5. הפער הבין-דורי ממוקד ספציפית בשפה פיגורטיבית ורב-משמעית, ולא בהבדל איכות גורף.
האם דור GPT חדש יותר פירושו תמיד תרגום טוב יותר?
לא. בבדיקה של ניב עברי על פני משפחות מודלים שונות, GPT-5.4-mini ו-GPT-5.4 הגיעו לשני פירושים שונים וחלקיים של אותו ביטוי, שאף אחד מהם אינו נכון לחלוטין, בעוד שמודל ישן יותר וללא קשר אליהם הגיע לתוצאה קרובה יותר. מודל חדש יותר אינו מדויק יותר באופן אוטומטי, ומודל גדול יותר או עדכני יותר אינו בהכרח הבחירה הבטוחה יותר עבור משפט נתון.
היכן עומד GPT-5 בתחום התרגום כיום
הן GPT-3 והן GPT-4 הוצאו משימוש ב-ChatGPT; GPT-4 נותר נגיש רק דרך ה-API של OpenAI עבור אינטגרציות קיימות. הדור הנוכחי, GPT-5.4 ו-GPT-5.5, הוא מה ש-MachineTranslation.com מפעיל כיום, והוא מציג ביצועים תחרותיים מול מודלים עדכניים של ספקים אחרים, אם כי לא טוב יותר באופן גורף בכל צמד שפות. למבט מעמיק יותר על האופן שבו גרסאות-המשנה הנוכחיות של GPT משתוות זו לזו ולמודלים כמו Claude ו-DeepSeek, עיינו בבדיקות ראש-בראש של גרסאות-המשנה של MachineTranslation.com, שצוללות עמוק יותר ממה שסקירה בין-דורית יכולה להציע.
מה המשמעות של זה אם אתם מבצעים לוקליזציה בהיקף נרחב
הממצא החשוב ביותר עבור תוכנית לוקליזציה גדולה אינו ש-"GPT-5 מנצח את GPT-3". הוא שגרסת המודל, ולא רק משפחת המודלים, קובעת האם ניב ספציפי או ביטוי רב-משמעי יתורגמו כראוי, והדבר נכון לגבי כל צמד שפות, לא רק לגבי קומץ השפות שמוצגות כאן. יש לכך חשיבות עליונה בתוכן שנשען מלכתחילה על טון ועל שפה פיגורטיבית, במיוחד טקסטים שיווקיים ותוכן גולשים, שבהם ניב בודד שמתורגם מילולית יכול לשנות לחלוטין את משמעות הפוסט או המודעה. תוכנית שמתרגמת תוכן לעשרות שפות תיתקל בדיוק בסוג כזה של שפה בכל אחת ואחת מהן. סדרת בדיקות גרסאות-המשנה ובדיקות השוואת המודלים המלאות של MachineTranslation.com מכסות זאת בהרחבה רבה יותר. הגישה של הפלטפורמה, המריצה מודלים נוכחיים של GPT לצד יותר מ-20 מודלים אחרים בכל תרגום, קיימת בדיוק משום שהיסטוריית הגרסאות של מודל יחיד אינה מהווה ערובה אמינה מספיק בפני עצמה.
שאלות נפוצות
1. מהו ההבדל האמיתי בין GPT-3, GPT-4 ו-GPT-5 בתרגום?
GPT-3 התמודד עם טקסט פשוט וברור בצורה סבירה, אך התקשה מאוד עם כל מה שהיה בעל אופי ניבי או רב-משמעי. GPT-4 צמצם פער זה באופן משמעותי, אך עדיין צמצם ביטויים מסוימים שהיו רב-משמעיים באמת למשמעות אחת במקום לשמר את אי-הבהירות. גרסאות-המשנה המאוחרות יותר של GPT-5 התמודדו כראוי עם ניבים שמודלים מוקדמים יותר מעידן GPT-4 תרגמו בצורה מילולית ושגויה.
2. האם GPT-5 תמיד טוב יותר מ-GPT-4 בתרגום?
לא. הבדיקות של MachineTranslation.com עצמה מצאו מקרים שבהם גרסת-משנה קטנה וחדשה יותר הציגה ביצועים טובים יותר מגרסה גדולה וישנה יותר, ופער האיכות בין הדורות נוטה להיות ספציפי לשפה ניבית או פיגורטיבית, ולא שיפור כללי וגורף.
3. האם OpenAI עדיין מציעה את GPT-3 או GPT-4?
לא. שתיהן הוצאו משימוש ב-ChatGPT והוחלפו במודלים חדשים יותר מדור ה-GPT-5. GPT-4 נותר נגיש רק דרך ה-API של OpenAI עבור אינטגרציות קיימות, ולא כאפשרות עדכנית הפונה לצרכנים.
4. באיזו גרסת GPT משתמש MachineTranslation.com?
MachineTranslation.com מריץ מודלים עדכניים מדור ה-GPT-5 (GPT-5.4 ו-GPT-5.5, בהתאם לרמת המנוי) לצד יותר מ-20 מודלי AI אחרים בכל תרגום, במקום להסתמך על GPT בלבד.
5. כיצד GPT-5 משתווה למודלי AI עדכניים אחרים בתרגום?
מודלים מדור GPT-5 מציגים ביצועים תחרותיים, אך אינם טובים יותר באופן אחיד ממודלים כמו Claude, Gemini או DeepSeek. מודלים שונים מובילים בצמדי שפות ובסוגי תוכן שונים, וזו הסיבה ש-MachineTranslation.com בודק אותם ישירות זה מול זה במקום לבחור באחד כברירת מחדל.