September 9, 2026
Qwen מול DeepSeek: איזה מודל AI מתרגם טוב יותר?
הרצת אותם 12,000 מקטעי תרגום ב-Qwen וב-DeepSeek, ו-DeepSeek מנצח במרבית צמדי השפות. זה לא כל הסיפור. פצלו את התוצאות לפי כיוון, ודפוס מסוים מתגלה: Qwen מצמצם את רוב הפער, ולפעמים מוביל, במיוחד כאשר שפת היעד היא אנגלית. בתרגום מאנגלית לכל שפה אחרת, DeepSeek מנצח כמעט בכל פעם.
החלוקה הזו משמעותית יותר מאשר מנצח כללי יחיד אם אתם מתרגמים תוכן על פני עשת שפות ולא רק צמד שפות אחד.
מהם Qwen ו-DeepSeek?
Qwen היא משפחת מודלי השפה הגדולים של Alibaba. הדור הנוכחי הוא Qwen3.8, ששוחרר באוגוסט 2026: Qwen3.8-Max הוא דגם הדגל הסגור, הזמין ב-API בלבד, עם 2.4 טריליון פרמטרים, בעוד ש-Qwen3.8-27B הוא מודל קטן יותר, בעל משקלים פתוחים, ששוחרר תחת Apache 2.0 כמה ימים לאחר מכן, ומיועד לצוותים שרוצים לארח את המודל בעצמם.
DeepSeek היא מעבדת AI סינית המוכרת בזכות מודלי mixture-of-experts המציגים ביצועי קצה בשבריר מעלות ההסקה. הדור הנוכחי שלה, DeepSeek V4, הושק באפריל 2026 בשתי גרסאות: V4 Pro (סך של 1.6 טריליון פרמטרים, כ-49 מיליארד פעילים לכל טוקן) לעבודה הממוקדת באיכות, ו-V4 Flash (סך של 284 מיליארד, כ-13 מיליארד פעילים) לעומסי עבודה הרגישים לשיהוי. שניהם מופצים כ- משקלים פתוחים ברישיון MIT.
כיצד Qwen ו-DeepSeek באמת משתווים בתרגום, ולא רק במבחני ביצועים?
מרבית ההשוואות בין Qwen ל-DeepSeek מצטטות מבחני ביצועים כלליים: תכנות, מתמטיקה והסקה. אף אחד מאלה אינו מודד את איכות התרגום באופן ישיר, והרצת כל מודל על טקסט מקור שונה הופכת את בידוד פער הדיוק מהדרישות של הטקסט עצמו לבלתי אפשרי.
תעבורת התרגום של MachineTranslation.com עצמו במהלך 28 הימים האחרונים מספקת תשובה ברורה יותר, מכיוון ששני המודלים תרגמו את אותו טקסט מקור בדיוק. ב-98 צמדי שפות ויותר מ-12,000 מקטעים תואמים, DeepSeek קיבל ציון גבוה יותר ב-83 צמדים; Qwen קיבל ציון גבוה יותר ב-15. צמצמו זאת ל-27 הצמדים שבהם שפת היעד היא אנגלית, והפער מצטמצם בחדות: DeepSeek מנצח ב-63% מהם (17 מתוך 27), Qwen מנצח ב-37% (10 מתוך 27). ב-71 הצמדים הנותרים, שבהם אנגלית אינה שפת היעד, DeepSeek מנצח ב-92% (66 מתוך 71).
שיעור ניצחונות לפי כיוון תרגום (98 צמדי שפות, טקסט זהה)
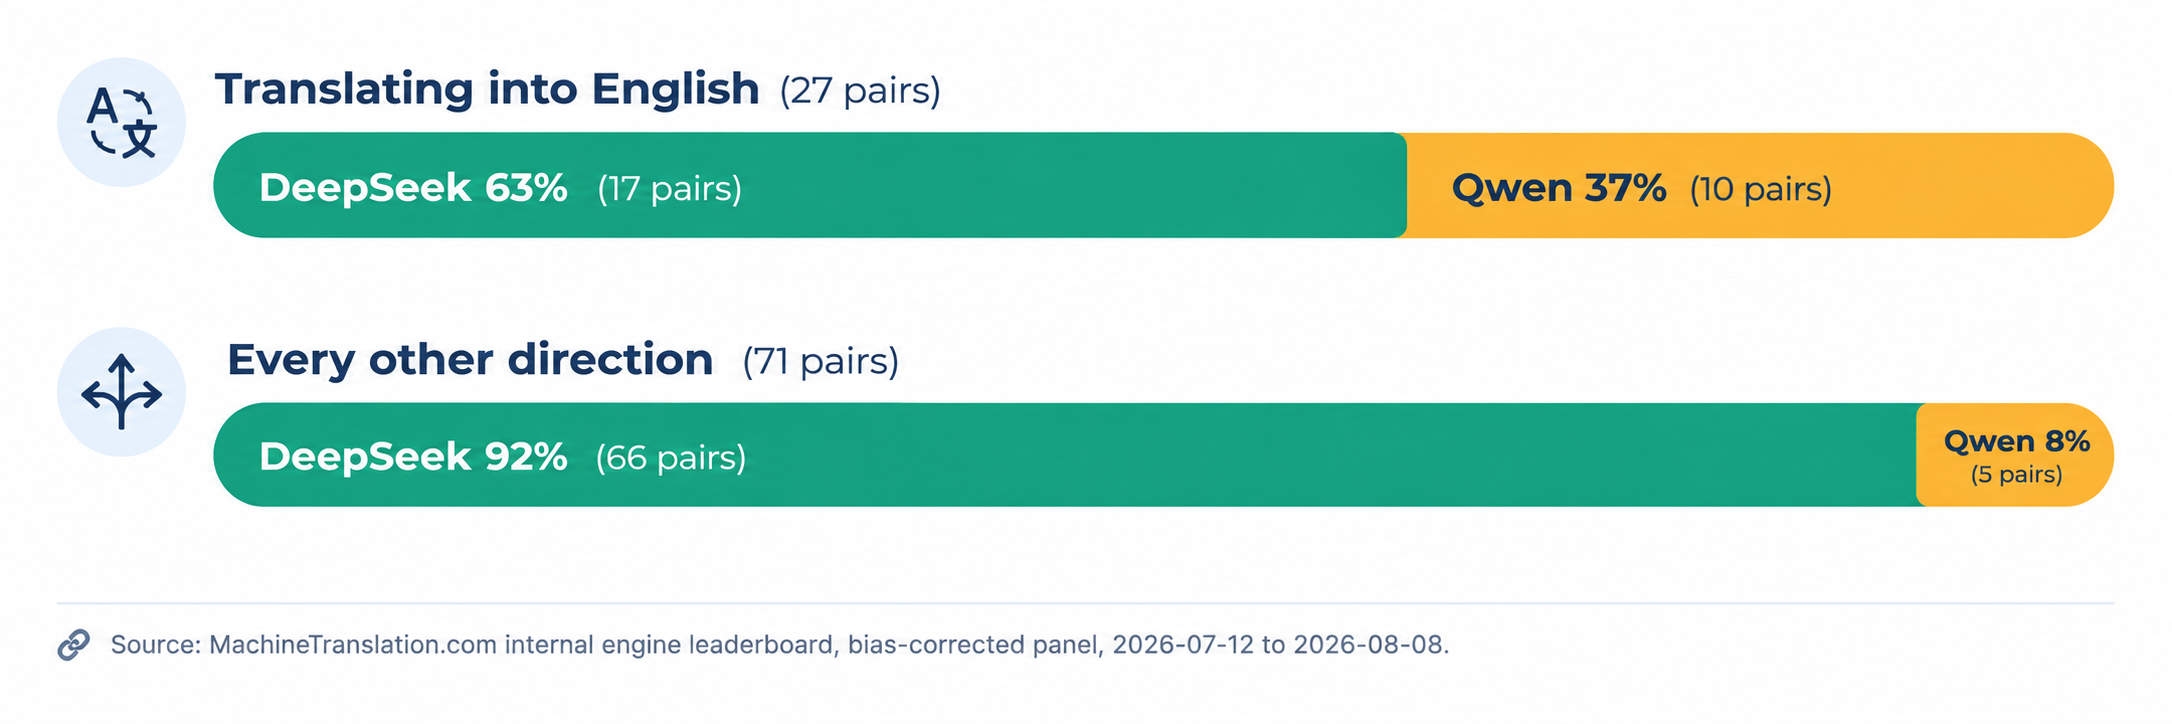
DeepSeek מנצח ברוב הגדול של צמדי השפות באופן כללי. חלון התחרותיות של Qwen הוא צר אך אמיתי: תרגום לאנגלית, שם הוא לוקח יותר משליש מהצמדים. נתונים: טבלת המובילים הפנימית של המנועים של MachineTranslation.com, פאנל מתוקן-הטיה, 12 ביולי עד 8 באוגוסט 2026.
הממוצע המשוקלל בכל מקטע תואם מעמיד את DeepSeek על 9.13 מתוך 10 ואת Qwen על 8.98. זהו פער אמיתי, אך הוא אינו מפוזר באופן שווה, וזהו המידע השימושי יותר אם התוכן שלכם נע ביותר מכיוון אחד. זוהי אותה גישת ראש בראש שבה MachineTranslation.com משתמש בכל בדיקות השוואת המודלים המלאות שלו, לא רק עבור הצמד הבודד הזה.
הנתונים המצטברים מחזיקים מעמד גם במקרי מבחן פרטניים. בבדיקת הביטוי בצרפתית "Elle est directrice adjointe du département commercial", DeepSeek ו-Qwen התכנסו לאותו תרגום לאנגלית, "deputy director of commercial department". ניתן לבדוק את תוצאת הבדיקה החיה הזו ישירות. בבדיקת "as soon as possible" בתרגום לספרדית, DeepSeek חרג מהקונצנזוס של ארבעת המודלים עם "esté hecho" במקום "se haga", שהוא מקרה של חריגה אמיתית המשקף הבחנה דקדוקית של תהליך לעומת תוצאה, ולא טעות.
מדוע Qwen מצליח יותר בתרגום לאנגלית באופן ספציפי?
הנתונים אינם מסבירים מדוע, אלא רק היכן. כמה מצמדי השפות החזקים ביותר של Qwen לאנגלית הם טמילית, סינית, פולנית, איטלקית ועברית, שהן שפות מקור עם קורפוסי אימון גדולים ומבוססים בשפה האנגלית הזמינים לבוני מודלים באופן כללי. מחוץ לכיוון האחד הזה, היתרון של DeepSeek נשמר כמעט בכל מקום: מאנגלית, וכמו כן בין צמדי שפות שאינן אנגלית.
מה שזה שולל הוא התייחסות למי מהמודלים כברירת מחדל אוניברסלית. צוות המתרגם רשימות מוצרים מספרדית לשש שפות ומצפה לאותו דירוג ביצועים שראה בתרגום פניית תמיכה מסינית לאנגלית, יחיל את הלקח הלא נכון מהכיוון הלא נכון, וזוהי אותה אסימטריה המופיעה בניתוח המודלים של ספרדית-לאנגלית ב- MachineTranslation.com, שבו המודלים המובילים אינם אותם מודלים המובילים בכיוון ההפוך.
האם Qwen ו-DeepSeek הם חינמיים ובקוד פתוח?
הרישוי מתפצל באופן שונה עבור כל אחד מהם. DeepSeek מעניקה רישיון הן עבור V4 Pro והן עבור V4 Flash תחת MIT, אחד מתנאי הקוד הפתוח המתירניים ביותר שישנם, כך ששניהם חופשיים לאירוח עצמי ללא הגבלה. Qwen מפוצל: Qwen3.8-27B מופץ תחת Apache 2.0 והוא חופשי לאירוח עצמי, אך מודל הדגל Qwen3.8-Max נשאר סגור, בגישת API בלבד, ותחת רישיון מותאם אישית של Alibaba.
בפועל, המשמעות היא שקיימת אפשרות של משקלים פתוחים (open-weight) ברישיון MIT בצד של DeepSeek בשתי רמות האיכות. בצד של Qwen, מעבר למשקלים פתוחים (open-weight) פירושו ויתור על מודל הדגל.
כמה עולה להריץ את Qwen ואת DeepSeek בקנה מידה רחב?
בעקבות הפחתת המחיר הקבועה של DeepSeek במאי 2026, תעריפי ה-API המפורסמים הנוכחיים שלה הם $0.435 per million input tokens (cache miss) and $0.87 למיליון טוקנים של פלט עבור V4 Pro, כאשר V4 Flash מתומחר נמוך יותר עבור שכבת הביצועים מותאמת השהיה שלו.
עבור צוותים המארחים עצמית את אחד המודלים במקום להשתמש ב-API מארח, השוואת העלויות עוברת לחלוטין לתשתית GPU והופכת לפונקציה של מספר הפרמטרים ויעילות הפרמטרים הפעילים (active-parameter efficiency), ולא לתעריף לכל טוקן.
האם אחד מהמודלים בטוח מספיק עבור תוכן משפטי, רפואי או מפוקח?
אף אחד מהמודלים אינו מפרסם אישורי בטיחות ספציפיים לתרגום, ומדדי בטיחות למטרות כלליות אינם בוחנים את מצבי הכשל החשובים בתוכן מפוקח: מינון שתורגם באופן שגוי, סעיף חבות שהשתנה, או מונח משפטי לא עקבי. הבדיקות של MachineTranslation.com עצמה מצאו בדיוק סוג כזה של סטייה בין מודלים בשפה משפטית ורפואית, כולל מקרים שבהם מודלים השתמשו ב- מונחים משפטיים שונים בעלי היקפים שונים למרות ששניהם קיבלו ציונים גבוהים במדדי איכות כלליים.
עבור חוזים, מסמכי הגירה או תוכן קליני, זהו הטיעון בעד שילוב הפלט של כל אחד מהמודלים עם שלב אימות אנושי במקום לבטוח בפלט AI בודד כפשוטו, ללא קשר למודל שהפיק אותו.
מה המשמעות של זה אם אתם מבצעים לוקליזציה לשפות רבות בבת אחת?
השוואה המבוססת על צמד שפות אחד אינה מספרת לכם כמעט דבר על צמד מספר ארבעים. הפיצול של "אל אנגלית / מאנגלית" המתועד כאן נשמר על פני מדגם של 98 צמדים דווקא מכיוון שהוא נבדק בקנה מידה כזה: בדיקה בודדת של אנגלית-לספרדית, שזה מה שרוב השוואות Qwen מול DeepSeek מריצות, הייתה מראה את DeepSeek מוביל בנוחות ולא אומרת דבר על מה שקורה ברגע שטמילית, פולנית או עברית נכנסות לתהליך.
זהו הטיעון המעשי נגד נעילת תוכנית לוקליזציה גדולה לפלט של מודל יחיד כברירת מחדל. MachineTranslation.com מריץ הן את Qwen והן את DeepSeek, לצד יותר מ-20 מודלים אחרים, בכל תרגום ומציג את הגרסה שעליה מודלים אלו מסכימים ביותר, כך שהשקה ב-68 שפות אינה תלויה במודל שבמקרה ניצח בצמד היחיד שמישהו בדק ראשון. באפשרותכם לראות בדיוק אילו מודלים הסכימו או נחלקו בכל תרגום נתון ב- פירוט המודלים לפי תרגום שהפלטפורמה מציגה עבור כל תוצאה.
כל תרגום נבדק מול מגוון רחב יותר של מודלים ממה ש-Qwen או DeepSeek לבדם יכולים להציע, וזו התשובה הישירה למה שקורה ברגע שהתוכן שלכם מפסיק לנוע בכיוון אחד בלבד.
שאלות נפוצות
1. האם Qwen או DeepSeek טובים יותר לתרגום?
על פני 98 צמדי שפות שנבדקו על טקסט מקור זהה, DeepSeek קיבל ציון גבוה יותר ב-83 מהם. הניצחונות של Qwen מתרכזים בכיוון ספציפי אחד: תרגום לאנגלית, שם הוא מנצח בכשליש מהמקרים. בכל כיוון אחר, DeepSeek מנצח ביותר מ-90% מהמקרים.
2. האם Qwen הוא חופשי לשימוש?
Qwen3.8-27B הוא בעל משקלים פתוחים (open-weight) תחת רישיון Apache 2.0 וחופשי לאירוח עצמי. מודל הדגל Qwen3.8-Max הוא סגור וזמין רק דרך ה-API בתשלום של Alibaba Cloud.
3. האם DeepSeek חופשי לשימוש?
כן. הן DeepSeek V4 Pro והן V4 Flash מופצים עם MIT-licensed open weights, כך שתוכל לבצע self-host לכל אחד מהם ללא עלות רישוי. DeepSeek מציע גם API בתשלום עבור צוותים שאינם מעוניינים לנהל תשתית משלהם.
4. מי מהיר יותר, Qwen או DeepSeek?
DeepSeek V4 Flash נבנה במיוחד עבור שיהוי נמוך, עם 13 מיליארד פרמטרים פעילים לכל טוקן לעומת 49 מיליארד של V4 Pro. האפשרות הקלה המקבילה של Qwen, Qwen3.8-27B, היא dense ולא mixture-of-experts, מה שבאופן כללי הופך אותה לאיטית יותר לכל token באיכות דומה.
5. האם ניתן להשתמש ב-Qwen וב-DeepSeek יחד לתרגום?
כן. MachineTranslation.com מריץ את שני המודלים, ועוד למעלה מ-20 אחרים, בכל תרגום ומציף את הגרסה שעליה הם מסכימים הכי הרבה, כך שאינכם תקועים בבחירת מודל אחד ובתקווה שהוא הבחירה החזקה יותר עבור צמד השפות הספציפי הזה.
6. מה ההבדל בין הרישוי של Qwen לזה של DeepSeek?
DeepSeek מעניקה רישיון לשתי גרסאות ה-V4 תחת MIT, אחד מרישיונות הקוד הפתוח המתירניים ביותר הזמינים. Qwen מפצלת את ההיצע שלה: דגמים קטנים יותר כמו Qwen3.8-27B מופצים תחת Apache 2.0, אך דגם הדגל Qwen3.8-Max נשאר סגור תחת רישיון מותאם אישית.