November 13, 2026
Qwen לעומת Gemini לתרגום ולמה לכיוון יש חשיבות
יש לכם שני מודלים ורשימה של צמדי שפות, ואתם צריכים להחליט על איזה מודל לסמוך עבור הפרויקט. רוב ההשוואות בין Qwen ובין Gemini מספקות ציון כולל אחד. לדעתי ציון אחד מסתיר את מה שקובע את התוצאה, שהוא כיוון התרגום.
אני עובד על האופן שבו אנו בודקים את המודלים שפועלים באתר MachineTranslation.com, כך שאני יכול להשוות בין Qwen ובין Gemini בקרב 98 צמדי שפות שקיבלו ציון על גבי טקסט זהה. Gemini קיבל ציון גבוה יותר בקרב 68 מהצמדים הללו ואילו Qwen בקרב 29, והפער הממוצע הוא 0.08 נקודות מתוך 10. הנתונים הכוללים לבדם אינם אומרים באיזה מודל לבחור עבור אורדו לאנגלית או עבור אנגלית לקריאולית האיטית.
מאמר זה מציג היכן שני המודלים קרובים והיכן כל אחד מהם מוביל. הוא גם מציין מה שאיני יכול עדיין לומר לכם. הנתונים שלי מסתיימים בתאריך August 8, 2026, לפני שחברת Google הכריזה על Gemini 4 באוקטובר, כך שהם מתארים את הגרסאות המוקדמות יותר של שני המודלים.
תובנות מרכזיות
- בקרב 98 צמדי שפות שקיבלו ציון על גבי טקסט זהה (July 12 to August 8, 2026), Gemini קיבל ציון גבוה יותר בקרב 68 צמדים, Qwen בקרב 29, ובצמד אחד נרשם שוויון.
- הפער הממוצע קטן, 9.06 עבור Gemini לעומת 8.98 עבור Qwen, וכן 60 מתוך 98 הצמדים נמצאים בטווח של 0.1 נקודות.
- בתרגום לאנגלית, Qwen מוביל בפער של מעל 0.1 נקודות בקרב 7 מתוך 27 צמדים ואילו Gemini בקרב 3; 17 הנותרים נמצאים בטווח של 0.1 נקודות.
- בתרגום מאנגלית, Gemini מוביל בפער של מעל 0.1 נקודות בקרב 13 מתוך 29 צמדים, ואילו Qwen באף אחד מהם.
- הנתונים מסתיימים לפני שחברת Google הכריזה על Gemini 4 בחודש October 2026, כך שהם מתארים את גרסאות Gemini המוקדמות יותר ודורשים הרצה מחודשת לפני שמישהו יתייחס אליהם כעדכניים.
האם Qwen או Gemini טוב יותר לתרגום?
הדבר תלוי בכיוון, מכיוון ששני המודלים קרובים כאשר שפת היעד היא אנגלית, וכן Gemini מקבל ציון גבוה יותר ברוב הצמדים האחרים. בכל 98 הצמדים, Gemini קיבל ציון גבוה יותר בקרב 68. בציונים של MachineTranslation.com מתאריך July 12 to August 8, 2026, הממוצע של Gemini היה 9.06 מתוך 10 ושל Qwen היה 8.98, פער ממוצע של 0.08 נקודות.
הפאנל כולל רק מקטעים שבהם ChatGPT, Claude, DeepSeek, Gemini וכן Qwen קיבלו כולם ציון אמיתי, כך שכל מודל נשפט על גבי טקסט מקור זהה. בכל צמד שפות יש לפחות 30 מקטעים. אני משתמש בפאנל הזה מכיוון שהוא מסיר שגיאה נפוצה, שהיא השוואת מודלים על גבי טקסט שונה.
לפי ספירה, Gemini מוביל בקרב 68 צמדים (69%), Qwen בקרב 29 (30%), ובצמד אחד יש שוויון. ספירה לבדה מציגה את הפער בהגזמה, מכיוון ש 60 מתוך 98 הצמדים נמצאים בטווח של 0.1 נקודות. הסעיפים הבאים מחלקים את התוצאות לפי כיוון ולפי מרווח.
אילו כיווני תרגום מעניקים יתרון לכל מודל?
Gemini מוביל כאשר אנגלית היא שפת המקור או כאשר אף אחת מהשפות אינה אנגלית, ואילו Qwen משתווה אליו או מוביל כאשר אנגלית היא שפת היעד. בתרגום מאנגלית, Gemini מוביל בפער של מעל 0.1 נקודות בקרב 13 מתוך 29 צמדים, ואילו Qwen באף אחד מהם. בתרגום לאנגלית, Qwen מוביל במרווח כזה בקרב 7 מתוך 27 צמדים ואילו Gemini בקרב 3.
| כיוון | צמדים | Gemini מוביל ביותר מ-0.1 | בטווח של 0.1 נקודות | Qwen מוביל ביותר מ-0.1 | פער ממוצע |
|---|---|---|---|---|---|
| לאנגלית | 27 | 3 | 17 | 7 | Qwen +0.04 |
| מאנגלית | 29 | 13 | 16 | 0 | Gemini +0.16 |
| אף צד אינו אנגלית | 42 | 14 | 27 | 1 | Gemini +0.13 |
לאנגלית, 17 מתוך 27 צמדים נמצאים בטווח של 0.1 נקודות, Qwen מוביל ב-7 ו-Gemini מוביל ב-3. מאנגלית, 16 מתוך 29 צמדים נמצאים בטווח של 0.1 נקודות, Gemini מוביל ב-13 ו-Qwen אינו מוביל באף אחד. כאשר אף אחת מהשפות אינה אנגלית, 27 מתוך 42 נמצאים בטווח של 0.1 נקודות, Gemini מוביל ב-14 ו-Qwen מוביל ב-1.
Qwen נמצא בטווח של 0.1 נקודות מ-Gemini או מוביל ב-24 מתוך 27 הצמדים לאנגלית. בממוצע לפי כיוון, Qwen מוביל בכ-0.04 נקודות לאנגלית, בעוד ש-Gemini מוביל בכ-0.16 נקודות מאנגלית וב-0.13 נקודות בין שתי שפות שאינן אנגלית.
אינני יודע מדוע הפיצול מופיע, והנתונים הללו אינם יכולים לומר לי זאת. הסבר אחד שהייתי בודק תחילה הוא תמהיל טקסט האימון שמאחורי כל מודל, אך לא הרצתי בדיקה זו. Qwen מציג דפוס דומה מול ChatGPT. באותו פאנל, ההשוואה שלנו בין Qwen לבין ChatGPT מצאה ששני המודלים קרובים לשוויון לאנגלית, כאשר ChatGPT מוביל ב-89% משאר הצמדים.
אילו צמדי שפות מציגים את הפערים הגדולים ביותר?
הפערים הגדולים ביותר נוטים לטובת Gemini. הוא מוביל ב-0.51 עד 0.95 נקודות ברוסית לקזחית, אנגלית לקריאולית האיטית, אנגלית לטגלוג, ספרדית ליוונית וערבית לפרסית. ההובלות הגדולות ביותר של Qwen קטנות יותר, בין 0.15 ל-0.26 נקודות, וארבע מתוך חמש המובילות שלו הן של צמדים לאנגלית.
| צמד שפות | ציון Gemini | ציון Qwen | פער |
|---|---|---|---|
| רוסית לקזחית | 9.27 | 8.32 | Gemini +0.95 |
| אנגלית לקריאולית האיטית | 9.19 | 8.27 | Gemini +0.92 |
| אנגלית לטגלוג | 9.14 | 8.43 | Gemini +0.70 |
| ספרדית ליוונית | 8.90 | 8.33 | Gemini +0.57 |
| ערבית לפרסית | 8.84 | 8.34 | Gemini +0.51 |
| אורדו לאנגלית | 8.56 | 8.81 | Qwen +0.26 |
| סינית לאנגלית | 9.00 | 9.19 | Qwen +0.19 |
| שוודית לאנגלית | 8.29 | 8.46 | Qwen +0.16 |
| סינית לאינדונזית | 9.03 | 9.19 | Qwen +0.16 |
| בורמזית לאנגלית | 8.94 | 9.09 | Qwen +0.15 |
לא הייתי מתייחס לאלה כדירוגים סופיים. שני הפערים הגדולים ביותר, רוסית לקזחית ואנגלית לקריאולית האיטית, מתבססים על מדגמים קטנים יותר מצמד השפות החציוני. אנגלית לטגלוג, ספרדית ליוונית וערבית לפרסית מתבססים על מדגמים גדולים יותר, ולכן הייתי סומך יותר על שלושת אלה. הייתי בודק מחדש את שני הפערים בעלי המדגם המצומצם לפני שהייתי מסתמך עליהם.
מה המשמעות של פער של 0.1 נקודות?
לדעתי, פער של פחות מ-0.1 נקודות הוא קטן מדי מכדי להכריז על מנצח. מתוך 98 הצמדים, 60 נופלים בתוך הטווח הזה, וכל צמד מדורג על סמך מספר מוגבל של מקטעים. קו ה-0.1 הוא סף העבודה האישי שלי, ולא ביצעתי מבחן מובהקות על הצמדים הללו.
ציון גם מפספס הבדלים מסוימים. במבחני הביטויים הנפוצים שלנו, הרצנו את "sorry" בערבית דרך 22 מודלי AI. גם Gemini וגם Qwen בחרו ב-آסف היומיומית. ChatGPT והתוצאה המשולבת בחרו ב-عذرًا הרשמית. כל מודל קיבל ציון של 9.5, כך ששתי המילים נבדלות במשלב והציון לא השתנה.
זו הסיבה שאני בוחן את הפער ואת דוגמאות המשלב יחד. פער קטן עם הבדל משלב ניכר מצריך החלטה אנושית. פער גדול במדגם מצומצם מצריך בדיקה חוזרת.
האם Qwen ו-Gemini עושים סוגים שונים של טעויות?
כן, מכיוון שבמבחן ציטוטי מונדיאל 2026 שלנו שני המודלים עשו לפחות בחירה אחת שהמודלים האחרים לא עשו, והציונים כמעט לא השתנו. Gemini תרגם ביטוי של Mbappé כ-"with each game" ותרגם ציטוט של Wirtz מילה במילה, בעוד ש-Qwen העניק קריאה שונה לציטוט של Scaloni. הציונים במקרים אלה נעו בין 9.2 ל-9.5.
הפרטים מגיעים ממבחן ציטוטי המונדיאל שלנו. בציטוט של Mbappé על מבט קדימה, המודלים האחרים שמרו על "match" בעוד ש-Gemini כתב "with each game", חריגה קלה במשלב שקיבלה ציון של 9.4. בציטוט של Wirtz, מודל Gemini תרגם ביטוי מילה במילה ושינה את המשמעות, גם כן בציון 9.4. בציטוט של Scaloni, רוב המודלים התכנסו לקריאה אחת בעוד ש-Qwen כתב "that is what matters" וקיבל ציון של 9.4. בציטוט הטקטי של Mbappé, מודלי Claude ו-DeepSeek בחרו באנגלית בריטית של עולם הכדורגל בעוד ש-Gemini, Qwen והאחרים בחרו באנגלית אמריקאית, ו-Qwen קיבל ציון של 9.2, נמוך יותר מהשאר.
אני מפרש זאת כהרגלים קטנים. הדוגמאות של Gemini נוגעות למשלב ולניסוח מילולי. הדוגמאות של Qwen נוגעות לשאלה באיזו קריאה של השורה לבחור. ארבע דוגמאות הן מעט מדי מכדי להגדיר דפוס, אך הן מראות את סוג ההבדל שציון בודד מסתיר.
איזה מודל של Qwen הוא הטוב ביותר לתרגום?
אינני יכול לקבוע זאת על סמך הנתונים שלנו, מכיוון שהציונים של MachineTranslation.com מתייחסים ל-Qwen כאל מודל יחיד ללא תגית גרסה. מבית Alibaba, משפחת Qwen3.8 הגיעה ל-Hugging Face באוגוסט 2026, כך שכעת קיימות מספר גרסאות, והציונים במאמר זה אינם מפרידים ביניהן.
הייתי רוצה לפצל זאת לפי גרסה, אך עדיין אינני יכול. ייתכן שהמספר ברמת הפלטפורמה משקלל ממוצע של יותר מגרסת Qwen אחת שפעלה בחלון הזמן הזה. אם אתם בוחרים בין גרסאות Qwen עבור פרויקט, הייתי משווה ביניהן על מדגם של טקסט משלכם.
מהן כמה מהחלופות ל-Gemini עבור תרגום?
ChatGPT, Claude, DeepSeek, Qwen, Grok ו-Mistral AI פועלים כולם ב-MachineTranslation.com, והחלופה המתאימה תלויה בצמד השפות. בציונים שלנו מה-12 ביולי עד ל-8 באוגוסט 2026, Qwen נמצא בטווח של 0.1 נקודות מ-Gemini או מוביל עליו ב-24 מתוך 27 צמדים לאנגלית. ציוני Mistral AI בצרפתית מראים שהממוצע שלו מצרפתית לאנגלית עומד על 0.40 נקודות מעל זה של Gemini.
אם החלופה שלכם היא ChatGPT, התשובה מתפצלת גם כן לפי צמד. בפילוח שפרסמנו מספרדית לאנגלית, Gemini ניצח ב-31% מהמקטעים ו-ChatGPT ניצח ב-21%. בצרפתית, אף אחד מהמודלים אינו מנצח בשני הכיוונים. מכיוון שהבחירה משתנה בהתאם לצמד, MachineTranslation.com אינו בוחר חלופה אחת. הוא מריץ אותם יחד.
ההצעה שלי היא להתחיל מהצמד ומהכיוון, ולאחר מכן לבדוק איזו חלופה מתאימה.
כיצד MachineTranslation.com מציג היכן Qwen ו-Gemini אינם מסכימים?
MachineTranslation.com מריץ את שני המודלים בכל תרגום ומראה היכן המודלים מסכימים והיכן הם נחלקים. לוח ההסכמה מדווח על מספר מודלי ה-AI שעבדו על הטקסט, שיעור ההסכמה, כמה מונחים היו שנויים במחלוקת ובאיזו מהירות הושג קונצנזוס.
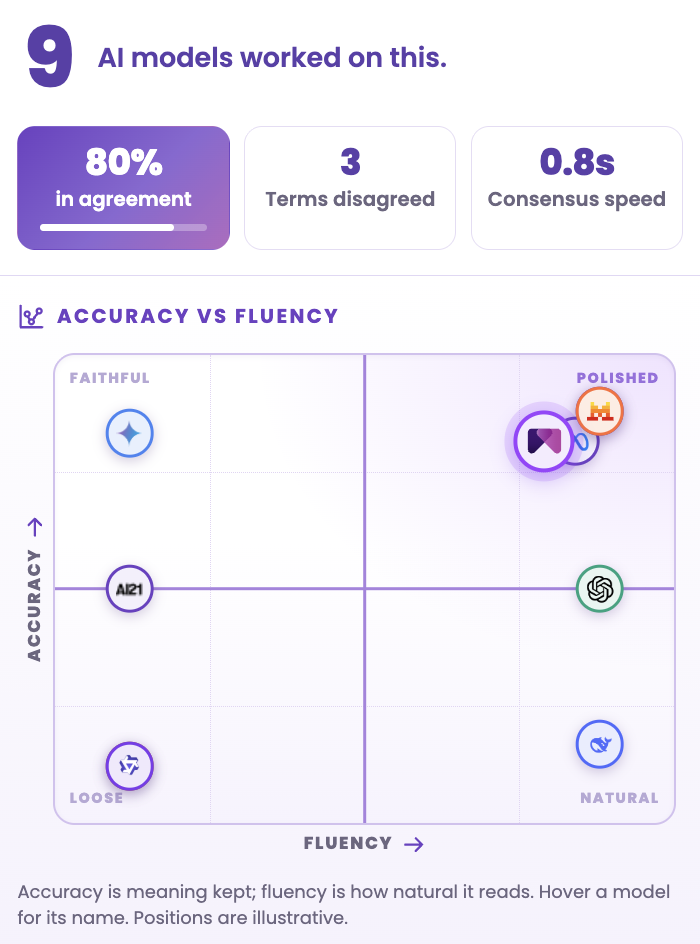
עד כמה התוצאות האלה עדכניות?
תוצאות אלו מכסות את התקופה שבין 12 ביולי ל-8 באוגוסט 2026, כך שהן מתארות את גרסאות Gemini ו-Qwen שפעלו אז. Google הכריזה על Gemini 4 באוקטובר 2026. משפחת Qwen3.8 של Alibaba הגיעה באוגוסט 2026. ההמלצה שלי היא להריץ מחדש את הפאנל לפני שמסתמכים על מספרים אלה עבור פרויקט חדש.
אני מצפה שהשיטה של השוואת טקסט זהה עם מרווח לרעש תישאר תקפה. אני מצפה שגודל הפערים ישתנה. הייתי מתייחס לכל צמד שבו המוביל מתחלף בהרצה חדשה כסימן לכך שהפער הקודם היה בטווח הרעש.
כיצד הייתי בוחר בין Qwen ל-Gemini עבור פרויקט?
הגישה שלי היא לבחור לפי צמד וכיוון, ולהימנע מבחירה פעם אחת בלבד עבור פרויקט שלם. בפועל המשמעות היא להתייחס לפער של פחות מ-0.1 נקודות כשוויון ולצפות שהמודל המוביל ישתנה בין צמדים. זהו הסדר שבו הייתי פועל.
- רשמו כל צמד שפות בפרויקט וסמנו את הכיוון שלו.
- בדקו את הפער עבור כל צמד במאמר זה. התייחסו לפער של פחות מ-0.1 נקודות כאל שוויון.
- במקרים שבהם הפער גדול יותר, התחילו עם המודל המוביל ובדקו מדגם מהטקסט שלכם.
- אם התוכן שלכם נע בשני הכיוונים, צפו לכך שהמוביל ישתנה בין צמדים.
- בדקו שוב כאשר אחד המודלים מוציא גרסה חדשה.
שני המודלים פועלים לצד 20 מודלים נוספים בכל תרגום ב-MachineTranslation.com. הגרסה שרובם מסכימים עליה היא זו שמוחזרת, כך שאין צורך לבצע את הבחירה פעם אחת עבור הפרויקט כולו. מערך התוצאות המלא של המודלים נמצא בבדיקות השוואת המודלים שלנו.
שאלות נפוצות
1. האם Qwen או Gemini טוב יותר לתרגום?
זה תלוי בכיוון, מכיוון ש-Qwen נמצא בטווח של 0.1 נקודות מ-Gemini או מוביל ב-24 מתוך 27 צמדים לאנגלית. Gemini עדיין קיבל ציון גבוה יותר ב-68 מתוך 98 צמדים בציונים של MachineTranslation.com בין 12 ביולי ל-8 באוגוסט, 2026. הפער הממוצע הוא 0.08 נקודות מתוך 10, ולכן הייתי בוחר לפי צמד.
2. איזה מודל Qwen הוא הטוב ביותר לתרגום?
איני יכול לומר זאת מתוך הנתונים שלנו, מכיוון שהציונים של MachineTranslation.com מתייחסים ל-Qwen כאל מודל יחיד ללא תגית גרסה. משפחת Qwen3.8 של Alibaba הגיעה ל-Hugging Face באוגוסט 2026, כך שכעת קיימות מספר גרסאות. עד שהציונים יפרידו ביניהן, הייתי משווה בין גרסאות על מדגם מהטקסט שלכם לפני בחירת גרסה לפרויקט.
3. מהן כמה חלופות ל-Gemini עבור תרגום?
ChatGPT, Claude, DeepSeek, Qwen, Grok ו-Mistral AI פועלים כולם ב-MachineTranslation.com. בציונים שלנו בין 12 ביולי ל-8 באוגוסט, 2026, Qwen נמצא בטווח של 0.1 נקודות מ-Gemini או מוביל ב-24 מתוך 27 צמדים לאנגלית. הממוצע של Mistral AI מצרפתית לאנגלית עמד על 0.40 נקודות מעל זה של Gemini. החלופה הנכונה תלויה בצמד.
4. האם Gemini טוב יותר מ-ChatGPT לתרגום?
זה תלוי בצמד השפות, מכיוון שאף מודל AI יחיד אינו מנצח בכל מקום. בפירוט שפרסמנו מספרדית לאנגלית, Gemini ניצח ב-31% מהמקטעים ו-ChatGPT ניצח ב-21%. בצרפתית, אף אחד מהמודלים אינו מנצח בשני הכיוונים. הייתי בודק את הצמד ואת הכיוון הדרושים לכם לפני הבחירה ביניהם.
5. האם Gemini מדויק לתרגום?
כן, מכיוון ש-Gemini הגיע לממוצע של 9.06 מתוך 10 ב-98 צמדי שפות בציוני July 12 to August 8, 2026 של MachineTranslation.com. הדיוק עדיין משתנה לפי צמד. היתרון שלו הוא הרחב ביותר מאנגלית, ו-Qwen מוביל עליו ביותר מ-0.1 נקודות ב-7 מתוך 27 צמדים לאנגלית.