October 2, 2026
Qwen מול Grok: איזה מודל AI מתרגם טוב יותר?
Qwen ו-Grok הם שניהם מודלי AI לשימוש כללי, לא כלים ייעודיים לתרגום, ושניהם חלק ממאגר המודלים ש-MachineTranslation.com מריץ על כל תרגום. יש לכך חשיבות באופן שבו יש לקרוא את ההמשך. זוהי הצצה לביצועים של שניים מהמודלים של הפלטפורמה עצמה אחד מול השני, עם ההסתייגויות האמיתיות שמגיעות עם סוג כזה של נתונים, ולא תחרות בין שני מתמודדים חיצוניים לפלטפורמה עצמה.
מה הם Qwen ו-Grok?
Qwen היא משפחת מודלי השפה הגדולים של Alibaba, כיום בדור Qwen3.8 שלה, והיא נוספה למאגר המודלים של MachineTranslation.com כחלק מההתרחבות המתמשכת של הפלטפורמה. Grok היא סדרת המודלים של xAI, כיום בגרסת Grok 4.7 נכון לכתיבת שורות אלו, לאחר שעברה מספר שחרורים מאז הגרסה שהמאמר הזה השווה במקור, והצטרפה לפלטפורמה בנפרד. אף אחד מהמודלים לא נבנה במיוחד עבור תרגום. שניהם מערכות לשימוש כללי שבמקרה מטפלות בשפות רבות כחלק מיכולת שפתית רחבה יותר, שזוהי נקודת פתיחה שונה מזו של פלטפורמה שנבנתה ונבדקה סביב איכות תרגום באופן ספציפי.
איך Qwen ו-Grok בהשוואה זה לזה על סמך הנתונים של MachineTranslation.com עצמה?
במהלך 28 הימים האחרונים של תעבורת הפלטפורמה, Grok קיבל ציון ממוצע גבוה יותר מ-Qwen: 9.26 מתוך 10 לעומת 8.87. ה-10% מהתרגומים עם הציון הגרוע ביותר של Grok עדיין עמדו על ממוצע של 9.2, בעוד שה-10% הגרועים ביותר של Qwen צנחו ל-7.6, פער רחב יותר בקצה התחתון ממה שהממוצע לבדו מרמז.
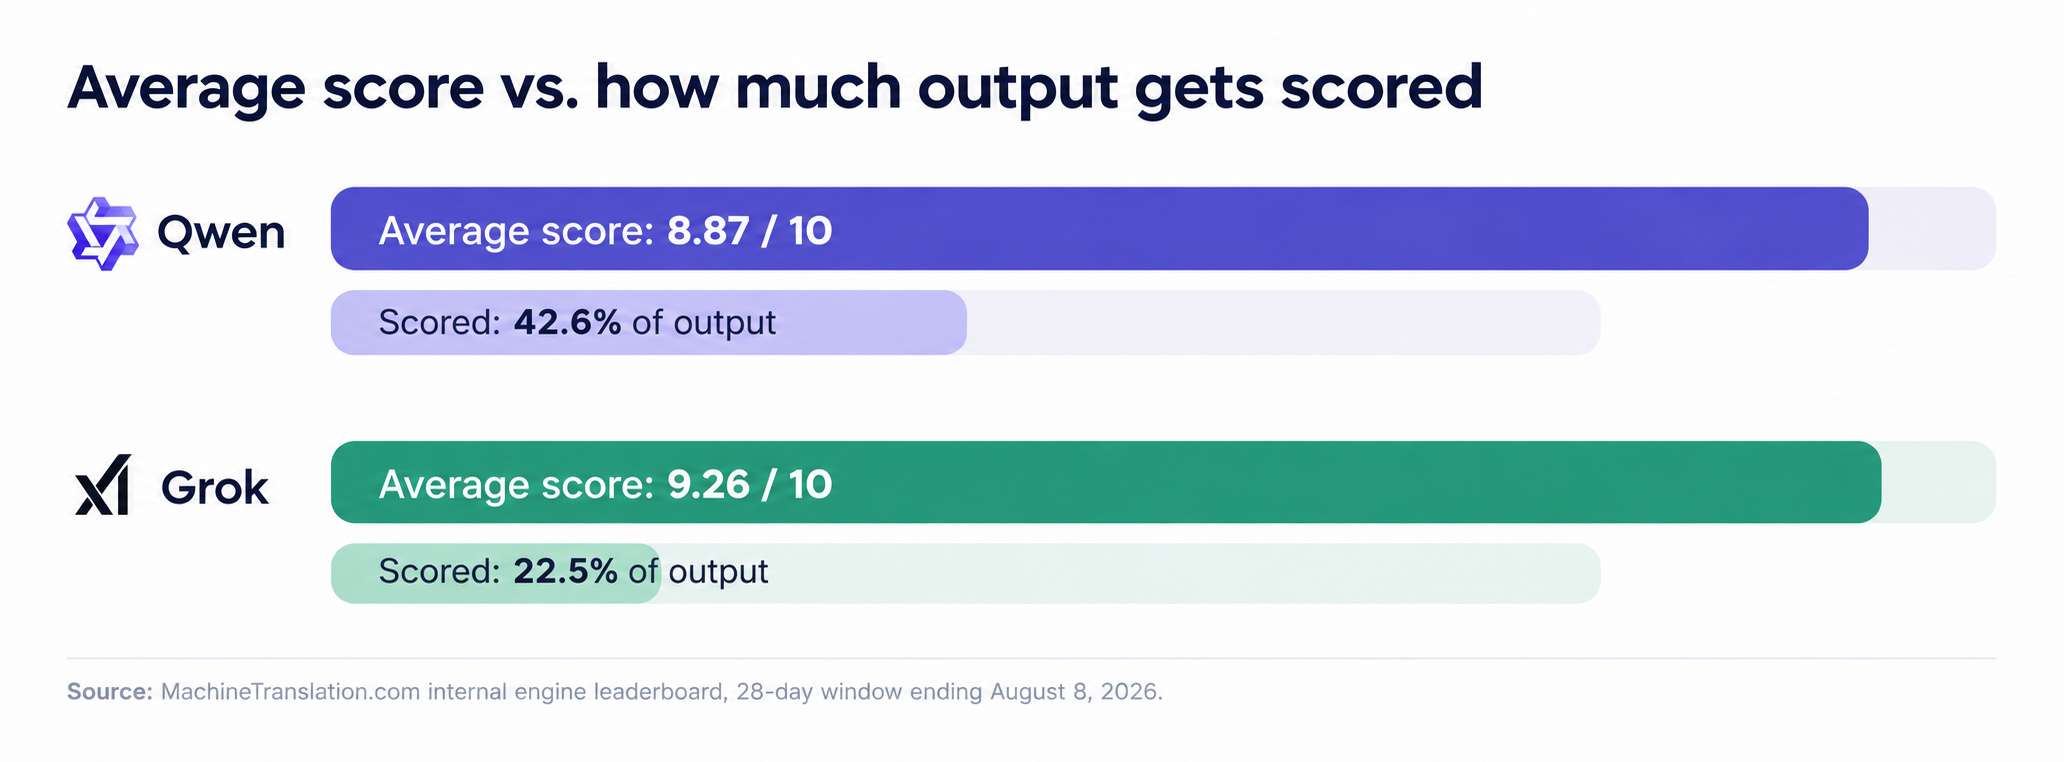
הציון הממוצע של Grok גבוה יותר, אך הוא מסתמך על מתן ציונים לפחות מרבע מהפלט שלו, לעומת כמעט מחצית עבור Qwen. שתי העמודות מספרות חלקים שונים של אותו סיפור.
| Qwen | Grok | |
|---|---|---|
| אחוז הפלט שקיבל ציון | 42.6% | 22.5% |
| ציון ממוצע | 8.87 / 10 | 9.26 / 10 |
| ה-10% התחתונים של הציונים | 7.6 | 9.2 |
מקור: טבלת המובילים הפנימית של המנועים ב-MachineTranslation.com, חלון של 28 ימים המסתיים ב-8 באוגוסט, 2026.
האם הציון הגבוה יותר של Grok אומר שהוא הבחירה הטובה יותר?
לא בפני עצמו. השימוש ב-Grok בפלטפורמה נפוץ הרבה פחות מאשר ב-Qwen, ופחות מרבע מהתרגומים שלו מקבלים ציון כלשהו, לעומת כמעט חצי מאלה של Qwen. מדגם קטן ופחות מייצג יכול לגרום לממוצע להיראות טוב או רע יותר ממה שהיה מתקבל על פני אותו נפח ש-Qwen רואה. הדיווח של MachineTranslation.com עצמה על הנתונים הללו מתייחס להיקף הציונים כמגבלה אמיתית, ולא כהערת שוליים: מנוע שקיבל ציונים על פלח צר מהתעבורה שלו לא נבדק ביסודיות כמו מנוע שקיבל ציונים על פני כמעט מחצית מהפלט שלו.
הפרשנות הכנה היא שהנתונים של Grok מבטיחים אך דלים יותר. הנתונים של Qwen נמוכים יותר בממוצע אך נשענים על בסיס רחב ומייצג הרבה יותר. אף אחת מהעובדות הללו לא מבטלת את השנייה.
מה לגבי כיסוי שפות?
לא Qwen ולא Grok מפרסמים רשימה מאומתת של צמדי שפות שבהם הביצועים יורדים, ולא קיימת בדיקה בלתי תלויה שתאשר זאת. מה שניתן לומר בביטחון הוא שאף אחד מהמודלים לא נבנה סביב איכות תרגום על פני קבוצת שפות ספציפית בדרך שבה פלטפורמת תרגום ייעודית בנויה. MachineTranslation.com בודקת ותומכת ביותר מ-270 שפות באופן ישיר, שזו טענה מסוג שונה מאשר היכולת הרב-לשונית הרחבה אך הלא-בדוקה של מודל למטרות כלליות.
כיצד MachineTranslation.com משתמשת בפועל ב-Qwen וב-Grok
MachineTranslation.com מריצה את Qwen, Grok, ויותר מ-20 מודלי AI אחרים על כל תרגום, ואז מציגה את הגרסה שהמודלים הללו מסכימים עליה ביותר. אף אחד מהמודלים לא נשלל בגלל שקיבל ציון ממוצע נמוך יותר. הרצת מודלים רבים בו-זמנית פירושה לתפוס את המקרים שבהם מודל עם ציון נמוך יותר בממוצע עדיין מתרגם נכון משפט ספציפי שמודל עם ציון גבוה יותר מפספס. הביצועים של Qwen מתפצלים גם לפי כיוון וצמד שפות בדרכים ששווה להכיר לפני שבוחרים מודל יחיד, נושא המכוסה לעומק רב יותר בהשוואה של MachineTranslation.com בין Qwen ל-DeepSeek. למבט קרוב יותר על האופן שבו מודלים נבדקים זה מול זה ישירות, ראו את בדיקת השוואת המודלים המלאה של MachineTranslation.com.
שאלות נפוצות
1. האם Qwen או Grok טובים יותר לתרגום?
על פי נתוני המנוע של MachineTranslation.com עצמה ל-28 ימים, Grok מקבל ציון ממוצע גבוה יותר מ-Qwen, עם 9.26 לעומת 8.87 מתוך 10. אולם, הציון של Grok מבוסס על נתח הרבה יותר קטן ופחות מייצג של הפלט שלו, ולכן לא מדובר בהשוואת ראש בראש נקייה כפי שהייתה בבדיקת מקטעים תואמים.
2. מדוע ל-Grok יש ציון ממוצע גבוה יותר אך פחות תרגומים שדורגו?
נעשה שימוש פחות תדיר ב-Grok בפלטפורמה ורק כ-22.5% מהפלט שלו מקבל ציון, לעומת 42.6% עבור Qwen. מדגם קטן ופחות מייצג יכול לנפח או להקטין ממוצע, וזו הסיבה שיש לקרוא את ההשוואה הזו כמצביעה על כיוון, ולא כמוחלטת.
3. האם Qwen או Grok תומך ביותר שפות?
שניהם מודלי AI לשימוש כללי ללא רשימה מפורסמת ומאומתת של מגבלות ספציפיות לשפה. אף אחד מהם לא נבנה במיוחד עבור תרגום, שזה שונה מפלטפורמה שבודקת ומדרגת את איכות התרגום על פני יותר מ-270 שפות באופן ישיר, במקום להסתמך על אימון רב-לשוני רחב כתחליף לביצועי תרגום מדודים.
4. האם MachineTranslation.com מתחרה ב-Qwen וב-Grok?
לא. MachineTranslation.com מריצה את Qwen, את Grok, ויותר מ-20 מודלי AI אחרים על כל תרגום ומציגה את הגרסה שהמודלים האלה מסכימים עליה ביותר. היא בודקת ומשלבת מודלים כאלה במקום להתחרות בהם כמודל נפרד משלה.
5. על איזה מודל AI ממליצה MachineTranslation.com לתרגום?
על אף אחד כברירת מחדל. מודלים שונים מתפקדים בצורה שונה לפי צמד שפות וסוג תוכן, והפער ביניהם יכול לנטות לכל כיוון בהתאם למה שמתורגם. שונות זו היא בדיוק הסיבה לכך שהפלטפורמה מריצה מספר מודלים על כל תרגום במקום לבחור באחד כהמלצה קבועה.