October 2, 2026
Qwen vs Grok: Koji AI model prevodi bolje?
Qwen i Grok su AI modeli opće namjene, a ne alati specifični za prevođenje, i oba su dio skupa modela koje MachineTranslation.com pokreće pri svakom prijevodu. To je važno za razumijevanje onoga što slijedi. Ovo je pogled na to kako se dva vlastita modela platforme ponašaju jedan protiv drugog, uz stvarne rezerve koje dolaze s takvom vrstom podataka, a ne natjecanje između dva vanjska izazivača i same platforme.
Što su Qwen i Grok?
Qwen je Alibabina obitelj velikih jezičnih modela, trenutno u svojoj Qwen3.8 generaciji, i dodana je u skup modela na MachineTranslation.com u sklopu kontinuiranog širenja platforme. Grok je xAI-jeva linija modela, trenutno na verziji Grok 4.7 u vrijeme pisanja ovog teksta, prošavši kroz nekoliko izdanja od verzije koju je ovaj članak izvorno uspoređivao, te se platformi pridružila zasebno. Nijedan model nije izgrađen specifično za prevođenje. Oba su sustavi opće namjene koji slučajno obrađuju mnoge jezike kao dio širih jezičnih sposobnosti, što predstavlja drugačiju početnu točku od platforme koja je izgrađena i testirana specifično oko kvalitete prijevoda.
Kako se Qwen i Grok uspoređuju na vlastitim podacima platforme MachineTranslation.com?
Tijekom posljednjih 28 dana prometa na platformi, Grok je u prosjeku ostvario bolji rezultat od Qwena: 9.26 od 10 u usporedbi s 8.87. Grokovih 10% najlošije ocijenjenih prijevoda i dalje je imalo prosjek 9.2, dok je Qwenovih 10% najlošije ocijenjenih palo na 7.6, što je veća razlika na donjoj granici nego što sam prosjek sugerira.
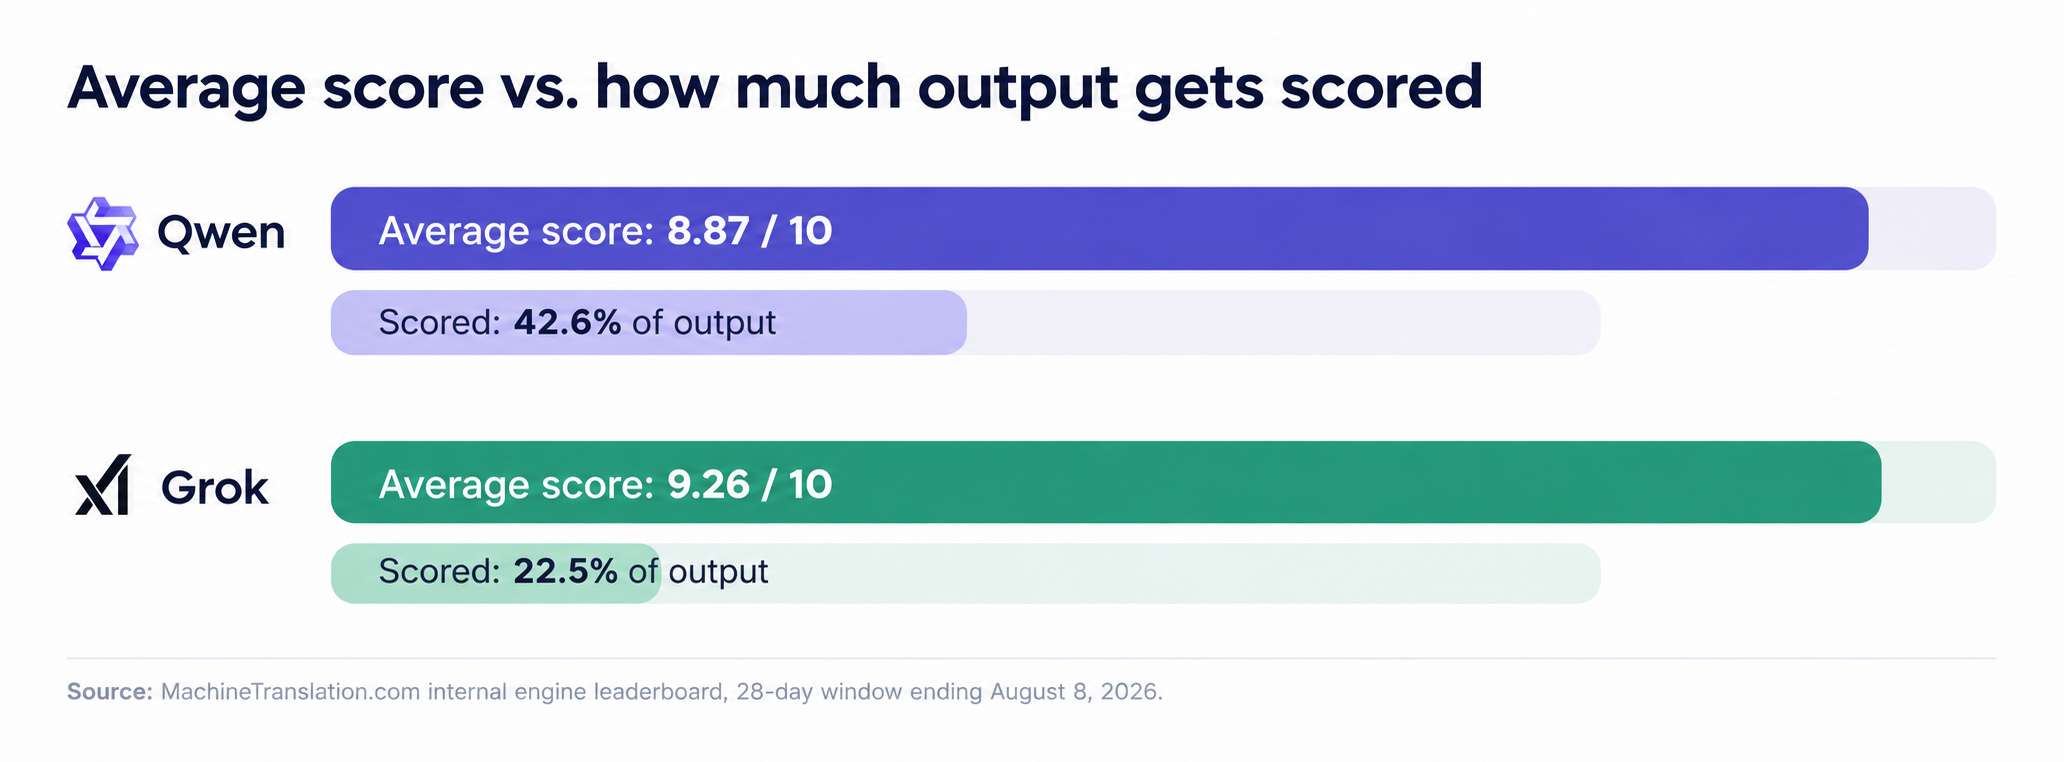
Grokov prosječni rezultat je viši, ali se temelji na ocjenjivanju manje od četvrtine njegovog izlaza, u usporedbi s gotovo polovicom kod Qwena. Dva stupca pričaju različite dijelove iste priče.
| Qwen | Grok | |
|---|---|---|
| Postotak ocijenjenog izlaza | 42.6% | 22.5% |
| Prosječna ocjena | 8.87 / 10 | 9.26 / 10 |
| Najlošijih 10% ocjena | 7.6 | 9.2 |
Izvor: Interna ljestvica sustava MachineTranslation.com, razdoblje od 28 dana zaključno s 8. kolovoza 2026.
Znači li viša ocjena modela Grok da je on bolji izbor?
Samo po sebi, ne. Grok se na platformi koristi znatno rjeđe od modela Qwen, a ocjenjuje se manje od četvrtine njegovih prijevoda, u usporedbi s gotovo polovicom prijevoda modela Qwen. Manji, manje reprezentativan uzorak može učiniti prosjek boljim ili lošijim nego što bi bio na istom volumenu koji ima Qwen. Vlastito izvješćivanje platforme MachineTranslation.com o ovim podacima tretira pokrivenost ocjenjivanjem kao stvarno ograničenje, a ne kao fusnotu: sustav ocijenjen na uskom dijelu svog prometa nije testiran tako temeljito kao onaj koji je ocijenjen na gotovo polovici svojih izlaznih rezultata.
Iskreno tumačenje je da su brojke modela Grok obećavajuće, ali utemeljene na manjem uzorku. Brojke modela Qwen u prosjeku su niže, ali počivaju na mnogo većoj, reprezentativnijoj osnovi. Nijedna činjenica ne poništava drugu.
Što je s jezičnom pokrivenošću?
Ni Qwen ni Grok ne objavljuju provjereni popis jezičnih parova kod kojih dolazi do pada performansi, i ne postoji neovisno testiranje koje bi ga potvrdilo. Ono što se sa sigurnošću može reći je da nijedan model nije izgrađen oko kvalitete prijevoda za određeni skup jezika na način na koji to jest namjenska platforma za prevođenje. MachineTranslation.com izravno testira i podržava više od 270 jezika, što je drugačija vrsta tvrdnje od široke, ali netestirane višejezične sposobnosti modela opće namjene.
Kako MachineTranslation.com zapravo koristi Qwen i Grok
MachineTranslation.com pri svakom prevođenju pokreće Qwen, Grok i više od 20 drugih AI modela, a zatim prikazuje verziju oko koje se ti modeli najviše slažu. Nijedan model nije isključen zbog prosječno niže ocjene. Istovremeno pokretanje mnogih modela znači hvatanje onih slučajeva u kojima model s prosječno nižom ocjenom i dalje točno prevede određenu rečenicu koju model s višom ocjenom promaši. Performanse modela Qwen također se razlikuju prema smjeru i jezičnom paru na načine koje vrijedi znati prije odabira jednog modela, što je detaljnije obrađeno u usporedbi modela Qwen i DeepSeek platforme MachineTranslation.com. Za detaljniji pregled načina na koji se modeli izravno testiraju jedan protiv drugog, pogledajte cjelokupno testiranje usporedbe modela na platformi MachineTranslation.com.
Često postavljana pitanja
1. Je li za prevođenje bolji Qwen ili Grok?
Prema vlastitim podacima o prevoditeljskim sustavima platforme MachineTranslation.com u razdoblju od 28 dana, Grok u prosjeku postiže višu ocjenu od Qwena, 9.26 u usporedbi s 8.87 od 10. Međutim, Grok se ocjenjuje na znatno manjem, manje reprezentativnom dijelu svog ispisa, tako da ovo nije čista izravna usporedba na način na koji bi to bio test podudarnih segmenata.
2. Zašto Grok ima višu prosječnu ocjenu, ali manje ocijenjenih prijevoda?
Grok se na platformi koristi rjeđe i samo se oko 22.5% njegovog ispisa ocjenjuje, u usporedbi s 42.6% za Qwen. Manji, manje reprezentativan uzorak može napuhati ili umanjiti prosjek, zbog čega bi se ova usporedba trebala tumačiti kao okvirna, a ne konačna.
3. Podržava li Qwen ili Grok više jezika?
Oba su AI modeli opće namjene bez objavljenog, provjerenog popisa ograničenja specifičnih za pojedine jezike. Nijedan nije izgrađen specifično za prevođenje, što se razlikuje od platforme koja izravno testira i ocjenjuje kvalitetu prijevoda na više od 270 jezika, umjesto da se oslanja na opsežno višejezično treniranje kao zamjenu za izmjerene performanse prijevoda.
4. Konkurira li MachineTranslation.com Qwenu i Groku?
Ne. MachineTranslation.com pokreće Qwen, Grok i više od 20 drugih AI modela na svakom prijevodu te prikazuje verziju oko koje se ti modeli najviše slažu. Platforma testira i kombinira ovakve modele umjesto da im konkurira kao zaseban, vlastiti model.
5. Koji AI model MachineTranslation.com preporučuje za prevođenje?
Prema zadanim postavkama, nijedan. Različiti modeli postižu različite rezultate ovisno o jezičnom paru i vrsti sadržaja, a razlika među njima može ići u korist bilo kojeg od njih ovisno o tome što se prevodi. Upravo je ta varijacija razlog zašto platforma pokreće više modela na svakom prijevodu umjesto da odabere samo jedan kao trajnu preporuku.