May 8, 2026
Grok vs. Claude per la traduzione: cosa mostrano i benchmark (2026)
Grok (xAI) e Claude (Anthropic) sono entrambi validi strumenti di traduzione AI, ma hanno punti di forza strutturalmente diversi. Per la maggior parte delle attività di traduzione generale, non noterai una differenza significativa tra di loro. Per due scenari specifici (la traduzione di contenuti su eventi recenti e la traduzione di documenti formali che richiedono precisione), la differenza è reale e fondata su come ciascun modello è stato costruito.
Questo articolo illustra ciò che ciascun modello offre effettivamente per la traduzione, dove li collocano i benchmark indipendenti e cosa utilizzare quando l'output di uno dei due modelli da solo non è sufficiente.
Come si confrontano Grok e Claude in termini di qualità della traduzione?
La risposta breve: Claude è leader nei benchmark indipendenti di traduzione professionale. Il vantaggio specifico di Grok è l'accesso alla conoscenza in tempo reale, non la qualità complessiva della traduzione.
Nei benchmark interni di MachineTranslation.com, Claude (livello 3.5 Sonnet) ottiene un punteggio di 93.8 su 100 nella qualità della traduzione — accuratezza, terminologia e stile combinati. Grok non figura tra le prime 14 soluzioni nello State of Translation Automation 2025 di Intento, che ha valutato 46 motori MT e LLMs su 11 coppie linguistiche. Claude Opus 4 e Claude Sonnet 3.7 appaiono entrambi nella top 14. Fonte: Benchmark interni di MachineTranslation.com; Intento State of Translation Automation 2025.
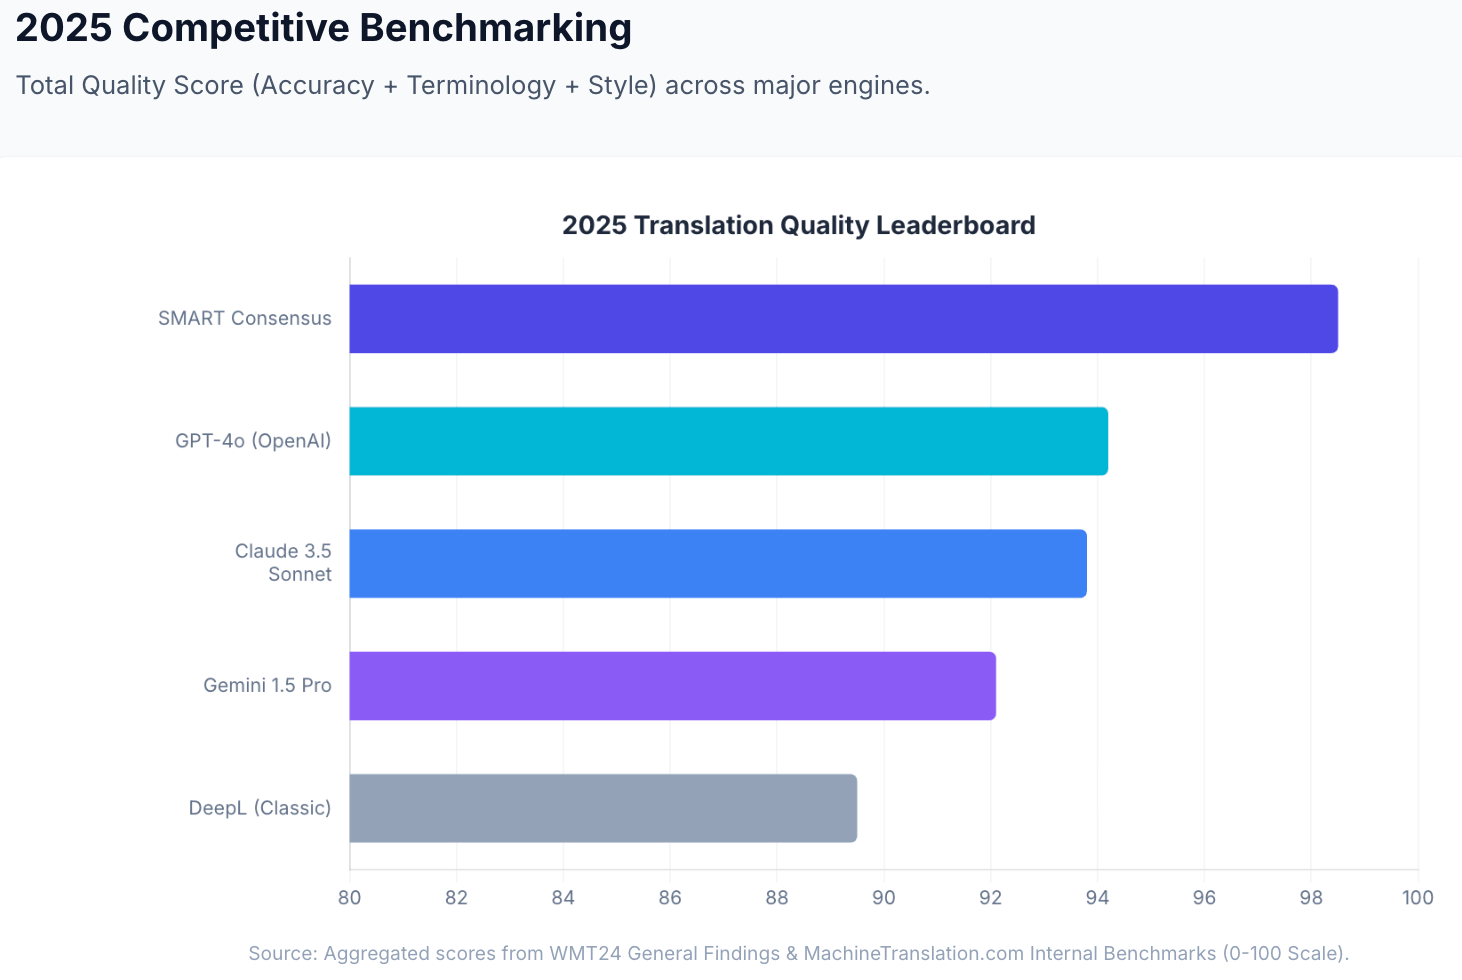
A WMT24 (la principale competizione indipendente di benchmark del settore della traduzione), Claude 3.5 si è classificato al primo posto in 9 coppie linguistiche su 11, davanti a GPT-4 e ai motori di MT neurale dedicati. Nello studio in cieco del 2025 di Lokalise condotto da traduttori professionisti, il 78% delle traduzioni di Claude 3.5 è stato valutato come buono — la percentuale più alta tra tutti gli LLM testati.
Grok non è stato valutato in WMT24 o nella valutazione LQA indipendente di Intento a un livello comparabile. La Slator Pro Guide (2025) annovera Grok tra gli LLMs generalisti utilizzati per la traduzione in contesti professionali, accanto a GPT e Claude, ma non lo posiziona al di sopra di nessuno dei due.
| Benchmark | Grok | Claude |
|---|---|---|
| Punteggio di qualità interno di MachineTranslation.com | Non misurato a livello di benchmark | 93.8/100 (livello 3.5 Sonnet) |
| Le 14 migliori soluzioni di Intento 2025 | Non in elenco | Claude Opus 4 e Sonnet 3.7 entrambi in elenco |
| Coppie linguistiche WMT24 | Non valutato | 1° in 9/11 coppie linguistiche |
| Studio in cieco Lokalise 2025 | Non valutato | 78% buono (il più alto tra tutti gli LLM) |
Fonte: Benchmark interni di MachineTranslation.com; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
Dove Grok ha un reale vantaggio?
Traduzione in tempo reale e di attualità. La caratteristica architettonica distintiva di Grok è la sua integrazione con i dati della piattaforma X (precedentemente Twitter) e la ricerca internet in tempo reale. A differenza di Claude e della maggior parte degli altri LLMs, che sono addestrati su dataset statici con limiti di conoscenza fissi, Grok incorpora informazioni in tempo reale nei suoi output. Per le attività di traduzione che riguardano eventi recenti, prodotti appena lanciati, terminologia politica emergente, notizie di attualità o contenuti che fanno riferimento a eventi accaduti nelle ultime settimane, Grok ha accesso a un contesto che Claude non ha.
Questo è particolarmente importante per: tradurre articoli di notizie su eventi recenti, localizzare annunci di prodotti per mercati in rapida evoluzione, gestire terminologia di recente conio o slang successivi ai dati di addestramento di altri modelli, e qualsiasi contenuto in cui il significato dipenda dalla conoscenza di ciò che è accaduto di recente.
Terminologia emergente e in evoluzione. I settori tecnici, le industrie e i contesti culturali producono continuamente nuova terminologia. Per le attività di traduzione che comportano termini coniati di recente, un nuovo linguaggio normativo o una nuova nomenclatura dei prodotti, l'addestramento aggiornato e la ricerca in tempo reale di Grok gli consentono di accedere a modelli d'uso che gli snapshot di dati di addestramento più vecchi non catturano.
Finestra di contesto e ragionamento di Grok 4.1. Grok 4.1 (a fine 2025) offre una finestra di contesto da 131K token e capacità di ragionamento migliorate, rendendolo efficace su documenti complessi e multilivello in cui le relazioni tra le clausole e la coerenza logica contano.
Dove ha un reale vantaggio Claude?
Qualità della traduzione su benchmark indipendenti. Il vantaggio di Claude è documentato da valutazioni professionali indipendenti anziché da affermazioni auto-dichiarate. WMT24 ha classificato Claude 3.5 al primo posto in 9 coppie linguistiche su 11 rispetto all'intero panorama competitivo. Lo studio in cieco del 2025 di Lokalise ha rilevato che i traduttori professionisti hanno preferito l'output di Claude 3.5 con una percentuale di buono del 78% — superiore a GPT-4, DeepL e Google Translate nella stessa valutazione. Queste sono valutazioni alla cieca: traduttori professionisti hanno valutato l'output senza sapere quale modello lo avesse prodotto.
Coppie linguistiche specifiche per Intento 2025. Claude Opus 4 e Sonnet 3.7 figurano nella categoria best per le combinazioni da inglese a tedesco, da inglese a giapponese, da inglese a italiano, da inglese a coreano, da inglese a olandese, da inglese a arabo e da inglese a francese nella valutazione LQA umana di Intento. Per queste coppie, Claude è la scelta documentata più forte tra i due.
Precisione del tono e contenuti sfumati. I traduttori professionisti nello studio di Lokalise hanno preferito l'output di Claude con la percentuale più alta rispetto a qualsiasi LLM — riflettendo la documentata capacità di Claude nel preservare il registro, la voce dell'autore e il significato contestuale. Per la traduzione letteraria, i documenti legali, le comunicazioni formali e i testi di marketing, in cui il modo in cui qualcosa viene detto conta tanto quanto ciò che viene detto, Claude ottiene costantemente ottimi risultati nelle valutazioni indipendenti.
Coerenza nei documenti lunghi. Claude 4.6 Sonnet supporta una finestra di contesto da 200K token, con Claude Opus 4.6 che supporta 1M di token in beta. Per lunghi documenti formali (contratti, manuali tecnici, report di studi clinici), Claude può elaborare l'intero documento in un unico passaggio, mantenendo la coerenza terminologica in tutto il testo. I documenti elaborati in frammenti mostrano un tasso di incoerenza terminologica superiore del 28% rispetto all'elaborazione dell'intero documento. Fonte: Dati interni di MachineTranslation.com.
Come si confrontano in termini di supporto linguistico e prezzi?
Supporto linguistico: Sia Grok 4.1 che Claude 4.6 supportano la traduzione nella maggior parte delle principali lingue del mondo. Claude è stato valutato in modo indipendente su coppie linguistiche europee e dell'Asia orientale con ottimi risultati. Il supporto multilingue di Grok è migliorato nel corso delle versioni successive. Per le lingue a basse risorse, entrambi i modelli subiscono un calo di qualità — la revisione umana è opportuna per i contenuti in combinazioni linguistiche a basse risorse, indipendentemente dal modello utilizzato.
Prezzi:
| Piano | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Consumer (mensile) | SuperGrok: $30/mese | Claude Pro: $20/mese |
| Input API (per M token) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| Output API (per M token) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Piano gratuito | Sì (con limitazioni di frequenza tramite X/Grok.com) | Sì (con limitazioni di frequenza tramite claude.ai) |
A livello consumer, Claude Pro ($20/month) is cheaper than SuperGrok ($30/mese). A livello di API, Grok 4.1 ha un leggero vantaggio in termini di costi rispetto a Claude Sonnet 4.6 per flussi di lavoro di traduzione ad alta intensità di input.
Qual è il migliore per tipi di contenuto specifici?
| Tipo di contenuto | Modello consigliato | Motivo |
|---|---|---|
| Notizie recenti / attualità | Grok | Accesso ai dati in tempo reale; i modelli con addestramento statico mancano del contesto attuale |
| Terminologia emergente / lanci di nuovi prodotti | Grok | L'integrazione della ricerca live acquisisce i modelli di utilizzo recenti |
| Documenti legali formali | Claude | Valutazione indipendente WMT24 e Lokalise 2025; precisione del tono |
| Contenuto medico / clinico | Claude | Posizionamento nei benchmark indipendenti; preservazione del registro |
| Testi di marketing / contenuti creativi | Claude | Preferenza nello studio in cieco di Lokalise 2025; sfumature di tono |
| Documentazione tecnica (lunga) | Claude | Finestra di contesto da 200K-1M; coerenza terminologica su tutta la lunghezza |
| Social media / contenuti conversazionali | Entrambi | Entrambi gestiscono bene le coppie conversazionali ad alta risorsa |
| Integrazione sviluppatore / API | Entrambi | Entrambi offrono l'accesso alle API; Grok è leggermente più economico sui token di input |
Cosa usare quando un solo modello non è sufficiente
Sia Grok che Claude sono strumenti a modello singolo. Ogni singolo modello di IA (indipendentemente da quanto sia capace) produce errori che non è in grado di rilevare nel proprio output. Una traduzione fluente e sicura da parte di Grok o Claude può comunque essere semanticamente errata, e senza una verifica incrociata non c'è modo di saperlo.
Sia Grok che Claude sono tra i 22 modelli del sistema SMART di MachineTranslation.com. SMART esegue tutti i 22 modelli simultaneamente (inclusi Grok e Claude) e restituisce l'output su cui concorda la maggioranza.
Cosa significa questo per la questione Grok vs. Claude: La forza in tempo reale di Grok e la profondità contestuale di Claude contribuiscono entrambe allo stesso consenso. Quando concordano, questo accordo è un forte segnale di qualità.
Nei benchmark interni di MachineTranslation.com, i singoli modelli di punta ottengono un punteggio di 93-94 su 100 per la qualità della traduzione. L'output di consenso di SMART raggiunge 98.5/100. Fonte: Benchmark interni di MachineTranslation.com e WMT24 General Machine Translation Findings.
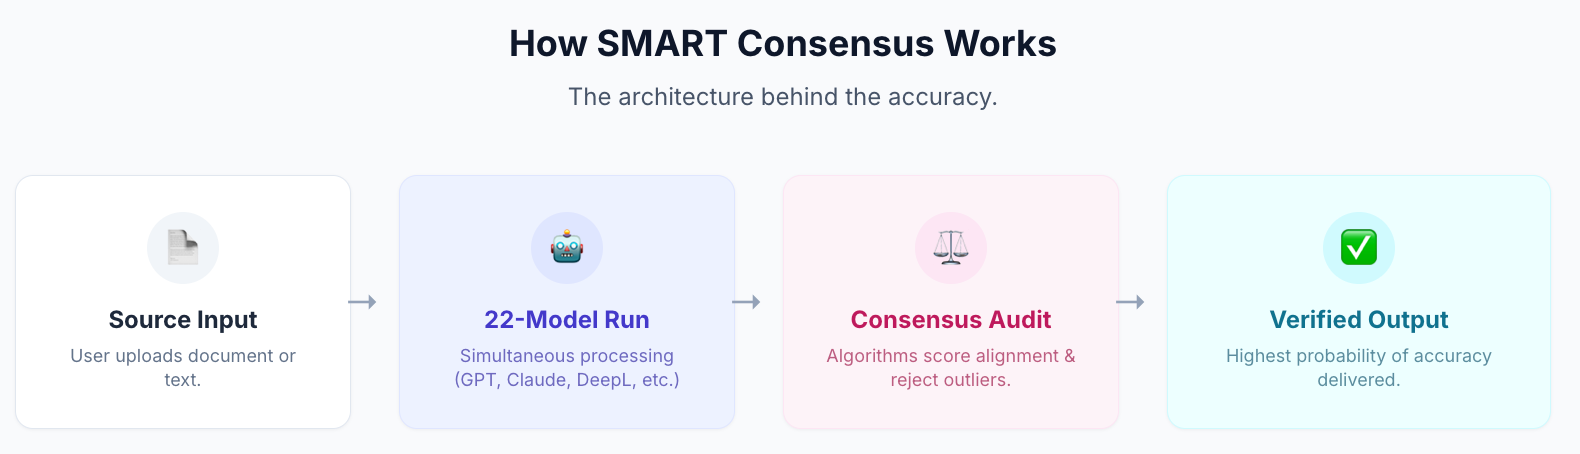
Gli utenti che sono passati dalla traduzione con motore singolo a SMART hanno impiegato il 27% di tempo in meno per verificare e correggere gli output. Fonte: Dati interni di MachineTranslation.com.
Per contenuti ad alto rischio (documenti legali, documenti normativi, istruzioni mediche), la Human Verification trasferisce il consenso SMART a un revisore professionista certificato all'interno della stessa piattaforma. Nessuna agenzia esterna. Accuratezza garantita al 100%.
Traduci con Grok, Claude e altri 20 modelli su MachineTranslation.com — gratis, senza registrazione richiesta.
Domande frequenti
1. Grok è migliore di Claude per la traduzione?
Per la maggior parte delle attività di traduzione standard, Claude è in testa nei benchmark indipendenti: primo in 9 coppie linguistiche su 11 a WMT24, valutazione buono del 78% nello studio in cieco del 2025 di Lokalise e 93.8/100 nei benchmark di qualità interni di MachineTranslation.com. Il vantaggio specifico di Grok riguarda i contenuti che richiedono la conoscenza dell'attualità, il suo accesso ai dati in tempo reale gli fornisce un contesto che i modelli addestrati su dati statici, incluso Claude, non hanno. Per le notizie recenti, la terminologia emergente e i contenuti sensibili al fattore tempo, Grok è la scelta migliore.
2. Qual è il vantaggio di Grok rispetto a Claude per la traduzione?
Grok integra dati in tempo reale da X (precedentemente Twitter) e la ricerca internet live. A differenza di Claude e della maggior parte degli altri LLMs addestrati su dataset statici, Grok può accedere a informazioni su eventi recenti, terminologia coniata di recente e contesto attuale quando genera traduzioni. Questo lo rende specificamente più forte nella traduzione di contenuti di attualità, prodotti rilasciati di recente e qualsiasi materiale in cui il significato dipenda da eventi o modelli linguistici delle ultime settimane.
3. Qual è il vantaggio di Claude rispetto a Grok per la traduzione?
Il vantaggio di Claude è documentato tramite una valutazione professionale indipendente. Claude 3.5 si è classificato al primo posto in 9 coppie linguistiche su 11 al WMT24, e i traduttori professionisti nello studio in cieco 2025 di Lokalise hanno preferito il suo output con una percentuale di buono del 78% — la più alta tra tutti gli LLM testati. Claude appare anche tra le prime 14 soluzioni di Intento in diverse coppie linguistiche nella valutazione LQA umana, mentre Grok no. Per attività di traduzione formali, professionali e ad alta rilevanza, il posizionamento nei benchmark indipendenti di Claude è il differenziatore documentato.
4. Qual è il migliore per la traduzione legale, Grok o Claude?
Claude è la scelta più solida per la traduzione legale in base a una valutazione indipendente. Claude 3.5 si è classificato al primo posto nella maggior parte delle coppie linguistiche europee ad alte risorse al WMT24 e ha ricevuto le valutazioni di preferenza più alte negli studi in cieco da parte di traduttori professionisti. Per i contenuti legali che richiedono un'accuratezza certificata, nessuno dei due modelli da solo è sufficiente — la Human Verification di MachineTranslation.com fornisce un'accuratezza del 100% da parte di un revisore professionista certificato all'interno della stessa piattaforma, senza necessità di fornitori esterni.
5. Sia Grok che Claude sono disponibili su MachineTranslation.com?
Sì. Entrambi sono tra i 22 modelli del sistema SMART di MachineTranslation.com. Ogni traduzione SMART esegue Grok, Claude e altri 20 modelli simultaneamente, restituendo l'output su cui concorda la maggioranza. Anziché scegliere tra loro, ricevi il consenso di tutti i modelli AI.
6. Come si confrontano Grok e Claude in termini di prezzo?
Nella fascia consumer, Claude Pro costa $20/month versus SuperGrok at $30 al mese. A livello di API, Grok 4.1 è leggermente più economico sui token di input ($2/M vs. $3/M per Claude Sonnet 4.6) e di output ($10/M vs. $15/M). Il piano gratuito di MachineTranslation.com include entrambi i modelli come parte del consenso a 22 modelli di SMART, senza registrazione richiesta.
7. Quale modello di IA è il migliore per tradurre articoli di notizie?
Per tradurre articoli di notizie, Grok ha un vantaggio strutturale: la sua integrazione di dati in tempo reale significa che dispone del contesto attuale sugli eventi descritti, che i modelli con addestramento statico potrebbero non avere. Per la traduzione di notizie generali in cui l'attualità non è critica, le prestazioni nei benchmark di Claude sono superiori. Per la traduzione di notizie ad alto volume, in cui sia l'attualità che l'accuratezza sono importanti, SMART di MachineTranslation.com esegue entrambi i modelli e restituisce il loro output di consenso.