November 13, 2026
Qwen vs Gemini per la traduzione e perché la direzione conta
Hai due modelli e un elenco di combinazioni linguistiche, e devi decidere a quale modello affidare il progetto. La maggior parte dei confronti tra Qwen e Gemini risponde con un unico punteggio complessivo. Ritengo che un solo punteggio nasconda ciò che determina davvero il risultato, ossia la direzione della traduzione.
Lavoro alle modalità di test dei modelli eseguiti su MachineTranslation.com, quindi posso confrontare Qwen e Gemini su 98 combinazioni linguistiche valutate su un testo identico. Gemini ha ottenuto un punteggio più alto in 68 di queste combinazioni e Qwen in 29, e il divario medio è di 0,08 punti su 10. I totali da soli non dicono quale modello scegliere da urdu a inglese o da inglese a creolo haitiano.
Questo articolo mostra dove i due modelli sono vicini e dove ciascuno è in vantaggio. Spiega anche ciò che non posso ancora dirti. I miei dati si fermano all'8 agosto 2026, prima che Google annunciasse Gemini 4 a ottobre, quindi descrivono le versioni precedenti di entrambi i modelli.
Punti chiave
- Su 98 combinazioni linguistiche valutate su un testo identico (dal 12 luglio all'8 agosto 2026), Gemini ha ottenuto un punteggio più alto in 68 combinazioni, Qwen in 29, e una combinazione ha registrato un pareggio.
- Il divario medio è ridotto, 9,06 per Gemini contro 8,98 per Qwen, e 60 delle 98 combinazioni si collocano entro 0,1 punti.
- Traducendo verso l'inglese, Qwen è in vantaggio di oltre 0,1 punti in 7 combinazioni su 27 e Gemini in 3; le altre 17 rientrano entro 0,1 punti.
- Traducendo dall'inglese, Gemini è in vantaggio di oltre 0,1 punti in 13 combinazioni su 29 e Qwen in nessuna.
- I dati terminano prima che Google annunciasse Gemini 4 nell'ottobre 2026, quindi descrivono le versioni precedenti di Gemini e richiedono una nuova esecuzione prima di poter essere considerati aggiornati.
È migliore Qwen o Gemini per la traduzione?
Dipende dalla direzione, perché i due modelli sono vicini quando la lingua di arrivo è l'inglese e Gemini ottiene punteggi più alti nella maggior parte delle altre combinazioni. Su tutte le 98 combinazioni, Gemini ha ottenuto un punteggio più alto in 68. Nei punteggi di MachineTranslation.com dal 12 luglio all'8 agosto 2026, Gemini ha registrato una media di 9,06 su 10 e Qwen di 8,98, con un divario medio di 0,08 punti.
Il panel conteggia solo i segmenti in cui ChatGPT, Claude, DeepSeek, Gemini e Qwen hanno ricevuto tutti un punteggio effettivo, in modo che ogni modello venga valutato su un testo di partenza identico. Ciascuna combinazione linguistica include almeno 30 segmenti. Utilizzo questo panel perché elimina un errore comune, ovvero confrontare i modelli su testi diversi.
In termini numerici, Gemini è in vantaggio in 68 combinazioni (69%), Qwen in 29 (30%), e una combinazione ha registrato una parità. Il solo conteggio sovrastima il divario, poiché 60 delle 98 combinazioni si collocano entro 0,1 punti. Le sezioni successive suddividono i risultati per direzione e per margine.
Quali direzioni di traduzione favoriscono ciascun modello?
Gemini è in vantaggio quando l'inglese è la lingua di partenza o quando nessuna delle due lingue è l'inglese, mentre Qwen è alla pari o in vantaggio quando l'inglese è la lingua di arrivo. Dall'inglese, Gemini è in vantaggio di oltre 0,1 punti in 13 combinazioni su 29 e Qwen in nessuna. Verso l'inglese, Qwen è in vantaggio con tale margine in 7 combinazioni su 27 e Gemini in 3.
| Direzione | Coppie | Gemini in vantaggio di oltre 0,1 | Entro 0,1 punti | Qwen in vantaggio di oltre 0,1 | Divario medio |
|---|---|---|---|---|---|
| Verso l'inglese | 27 | 3 | 17 | 7 | Qwen +0,04 |
| Dall'inglese | 29 | 13 | 16 | 0 | Gemini +0,16 |
| Nessuna delle due lingue è l'inglese | 42 | 14 | 27 | 1 | Gemini +0,13 |
Verso l'inglese, 17 coppie su 27 si trovano entro 0,1 punti, Qwen è in testa in 7 e Gemini in 3. Dall'inglese, 16 coppie su 29 si trovano entro 0,1 punti, Gemini è in testa in 13 e Qwen in nessuna. Laddove nessuna delle due lingue è l'inglese, 27 su 42 si trovano entro 0,1 punti, Gemini è in testa in 14 e Qwen in 1.
Qwen si trova entro 0,1 punti da Gemini o in testa in 24 delle 27 coppie verso l'inglese. Calcolando la media per direzione, Qwen è in vantaggio di circa 0,04 punti verso l'inglese, mentre Gemini è avanti di circa 0,16 punti dall'inglese e di 0,13 punti tra due lingue diverse dall'inglese.
Non so perché si verifichi questa divergenza, e questi dati non possono dirmelo. Una spiegazione che verificherei per prima è il mix di testi di addestramento alla base di ciascun modello, ma non ho eseguito questo test. Qwen mostra un andamento simile nei confronti di ChatGPT. Sullo stesso panel, il nostro confronto Qwen vs ChatGPT ha evidenziato che i due modelli sono quasi pari verso l'inglese, con ChatGPT in vantaggio nell'89% delle altre coppie.
Quali coppie linguistiche mostrano i divari maggiori?
I divari maggiori favoriscono Gemini. È in testa con un margine da 0,51 a 0,95 punti nelle combinazioni da russo a kazako, da inglese a creolo haitiano, da inglese a tagalog, da spagnolo a greco e da arabo a persiano. I vantaggi maggiori di Qwen sono più contenuti, compresi tra 0,15 e 0,26 punti, e quattro delle sue prime cinque coppie sono verso l'inglese.
| Coppia linguistica | Punteggio Gemini | Punteggio Qwen | Divario |
|---|---|---|---|
| Dal russo al kazako | 9,27 | 8,32 | Gemini +0,95 |
| Dall'inglese al creolo haitiano | 9,19 | 8,27 | Gemini +0,92 |
| Dall'inglese al tagalog | 9,14 | 8,43 | Gemini +0,70 |
| Dallo spagnolo al greco | 8,90 | 8,33 | Gemini +0,57 |
| Dall'arabo al persiano | 8,84 | 8,34 | Gemini +0,51 |
| Dall'urdu all'inglese | 8,56 | 8,81 | Qwen +0,26 |
| Dal cinese all'inglese | 9,00 | 9,19 | Qwen +0,19 |
| Da svedese a inglese | 8,29 | 8,46 | Qwen +0,16 |
| Da cinese a indonesiano | 9,03 | 9,19 | Qwen +0,16 |
| Da birmano a inglese | 8,94 | 9,09 | Qwen +0,15 |
Non considererei queste come classifiche definitive. I due divari più ampi, da russo a kazako e da inglese a creolo haitiano, si basano su campioni più ridotti rispetto alla coppia mediana. Da inglese a tagalog, da spagnolo a greco e da arabo a persiano si basano su campioni più ampi, quindi darei maggiore fiducia a queste tre. Testerei nuovamente i due divari basati su campioni ridotti prima di farvi affidamento.
Cosa significa un divario di 0,1 punti?
A mio parere, un divario inferiore a 0,1 punti è troppo ridotto per decretare un vincitore. Delle 98 coppie, 60 rientrano in questo margine, e ciascuna coppia viene valutata su un numero limitato di segmenti. La soglia di 0,1 è la mia personale soglia di riferimento, e non ho eseguito un test di significatività su queste coppie.
Un punteggio non coglie inoltre alcune differenze. Nei nostri test sulle frasi comuni, abbiamo sottoposto "sorry" in arabo a 22 modelli di IA. Sia Gemini che Qwen hanno scelto l'informale آسف. ChatGPT e il risultato combinato hanno scelto il formale عذرًا. Ogni modello ha ottenuto un punteggio di 9,5, quindi le due parole differiscono per registro e il punteggio non è variato.
Ecco perché valuto il margine e gli esempi di registro insieme. Un divario ridotto con una visibile differenza di registro richiede una decisione umana. Un ampio divario su un campione limitato richiede una ripetizione del test.
Qwen e Gemini commettono tipi diversi di errori?
Sì, perché nel nostro test sulle citazioni dei Mondiali 2026 entrambi i modelli hanno fatto almeno una scelta che gli altri modelli non hanno fatto, e i punteggi sono variati a malapena. Gemini ha tradotto una frase di Mbappé come "with each game" e ha reso una citazione di Wirtz parola per parola, mentre Qwen ha fornito un'interpretazione diversa di una citazione di Scaloni. I punteggi per questi casi andavano da 9,2 a 9,5.
I dettagli provengono dal nostro test sulle citazioni dei Mondiali. Sulla citazione di Mbappé incentrata sul guardare avanti, gli altri modelli hanno mantenuto "match", mentre Gemini ha scritto "with each game", una lieve svista di registro che ha ottenuto un punteggio di 9,4. Su una citazione di Wirtz, Gemini ha tradotto una frase parola per parola alterandone il significato, registrando anch'esso 9,4. Sulla citazione di Scaloni, la maggior parte dei modelli è confluita su un'unica interpretazione, mentre Qwen ha scritto "that is what matters" ottenendo 9,4. Sulla citazione tattica di Mbappé, Claude e DeepSeek hanno scelto l'inglese calcistico britannico, mentre Gemini, Qwen e gli altri hanno scelto l'inglese americano, e Qwen ha ottenuto 9,2, un punteggio inferiore rispetto agli altri.
Interpreto queste tendenze come piccole abitudini. Gli esempi di Gemini riguardano il registro e la formulazione letterale. Quelli di Qwen riguardano quale interpretazione di una frase scegliere. Quattro esempi sono troppo pochi per definirli uno schema ricorrente, ma mostrano il tipo di differenza che un singolo punteggio nasconde.
Quale modello Qwen è il migliore per la traduzione?
Non posso dirlo in base ai nostri dati, poiché i punteggi di MachineTranslation.com trattano Qwen come un unico modello senza un'indicazione della versione. La famiglia Qwen3.8 di Alibaba ha raggiunto Hugging Face nell'agosto 2026, quindi ora esistono diverse versioni e i punteggi in questo articolo non le separano.
Vorrei suddividere questi dati per versione, ma non posso ancora farlo. Il dato a livello di piattaforma potrebbe calcolare la media su più di una versione di Qwen attiva in quell'intervallo temporale. Se devi scegliere tra le versioni di Qwen per un progetto, ti consiglio di confrontarle su un campione del tuo testo.
Quali sono alcune alternative a Gemini per la traduzione?
ChatGPT, Claude, DeepSeek, Qwen, Grok e Mistral AI sono tutti disponibili su MachineTranslation.com, e l'alternativa giusta dipende dalla coppia linguistica. Nei nostri punteggi dal 12 luglio all'8 agosto 2026, Qwen si trova a meno di 0,1 punti da Gemini o in vantaggio in 24 coppie su 27 verso l'inglese. I nostri punteggi per il francese con Mistral AI mostrano che la sua media da francese a inglese si colloca 0,40 punti sopra quella di Gemini.
Se la tua alternativa è ChatGPT, la risposta varia anche in base alla coppia linguistica. Nella nostra analisi pubblicata da spagnolo a inglese, Gemini ha vinto il 31% dei segmenti e ChatGPT ha vinto il 21%. Sul francese, nessuno dei due modelli vince in entrambe le direzioni. Poiché la scelta varia a seconda della coppia, MachineTranslation.com non seleziona un'unica alternativa. Le esegue insieme.
Il mio suggerimento è partire dalla coppia e dalla direzione, per poi verificare quale alternativa sia adatta.
In che modo MachineTranslation.com mostra dove Qwen e Gemini sono in disaccordo?
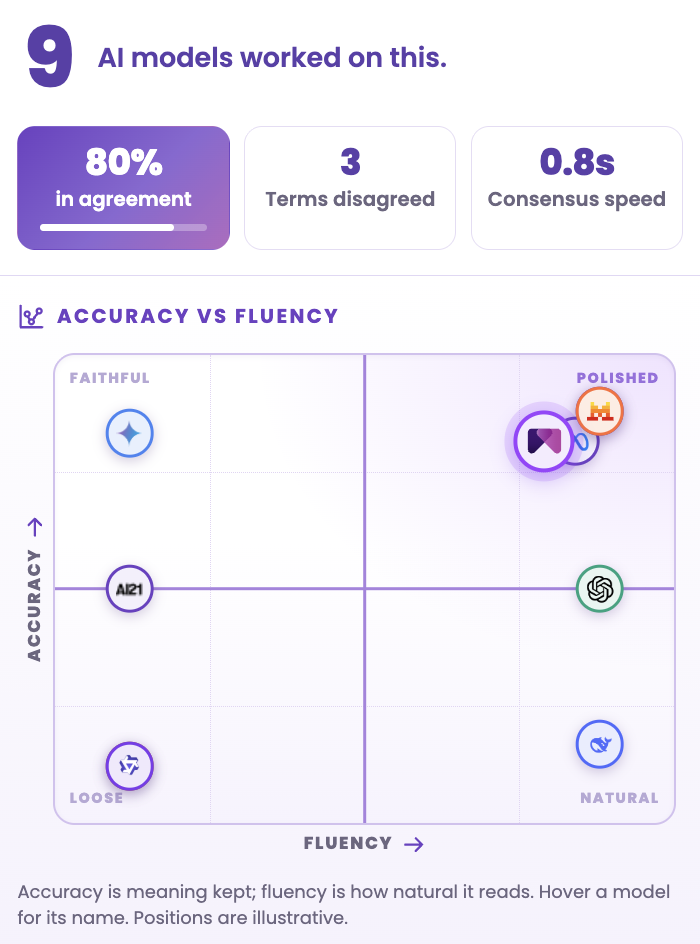
MachineTranslation.com esegue entrambi i modelli su ogni traduzione e mostra dove i modelli concordano e dove divergono. Il pannello di concordanza riporta quanti modelli di IA hanno lavorato sul testo, la percentuale di accordo, quanti termini sono stati contestati e quanto velocemente si è formato il consenso.
Quanto sono aggiornati questi risultati?
Questi risultati coprono il periodo dal 12 luglio all'8 agosto 2026, quindi descrivono le versioni di Gemini e Qwen attive in quel momento. Google ha annunciato Gemini 4 a ottobre 2026. La famiglia Qwen3.8 di Alibaba è arrivata ad agosto 2026. Il mio consiglio è rieseguire il test prima di affidarsi a questi numeri per un nuovo progetto.
Mi aspetto che il metodo di confrontare testi identici con un margine per il rumore rimanga valido. Mi aspetto che l'entità dei divari cambi. Considererei qualsiasi coppia in cui il leader si inverte in una nuova esecuzione come il segno che il divario precedente rientrava nel rumore statistico.
Come sceglierei tra Qwen e Gemini per un progetto?
La mia posizione è scegliere in base alla coppia e alla direzione, evitando di fare una scelta unica per un intero progetto. In pratica ciò significa considerare un divario inferiore a 0,1 punti come una parità e aspettarsi che il modello in testa cambi da una coppia all'altra. Questo è l'ordine che seguirei.
- Elencare ogni coppia linguistica del progetto e indicarne la direzione.
- Verifica il divario per ciascuna coppia in questo articolo. Considera un divario inferiore a 0,1 punti come un pareggio.
- Dove il divario è maggiore, parti dal modello in testa e prova un campione del tuo testo.
- Se i tuoi contenuti vanno in entrambe le direzioni, aspettati che il modello leader cambi tra le coppie.
- Controlla di nuovo quando uno dei due modelli rilascia una nuova versione.
Entrambi i modelli operano insieme ad altri 20 per ogni traduzione su MachineTranslation.com. Viene restituita la versione su cui la maggior parte concorda, quindi non è necessario compiere una scelta definitiva per l'intero progetto. L'insieme completo dei risultati dei modelli è disponibile nei nostri test di confronto tra modelli.
Domande frequenti
1. È meglio Qwen o Gemini per la traduzione?
Dipende dalla direzione, perché Qwen si trova entro 0,1 punti da Gemini o in vantaggio in 24 coppie su 27 verso l'inglese. Gemini ha comunque ottenuto punteggi più alti in 68 coppie su 98 nei punteggi di MachineTranslation.com dal 12 luglio all'8 agosto 2026. Il divario medio è di 0,08 punti su 10, quindi sceglierei in base alla coppia.
2. Quale modello Qwen è il migliore per la traduzione?
Non posso dirlo in base ai nostri dati, poiché i punteggi di MachineTranslation.com trattano Qwen come un unico modello senza indicazione di versione. La famiglia Qwen3.8 di Alibaba è arrivata su Hugging Face nell'agosto 2026, quindi ora esistono diverse versioni. Fino a quando i punteggi non le distingueranno, confronterei le versioni su un campione del tuo testo prima di sceglierne una per un progetto.
3. Quali sono alcune alternative a Gemini per la traduzione?
ChatGPT, Claude, DeepSeek, Qwen, Grok e Mistral AI sono tutti presenti su MachineTranslation.com. Nei nostri punteggi dal 12 luglio all'8 agosto 2026, Qwen è entro 0,1 punti da Gemini o in testa in 24 coppie su 27 verso l'inglese. La media di Mistral AI dal francese all'inglese è stata di 0,40 punti superiore a quella di Gemini. L'alternativa giusta dipende dalla coppia.
4. Gemini è migliore di ChatGPT per la traduzione?
Dipende dalla coppia linguistica, perché nessun modello di IA vince ovunque. Nella nostra analisi pubblicata per lo spagnolo verso l'inglese, Gemini ha vinto nel 31% dei segmenti e ChatGPT nel 21%. Per il francese, nessuno dei due modelli vince in entrambe le direzioni. Consiglierei di verificare la coppia e la direzione necessarie prima di scegliere tra i due.
5. Gemini è accurato per la traduzione?
Sì, perché Gemini ha ottenuto una media di 9,06 su 10 in 98 coppie linguistiche nei punteggi di MachineTranslation.com dal 12 luglio all'8 agosto 2026. L'accuratezza varia comunque a seconda della coppia. Il suo vantaggio è più ampio a partire dall'inglese, e Qwen lo supera di oltre 0,1 punti in 7 coppie su 27 verso l'inglese.