October 2, 2026
Qwen vs Grok: Quale modello IA traduce meglio?
Qwen e Grok sono entrambi modelli IA di uso generale, non strumenti specifici per la traduzione, ed entrambi fanno parte del pool di modelli che MachineTranslation.com esegue per ogni traduzione. Questo è importante per capire come interpretare quanto segue. Questa è un'analisi di come due dei modelli della piattaforma stessa si comportano l'uno rispetto all'altro, con le necessarie avvertenze che derivano da questo tipo di dati, non una competizione tra due sfidanti esterni e la piattaforma stessa.
Cosa sono Qwen e Grok?
Qwen è la famiglia di modelli linguistici di grandi dimensioni di Alibaba, attualmente alla generazione Qwen3.8, ed è stata aggiunta al pool di modelli di MachineTranslation.com come parte della continua espansione della piattaforma. Grok è la linea di modelli di xAI, attualmente alla versione Grok 4.7 al momento della stesura di questo articolo, essendo passata attraverso diverse versioni rispetto a quella originariamente confrontata in questo articolo, per poi unirsi alla piattaforma separatamente. Nessuno dei due modelli è stato creato appositamente per la traduzione. Entrambi sono sistemi di uso generale che si trovano a gestire molte lingue come parte di una più ampia capacità linguistica, il che rappresenta un punto di partenza diverso rispetto a una piattaforma costruita e testata specificamente sulla qualità della traduzione.
Come si confrontano Qwen e Grok sui dati della stessa MachineTranslation.com?
Negli ultimi 28 giorni di traffico sulla piattaforma, Grok ha ottenuto in media un punteggio più alto rispetto a Qwen: 9.26 su 10 contro 8.87. Il 10% delle traduzioni di Grok con il punteggio peggiore ha comunque mantenuto una media di 9.2, mentre il 10% peggiore di Qwen è sceso a 7.6, un divario nella fascia bassa più ampio di quanto suggerisca la sola media.
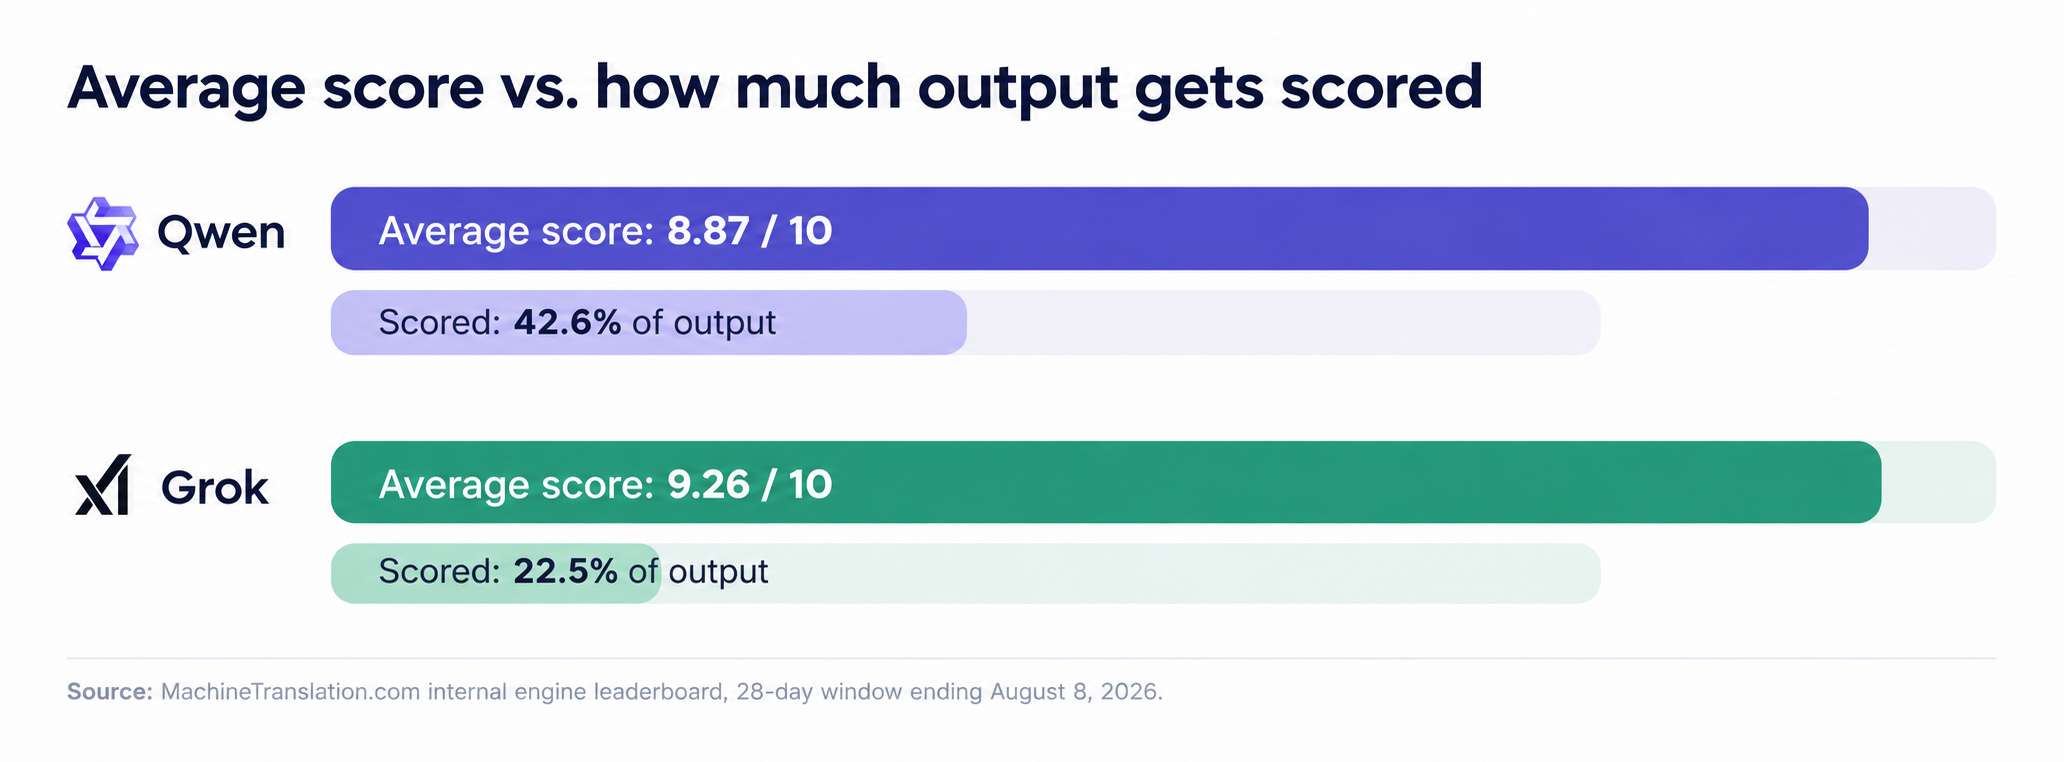
Il punteggio medio di Grok è più alto, ma si basa sulla valutazione di meno di un quarto del suo output, contro quasi la metà per Qwen. Le due barre raccontano parti diverse della stessa storia.
| Qwen | Grok | |
|---|---|---|
| Percentuale di output valutato | 42.6% | 22.5% |
| Punteggio medio | 8.87 / 10 | 9.26 / 10 |
| Il 10% inferiore dei punteggi | 7.6 | 9.2 |
Fonte: classifica interna dei motori di MachineTranslation.com, finestra di 28 giorni terminata l'8 agosto 2026.
Il punteggio più alto di Grok significa che è la scelta migliore?
Non da solo. Grok viene utilizzato molto meno spesso sulla piattaforma rispetto a Qwen, e meno di un quarto delle sue traduzioni viene valutato, contro quasi la metà di quelle di Qwen. Un campione più piccolo e meno rappresentativo può far sembrare una media migliore o peggiore di quanto lo sarebbe se calcolata sullo stesso volume analizzato per Qwen. I report della stessa MachineTranslation.com su questi dati considerano la copertura dei punteggi come un limite reale, non come una nota a piè di pagina: un motore valutato su una fetta ristretta del suo traffico non è stato testato in modo altrettanto approfondito di uno valutato su quasi la metà del suo output.
L'interpretazione onesta è che i numeri di Grok sono promettenti ma meno consistenti. Quelli di Qwen sono in media più bassi, ma poggiano su una base molto più ampia e rappresentativa. Nessuno dei due fatti annulla l'altro.
E per quanto riguarda la copertura linguistica?
Né Qwen né Grok pubblicano un elenco verificato di coppie linguistiche in cui le prestazioni diminuiscono, e non esistono test indipendenti a confermarlo. Ciò che si può affermare con sicurezza è che nessuno dei due modelli è stato creato attorno alla qualità della traduzione per un set specifico di lingue, come invece accade per una piattaforma di traduzione dedicata. MachineTranslation.com testa e supporta direttamente oltre 270 lingue, un'affermazione di natura diversa rispetto all'ampia, ma non testata, capacità multilingue di un modello di uso generale.
Come MachineTranslation.com utilizza effettivamente Qwen e Grok
MachineTranslation.com esegue Qwen, Grok e oltre 20 altri modelli IA su ogni traduzione, per poi proporre la versione su cui tali modelli concordano maggiormente. Nessun modello viene escluso per aver ottenuto un punteggio medio inferiore. Eseguire molti modelli contemporaneamente significa individuare i casi in cui un modello con un punteggio medio inferiore traduce correttamente una frase specifica che, invece, un modello con un punteggio superiore sbaglia. Le prestazioni di Qwen, inoltre, variano in base alla direzione e alla combinazione linguistica in modi che vale la pena conoscere prima di scegliere un singolo modello, un aspetto analizzato in modo più approfondito nel confronto Qwen vs DeepSeek di MachineTranslation.com. Per un'analisi più dettagliata di come i modelli vengono testati direttamente l'uno contro l'altro, consulta i test completi di confronto dei modelli di MachineTranslation.com.
Domande frequenti
1. È meglio Qwen o Grok per la traduzione?
Sui dati a 28 giorni dei motori di MachineTranslation.com, Grok ottiene in media un punteggio superiore a Qwen, 9.26 contro 8.87 su 10. Ma Grok viene valutato su una porzione del suo output molto più piccola e meno rappresentativa, per cui non si tratta di un vero e proprio testa a testa come lo sarebbe un test su segmenti abbinati.
2. Perché Grok ha un punteggio medio più alto ma meno traduzioni valutate?
Grok è usato meno spesso sulla piattaforma e solo circa il 22.5% del suo output viene valutato, contro il 42.6% di Qwen. Un campione più piccolo e meno rappresentativo può gonfiare o sottostimare una media, motivo per cui questo confronto dovrebbe essere letto come indicativo, non definitivo.
3. Supporta più lingue Qwen o Grok?
Entrambi sono modelli IA di uso generale senza un elenco pubblicato e verificato di limitazioni specifiche per lingua. Nessuno dei due è costruito specificamente per la traduzione, il che è diverso da una piattaforma che testa e valuta direttamente la qualità della traduzione su oltre 270 lingue, piuttosto che affidarsi a un ampio addestramento multilingue come sostituto delle prestazioni di traduzione misurate.
4. MachineTranslation.com compete con Qwen e Grok?
No. MachineTranslation.com esegue Qwen, Grok e più di 20 altri modelli IA su ogni traduzione e propone la versione su cui questi modelli concordano maggiormente. Testa e combina modelli come questi piuttosto che competere contro di essi come un modello separato a sé stante.
5. Quale modello IA raccomanda MachineTranslation.com per la traduzione?
Nessuno per impostazione predefinita. Modelli diversi hanno prestazioni diverse in base alla combinazione linguistica e al tipo di contenuto, e il divario tra di essi può pendere da una parte o dall'altra a seconda di ciò che viene tradotto. Questa variazione è esattamente il motivo per cui la piattaforma esegue più modelli su ogni traduzione piuttosto che sceglierne uno come raccomandazione fissa.