October 2, 2026
Qwen vs Grok: kuris DI modelis verčia geriau?
Qwen ir Grok yra bendrosios paskirties DI modeliai, o ne specialiai vertimui skirti įrankiai, ir abu jie yra dalis modelių rinkinio, kurį MachineTranslation.com naudoja kiekvienam vertimui. Tai svarbu norint suprasti tai, kas išdėstyta toliau. Čia apžvelgiama, kaip du pačios platformos modeliai pasirodo vienas kito atžvilgiu, su realiomis išlygomis, kurios lydi tokio pobūdžio duomenis, o ne varžybos tarp dviejų išorinių konkurentų ir pačios platformos.
Kas yra Qwen ir Grok?
Qwen yra Alibaba didelių kalbos modelių šeima, šiuo metu pasiekusi Qwen3.8 kartą, ir buvo įtraukta į MachineTranslation.com modelių rinkinį vykstant nuolatinei platformos plėtrai. Grok yra xAI modelių linija, kurios dabartinė versija šio teksto rašymo metu yra Grok 4.7, sulaukusi kelių naujų leidimų po tos versijos, kuri iš pradžių buvo lyginama šiame straipsnyje, ir prie platformos buvo prijungta atskirai. Nė vienas modelis nebuvo sukurtas specialiai vertimui. Abi yra bendrosios paskirties sistemos, kurios tiesiog geba apdoroti daug kalbų kaip dalį savo platesnių kalbinių galimybių, o tai yra kitoks pradinis taškas nei platformos, kuri sukurta ir testuojama orientuojantis būtent į vertimo kokybę.
Kaip Qwen ir Grok pasirodo lyginant pagal pačios MachineTranslation.com duomenis?
Per paskutines 28 platformos srauto dienas Grok vidutiniškai surinko daugiau balų nei Qwen: 9.26 iš 10 palyginti su 8.87. Grok 10 % prasčiausiai įvertintų vertimų vidurkis vis tiek buvo 9.2, tuo tarpu Qwen 10 % prasčiausiai įvertintų vertimų nukrito iki 7.6, kas rodo didesnį atotrūkį žemiausiame lygmenyje nei leidžia manyti vien vidurkis.
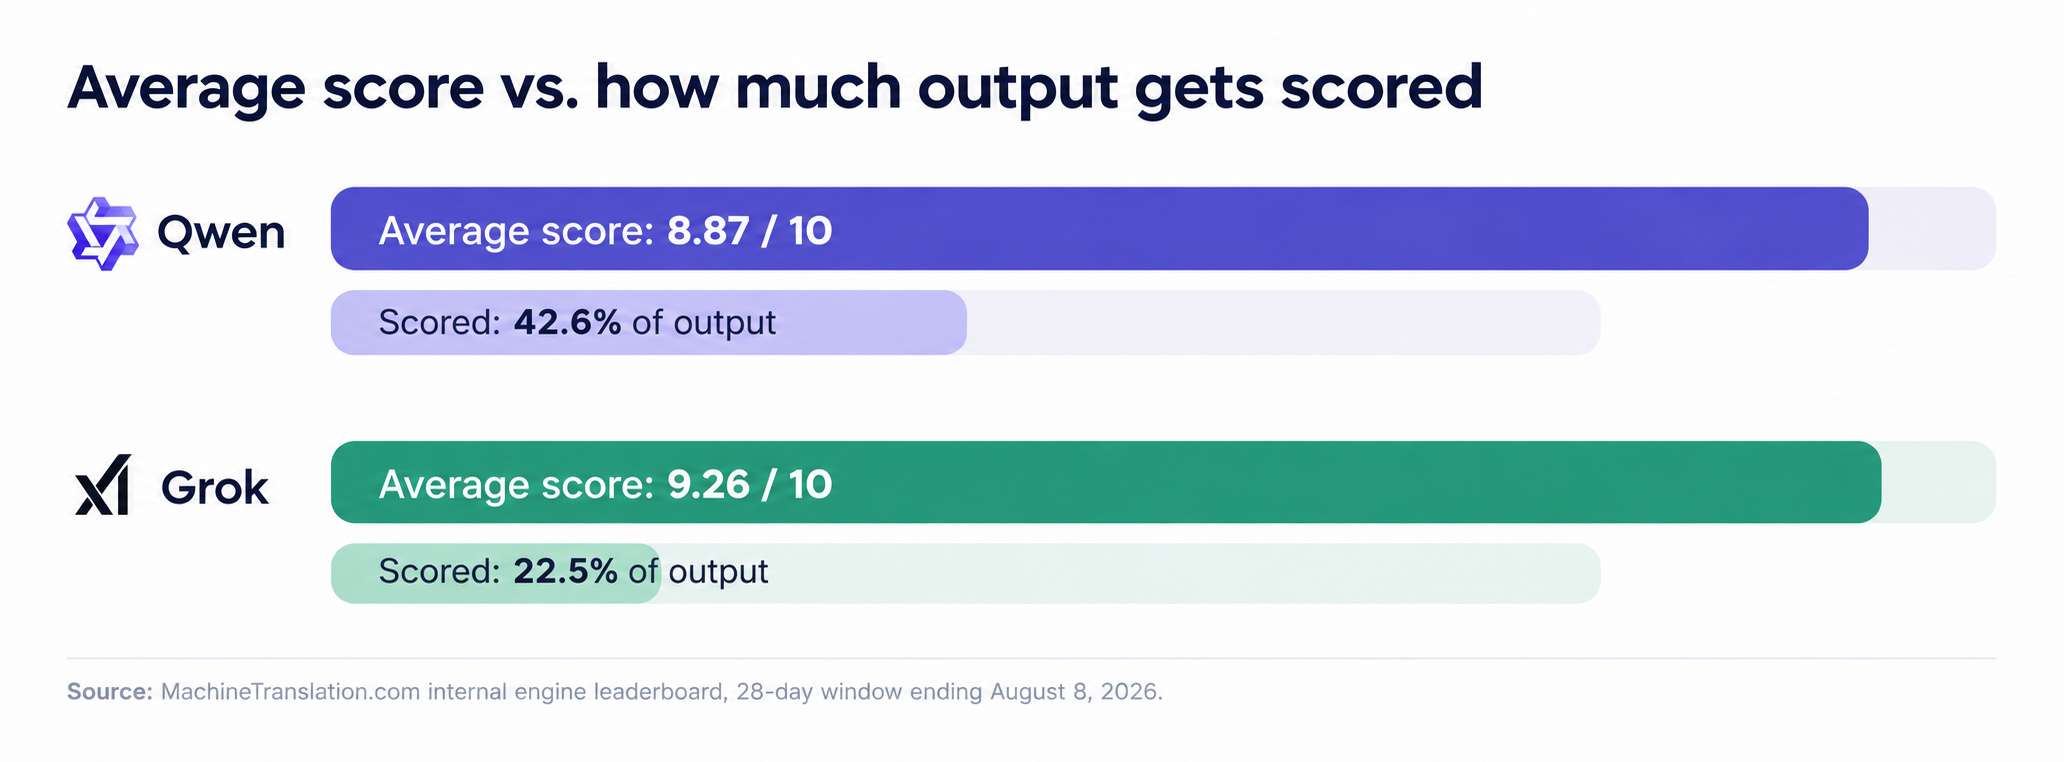
Grok vidutinis balas yra didesnis, tačiau jis remiasi mažiau nei ketvirtadalio jo pateikiamų rezultatų vertinimu, palyginti su beveik puse Qwen atveju. Šie du stulpeliai pasakoja skirtingas tos pačios istorijos dalis.
| Qwen | Grok | |
|---|---|---|
| Įvertintų rezultatų procentas | 42.6% | 22.5% |
| Vidutinis balas | 8.87 / 10 | 9.26 / 10 |
| Prasčiausi 10 % įvertinimų | 7.6 | 9.2 |
Šaltinis: MachineTranslation.com vidinė variklių lyderių lentelė, 28 dienų laikotarpis, pasibaigęs 2026 m. rugpjūčio 8 d.
Ar aukštesnis Grok įvertinimas reiškia, kad tai geresnis pasirinkimas?
Pats savaime – ne. Grok platformoje naudojamas kur kas rečiau nei Qwen, ir įvertinama mažiau nei ketvirtadalis jo vertimų, lyginant su beveik puse Qwen vertimų. Dėl mažesnės, mažiau reprezentatyvios imties vidurkis gali atrodyti geresnis arba blogesnis nei lyginant su tokia pačia apimtimi, kokią apdoroja Qwen. Pačios MachineTranslation.com ataskaitose apie šiuos duomenis įvertinimų aprėptis laikoma realiu apribojimu, o ne nereikšminga pastaba: variklis, kurio įvertinta tik siaura srauto dalis, nėra taip išsamiai išbandytas kaip tas, kurio įvertinta beveik pusė sugeneruoto turinio.
Objektyviai vertinant, Grok skaičiai teikia vilčių, tačiau yra pagrįsti mažesne imtimi. Qwen vidurkiai yra žemesni, tačiau remiasi kur kas didesne ir reprezentatyvesne baze. Nė vienas faktas nepaneigia kito.
Kaip dėl kalbų aprėpties?
Nė vienas iš modelių, nei Qwen, nei Grok, neskelbia patvirtinto kalbų porų sąrašo, kuriose našumas sumažėja, ir nėra jokio nepriklausomo testavimo, kuris tai patvirtintų. Ką galima užtikrintai pasakyti, tai, kad nė vienas modelis nebuvo kuriamas specialiai vertimo kokybei konkrečiame kalbų rinkinyje užtikrinti, kaip tai daroma specializuotose vertimo platformose. MachineTranslation.com tiesiogiai testuoja ir palaiko daugiau nei 270 kalbų, o tai yra visiškai kitokio lygio pareiškimas nei bendrosios paskirties modelio plačios, bet neišbandytos daugiakalbystės galimybės.
Kaip MachineTranslation.com iš tikrųjų naudoja Qwen ir Grok
Kiekvienam vertimui MachineTranslation.com naudoja Qwen, Grok ir daugiau nei 20 kitų dirbtinio intelekto modelių, o tada pateikia versiją, dėl kurios šie modeliai labiausiai sutampa. Nė vienas modelis nėra atmetamas dėl to, kad jo įvertinimo vidurkis yra žemesnis. Kelių modelių naudojimas vienu metu leidžia užfiksuoti atvejus, kai žemesnį vidurkį turintis modelis vis tiek teisingai išverčia konkretų sakinį, kurį aukštesnį įvertinimą turintis modelis suklysta. Qwen našumas taip pat priklauso nuo vertimo krypties ir kalbų poros – tai verta žinoti prieš pasirenkant vieną konkretų modelį, kaip išsamiau aprašyta MachineTranslation.com Qwen ir DeepSeek palyginime. Norėdami išsamiau susipažinti, kaip modeliai tiesiogiai testuojami vienas su kitu, peržiūrėkite MachineTranslation.com visą modelių palyginimo testavimą.
Dažniausiai užduodami klausimai
1. Qwen ar Grok yra geresnis vertimams?
Remiantis paties MachineTranslation.com 28 dienų variklių duomenimis, Grok vidutiniškai surenka daugiau balų nei Qwen, 9.26 palyginti su 8.87 iš 10. Tačiau Grok vertinamas pagal daug mažesnę, mažiau reprezentatyvią savo išvesties dalį, todėl tai nėra tikslus tiesioginis palyginimas, koks būtų testuojant tuos pačius segmentus.
2. Kodėl Grok vidutinis įvertinimas yra aukštesnis, bet įvertintų vertimų skaičius mažesnis?
Grok platformoje naudojamas rečiau ir tik apie 22.5% jo išvesties yra vertinama, palyginti su 42.6% Qwen atveju. Mažesnė, mažiau reprezentatyvi imtis gali padidinti arba sumažinti vidurkį, todėl šį palyginimą reikėtų suprasti kaip orientacinį, o ne galutinį.
3. Ar Qwen, ar Grok palaiko daugiau kalbų?
Abu yra bendrosios paskirties AI modeliai be paskelbto, patvirtinto specifinių kalbų apribojimų sąrašo. Nė vienas iš jų nėra sukurtas specialiai vertimui, o tai skiriasi nuo platformos, kuri tiesiogiai testuoja ir vertina vertimo kokybę 270+ kalbų, užuot kliaujantis plačiu daugiakalbiu apmokymu kaip išmatuoto vertimo našumo pakaitalu.
4. Ar MachineTranslation.com konkuruoja su Qwen ir Grok?
Ne. MachineTranslation.com kiekvienam vertimui naudoja Qwen, Grok ir daugiau nei 20 kitų AI modelių bei pateikia tą versiją, dėl kurios šie modeliai labiausiai sutaria. Ji testuoja ir sujungia tokius modelius, užuot konkuravusi su jais kaip atskiras, nuosavas modelis.
5. Kurį AI modelį MachineTranslation.com rekomenduoja vertimui?
Numatytuoju atveju – jokio. Skirtingi modeliai veikia skirtingai priklausomai nuo kalbų poros ir turinio tipo, o atotrūkis tarp jų gali pakrypti į bet kurią pusę, priklausomai nuo to, kas verčiama. Būtent dėl šios variacijos platforma kiekvienam vertimui naudoja kelis modelius, užuot pasirinkusi vieną kaip nuolatinę rekomendaciją.