October 2, 2026
Qwen pret Grok: kurš AI modelis tulko labāk?
Qwen un Grok ir vispārīga lietojuma AI modeļi, nevis īpaši tulkošanai paredzēti rīki, un abi ir daļa no modeļu kopas, ko MachineTranslation.com izmanto katrā tulkojumā. Tas ir būtiski, lai pareizi uztvertu turpmāko. Šis ir ieskats par to, kā divi pašas platformas modeļi darbojas viens pret otru, ņemot vērā reālās atrunas, kas saistītas ar šāda veida datiem, nevis sacensība starp diviem ārējiem konkurentiem un pašu platformu.
Kas ir Qwen un Grok?
Qwen ir Alibaba lielo valodu modeļu saime, kas pašlaik atrodas Qwen3.8 paaudzē un tika pievienota MachineTranslation.com modeļu kopai platformas nepārtrauktās paplašināšanās ietvaros. Grok ir xAI modeļu līnija, kuras aktuālā versija šī raksta tapšanas brīdī ir Grok 4.7; tā ir piedzīvojusi vairākus laidienus kopš versijas, kas sākotnēji tika salīdzināta šajā rakstā, un platformai tika pievienota atsevišķi. Neviens no šiem modeļiem netika radīts īpaši tulkošanai. Abas ir vispārīga lietojuma sistēmas, kas spēj apstrādāt daudzas valodas kā daļu no plašākām valodu spējām, kas ir atšķirīgs sākumpunkts salīdzinājumā ar platformu, kura veidota un testēta, īpaši koncentrējoties uz tulkošanas kvalitāti.
Kā Qwen un Grok ir salīdzināmi MachineTranslation.com pašu datos?
Pēdējo 28 platformas datplūsmas dienu laikā Grok ieguva vidēji augstāku vērtējumu nekā Qwen: 9.26 no 10 pret 8.87. Grok 10% sliktāk novērtēto tulkojumu vidējais rādītājs joprojām bija 9.2, kamēr Qwen sliktākie 10% nokritās līdz 7.6, kas ir lielāka atšķirība apakšējā robežā, nekā varētu secināt tikai no vidējā rādītāja.
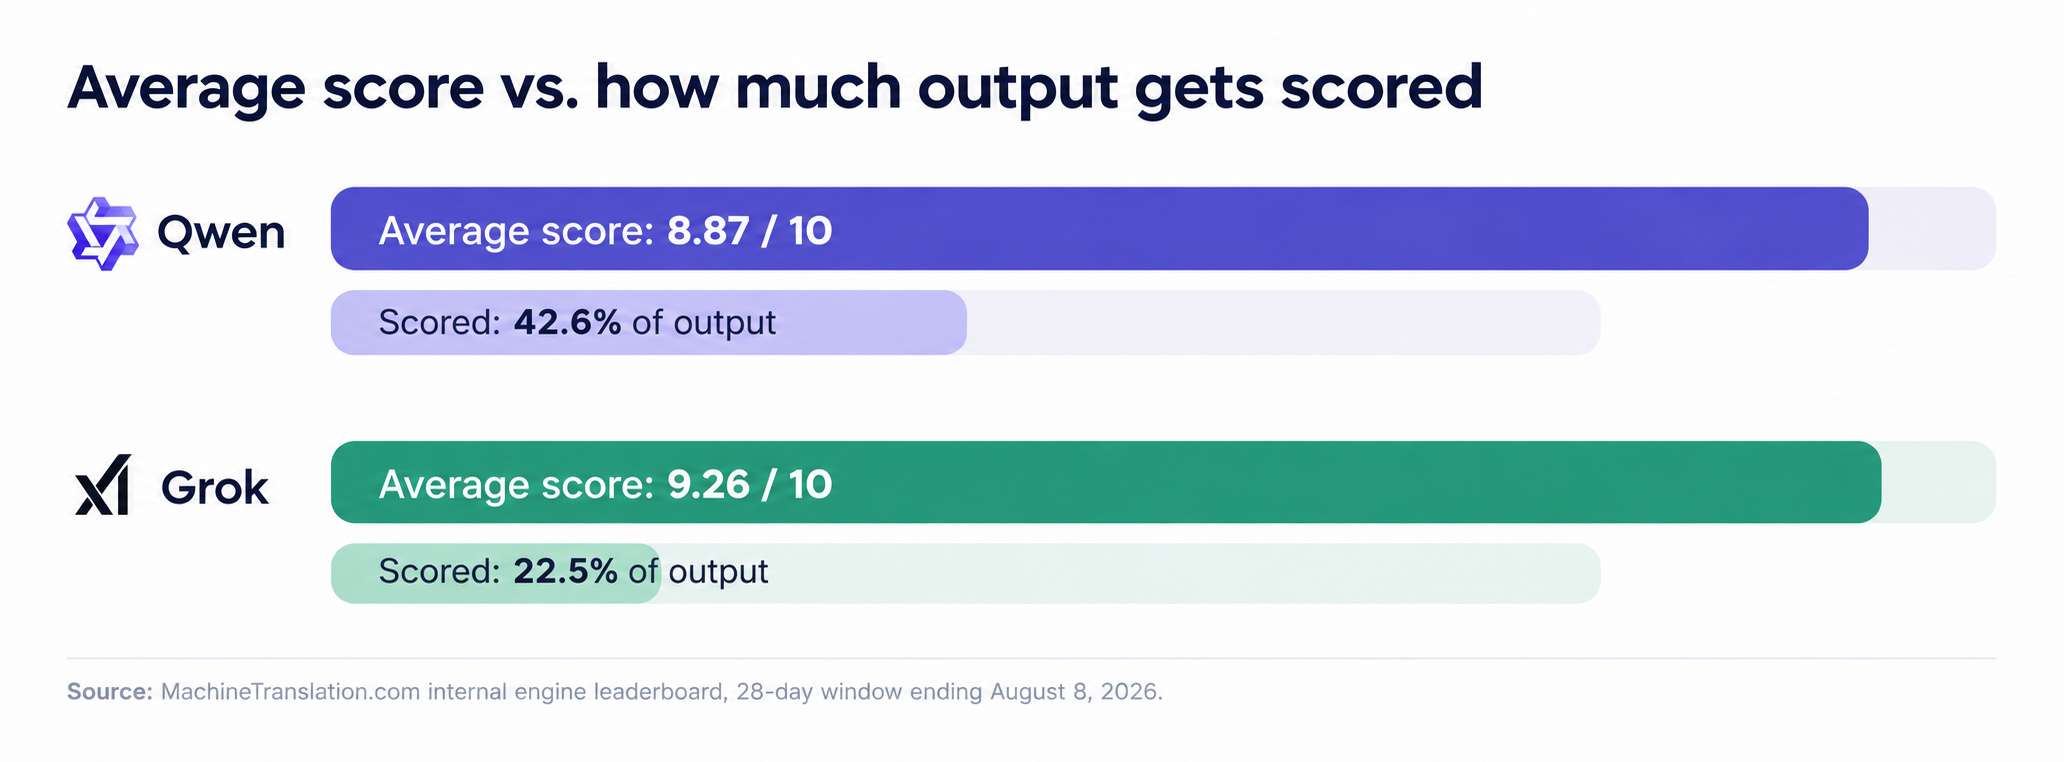
Grok vidējais vērtējums ir augstāks, taču tas balstās uz to, ka novērtēta ir mazāk nekā ceturtā daļa no tā izvades, salīdzinot ar gandrīz pusi Qwen gadījumā. Abas joslas atspoguļo atšķirīgas viena un tā paša stāsta daļas.
| Qwen | Grok | |
|---|---|---|
| Novērtētās izvades procentuālā daļa | 42.6% | 22.5% |
| Vidējais vērtējums | 8.87 / 10 | 9.26 / 10 |
| Zemākie 10% vērtējumu | 7.6 | 9.2 |
Avots: MachineTranslation.com iekšējais dzinēju līderu saraksts, 28 dienu periods, kas beidzas 2026. gada 8. augustā.
Vai Grok augstākais vērtējums nozīmē, ka tā ir labākā izvēle?
Pats par sevi nē. Grok platformā tiek izmantots daudz retāk nekā Qwen, un mazāk nekā ceturtdaļa no tā tulkojumiem vispār tiek novērtēti, salīdzinot ar gandrīz pusi no Qwen tulkojumiem. Mazāka, mazāk reprezentatīva izlase var padarīt vidējo rādītāju šķietami labāku vai sliktāku, nekā tas būtu pie tāda paša apjoma, kādu apstrādā Qwen. MachineTranslation.com pašu sagatavotie ziņojumi par šiem datiem vērtēšanas pārklājumu uztver kā reālu ierobežojumu, nevis zemsvītras piezīmi: dzinējs, kas novērtēts šaurā tās datplūsmas daļā, nav pārbaudīts tik rūpīgi kā tas, kas novērtēts gandrīz pusē no tā veikto tulkojumu apjoma.
Godīgs secinājums ir tāds, ka Grok rādītāji ir daudzsološi, bet ar mazāku datu apjomu. Qwen rādītāji vidēji ir zemāki, taču tie balstās uz daudz lielāku, reprezentatīvāku bāzi. Neviens no šiem faktiem neizslēdz otru.
Kā ir ar valodu pārklājumu?
Ne Qwen, ne Grok nepublicē verificētu valodu pāru sarakstu, kuros veiktspēja samazinās, un nepastāv neatkarīgas testēšanas, kas to apstiprinātu. Ar pārliecību var teikt, ka neviens no modeļiem netika veidots, par pamatu ņemot tulkošanas kvalitāti noteiktā valodu kopā tā, kā to dara specializēta tulkošanas platforma. MachineTranslation.com tieši testē un atbalsta vairāk nekā 270 valodu, kas ir cita veida apgalvojums nekā vispārīga lietojuma modeļa plašā, bet nepārbaudītā daudzvalodu spēja.
Kā MachineTranslation.com reāli izmanto Qwen un Grok
MachineTranslation.com katram tulkojumam izmanto Qwen, Grok un vairāk nekā 20 citus mākslīgā intelekta modeļus, un pēc tam piedāvā versiju, par kuru šie modeļi visvairāk vienojas. Neviens modelis netiek izslēgts tikai tāpēc, ka tam ir zemāks vidējais vērtējums. Daudzu modeļu vienlaicīga izmantošana ļauj uztvert gadījumus, kad modelis, kuram vidēji ir zemāks vērtējums, joprojām pareizi iztulko konkrētu teikumu, kurā modelis ar augstāku vērtējumu kļūdās. Qwen veiktspēja arī atšķiras atkarībā no tulkošanas virziena un valodu pāra tādos veidos, kurus ir vērts zināt pirms viena modeļa izvēles, un tas ir sīkāk apskatīts MachineTranslation.com Qwen un DeepSeek salīdzinājumā. Lai tuvāk aplūkotu, kā modeļi tiek testēti tieši viens pret otru, skatiet MachineTranslation.com pilno modeļu salīdzināšanas testēšanu.
Bieži uzdotie jautājumi
1. Vai tulkošanai labāks ir Qwen vai Grok?
Saskaņā ar MachineTranslation.com pašu 28 dienu dzinēju datiem, Grok vidējais vērtējums ir augstāks nekā Qwen, 9.26 pret 8.87 no 10. Taču Grok tiek vērtēts pēc daudz mazākas, mazāk reprezentatīvas izvades daļas, tāpēc šis nav tīrs tiešais salīdzinājums, kāds tas būtu saskaņotu segmentu testā.
2. Kāpēc Grok ir augstāks vidējais vērtējums, bet mazāk novērtētu tulkojumu?
Grok platformā tiek izmantots retāk, un tikai aptuveni 22.5% no tā izvades tiek novērtēti, salīdzinot ar 42.6% Qwen. Mazāka, mazāk reprezentatīva izlase var paaugstināt vai pazemināt vidējo rādītāju, tāpēc šis salīdzinājums ir jāuztver kā orientējošs, nevis galīgs.
3. Vai vairāk valodu atbalsta Qwen vai Grok?
Abi ir vispārīga lietojuma mākslīgā intelekta modeļi bez publicēta un verificēta valodu specifisko ierobežojumu saraksta. Neviens no tiem nav izstrādāts īpaši tulkošanai, kas atšķir tos no platformas, kura tieši testē un vērtē tulkojumu kvalitāti vairāk nekā 270 valodās, nevis paļaujas uz plašu daudzvalodu apmācību kā aizstājēju reāli izmērītai tulkošanas veiktspējai.
4. Vai MachineTranslation.com konkurē ar Qwen un Grok?
Nē. MachineTranslation.com katram tulkojumam izmanto Qwen, Grok un vairāk nekā 20 citus mākslīgā intelekta modeļus un piedāvā to versiju, par kuru šie modeļi ir visvairāk vienisprātis. Tā vietā, lai konkurētu ar tiem kā atsevišķs modelis, platforma šādus modeļus testē un apvieno.
5. Kuru mākslīgā intelekta modeli MachineTranslation.com iesaka tulkošanai?
Pēc noklusējuma — nevienu. Dažādu modeļu veiktspēja atšķiras atkarībā no valodu pāra un satura veida, un atšķirība starp tiem var nosliekties jebkurā virzienā atkarībā no tā, kas tiek tulkots. Šīs atšķirības ir tieši tas iemesls, kāpēc platforma katram tulkojumam izmanto vairākus modeļus, nevis izvēlas vienu kā pastāvīgu ieteikumu.