September 25, 2026
Fra GPT-3 til GPT-5: Hvordan kvaliteten på AI-oversettelse faktisk endret seg
GPT-3, GPT-4 og GPT-5 skiller seg med fem år og flere arkitektur-generasjoner, men det mest nyttige spørsmålet for oversettelse er ikke «hvilken som er smartest». Det er mer spesifikt: Hva har egentlig endret seg i hvordan disse modellene håndterer de delene av et språk som ikke kan oversettes ord for ord – som faste uttrykk, tvetydighet og stilnivå? Forbedringen skjedde på bestemte områder, på bestemte tidspunkter, og utviklingen gikk ikke i en rett linje fra eldre til nyere.
Hva GPT-3 faktisk bød på for oversettelse
OpenAI lanserte GPT-3 i 2020, før MachineTranslation.coms eget testprogram fantes, så ingenting her er en proprietær ytelsestest. Dette er veldokumentert historie, ikke et internt testresultat. GPT-3 var den første modellen av sitt slag som var i stand til å produsere flytende, menneskelignende tekst på flere språk uten oppgavespesifikk opplæring, noe som gjorde den til en reell milepæl. For oversettelse skapte imidlertid den samme flyten en reell risiko: GPT-3 kunne generere en selvsikker, velskrevet setning på målspråket som likevel var feil, uten at noe i teksten avslørte at det hadde skjedd en feil.
Hva som endret seg da GPT-4 kom
GPT-4 ble lansert i mars 2023, og MachineTranslation.coms egen modelltesting starter rundt denne generasjonen. Forbedringen var reell, men ujevn. Da det tvetydige engelske uttrykket «That's sick» ble testet til japansk, var GPT-4.1-nano den eneste av seks testede modeller som reduserte setningens bevisste dobbeltbetydning til én enkelt tolkning, mens de fem andre bevarte tvetydigheten som den opprinnelige frasen la opp til. Idiomer var en større svakhet: Da det spanske uttrykket «llevarse el gato al agua» ble kjørt gjennom fem GPT-versjoner samtidig, leverte både de mindre modellene GPT-4o-mini og GPT-4.1-nano den samme bokstavelige, feilaktige oversettelsen, og bommet fullstendig på idiomet.
Det samme mønsteret viste seg andre steder. Det tyske idiomet «ich verstehe nur Bahnhof», testet på tvers av åtte underversjoner av GPT og Claude, ble oversatt bokstavelig og feilaktig spesifikt av GPT-4o-mini, mens en mindre og nyere modell i samme test, GPT-4.1-nano, oversatte det riktig. Generasjon og modellstørrelse hang ikke sammen på noen konsekvent måte, et mønster som MachineTranslation.coms modellversjonstesting belyser mer inngående.
Hva GPT-5 endret for oversettelse
OpenAI introduserte GPT-5 som et enhetlig system som ruter mellom en rask standardmodell og en dypere resonneringsmodell avhengig av oppgaven, en strukturell endring fra GPT-4s design med én enkelt modell. OpenAIs eget GPT-5 System Card rapporterer at modellens samlede faktiske feilrate er omtrent 45 % lavere enn for GPT-4 og 80 % lavere enn for GPT-3 – en generell forbedring i pålitelighet som også viser seg spesifikt innen oversettelse. MachineTranslation.coms testing viser de klareste forbedringene der GPT-4-generasjonens modeller slet mest: På det samme spanske idiomet som GPT-4o-mini og GPT-4.1-nano mislyktes med, leverte både GPT-5.4-mini og GPT-5.4 korrekte, idiomatiske oversettelser – med litt ulik ordlyd, men begge forsto selve idiomet.
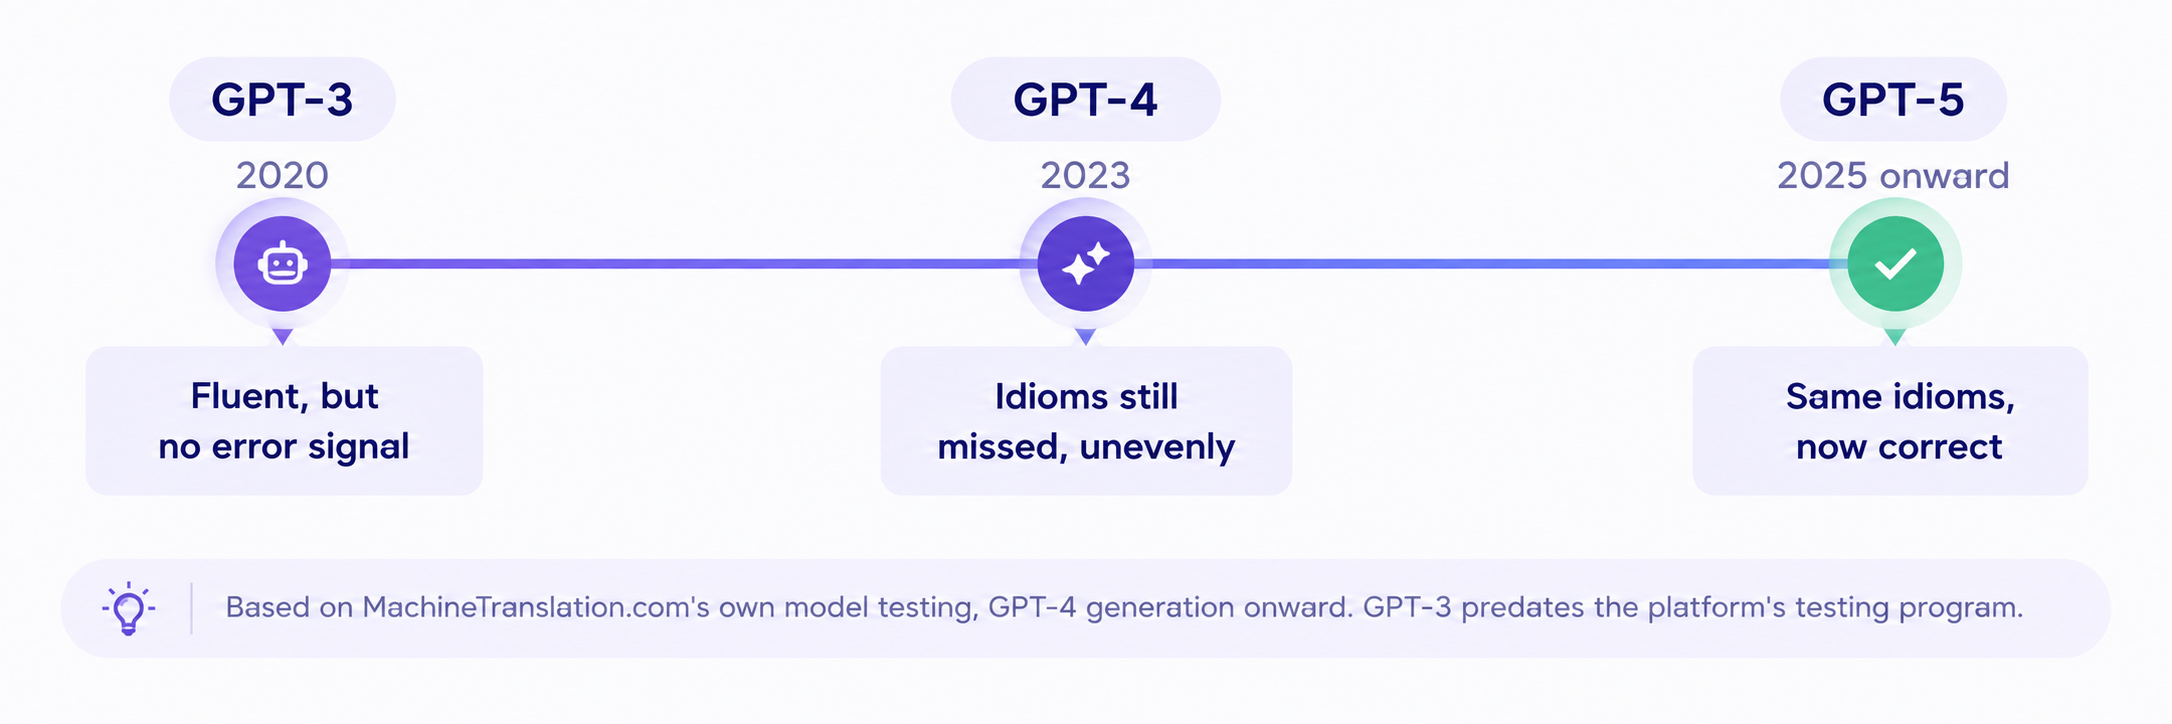
Forskjellen mellom generasjonene var ikke en jevn stigning. Den var nesten utelukkende konsentrert rundt idiomatisk og tvetydig språk. På enkel og rett frem tekst oppnår modeller fra GPT-4- og GPT-5-æraen tilnærmet identiske resultater.
| GPT-3 | GPT-4 | GPT-5 | |
|---|---|---|---|
| Lansert | 2020 | Mars 2023 | 2025, nå på GPT-5.4/5.5 |
| Tilgjengelig i dag | Nei, avviklet | Kun API, avviklet fra ChatGPT | Ja, nåværende generasjon |
| Håndtering av idiomer | Ikke testet av MachineTranslation.com (før programmets oppstart) | Ujevn; bommet helt på flere idiomer | Håndterte de samme idiomene som GPT-4 bommet på, korrekt |
| Standard forretningstekst | Ikke testet av MachineTranslation.com | Sterk, nesten identisk med senere modeller | Sterk, nesten identisk med GPT-4 |
Det siste poenget er viktig: En separat test av en standard forretningsfrase, «please confirm receipt of this document», oversatt til tysk, ga et tilnærmet identisk resultat på tvers av alle testede modeller, inkludert GPT-4o-mini og GPT-5-generasjonsmodeller. Generasjonsgapet er spesifikt knyttet til figurativt og tvetydig språk, og er ikke en generell kvalitetsforskjell over hele linjen.
Betyr en nyere GPT-generasjon alltid bedre oversettelse?
Nei. Da vi testet et hebraisk idiom på tvers av modellfamilier, landet GPT-5.4-mini og GPT-5.4 på to ulike, delvise tolkninger av den samme frasen, og ingen av dem var helt korrekte, mens en eldre, ubeslektet modell kom nærmere. En nyere modell er ikke automatisk mer presis, og en større eller nyere modell er ikke automatisk det tryggere valget for en gitt setning.
Hvor GPT-5 står innen oversettelse i dag
GPT-3 og GPT-4 er begge faset ut fra ChatGPT; GPT-4 er kun tilgjengelig via OpenAIs API for eksisterende integrasjoner. Den nåværende generasjonen, GPT-5.4 og GPT-5.5, er det MachineTranslation.com kjører i dag, og den yter konkurransedyktig mot nåværende modeller fra andre leverandører, selv om den ikke er ensartet bedre på alle språkpar. For en nærmere titt på hvordan nåværende GPT-underversjoner sammenlignes med hverandre og med modeller som Claude og DeepSeek, se MachineTranslation.coms direkte sammenligningstester av underversjoner, som går dypere enn en generasjonsoversikt kan gjøre.
Hva dette betyr hvis du lokaliserer i stor skala
Funnene som betyr mest for et stort lokaliseringsprogram er ikke at «GPT-5 slår GPT-3». Det er at modellversjonen, ikke bare modellfamilien, avgjør om et spesifikt idiom eller en tvetydig frase blir oversatt riktig, og det gjelder for alle språkpar, ikke bare de få som vises her. Dette har størst betydning for innhold som i utgangspunktet lener seg på tone og billedlig språk, spesielt markedsføringstekster og brukergenerert innhold, der et enkelt idiom oversatt bokstavelig kan endre hele meningen med et innlegg eller en annonse. Et program som oversetter innhold til dusinvis av språk, vil støte på akkurat denne typen språk i alle sammen. MachineTranslation.coms testserie for underversjoner og omfattende modelltester dekker dette mer inngående. Plattformens tilnærming – å kjøre nåværende GPT-modeller parallelt med mer enn 20 andre på hver oversettelse – eksisterer nettopp fordi ingen enkeltmodells versjonshistorikk alene er en pålitelig nok garanti.
Ofte stilte spørsmål
1. Hva er den reelle forskjellen mellom GPT-3, GPT-4 og GPT-5 når det gjelder oversettelse?
GPT-3 håndterte enkel tekst rimelig godt, men slet kraftig med alt som var idiomatisk eller tvetydig. GPT-4 reduserte det gapet betraktelig, men reduserte likevel enkelte genuint tvetydige fraser til én enkelt betydning i stedet for å bevare tvetydigheten. Senere underversjoner av GPT-5 håndterte idiomer riktig der tidligere modeller fra GPT-4-æraen oversatte bokstavelig og feil.
2. Er GPT-5 alltid bedre enn GPT-4 til oversettelse?
Nei. MachineTranslation.coms egne tester har avdekket tilfeller der en mindre og nyere underversjon presterte bedre enn en større og eldre, og kvalitetsforskjellen mellom generasjonene har en tendens til å gjelde spesifikt for idiomatisk eller billedlig språk, snarere enn en generell forbedring over hele linjen.
3. Tilbyr OpenAI fortsatt GPT-3 eller GPT-4?
Nei. Begge er faset ut fra ChatGPT og erstattet av nyere GPT-5-generasjonsmodeller. GPT-4 forblir kun tilgjengelig via OpenAIs API for eksisterende integrasjoner, ikke som et forbrukervendt alternativ i dag.
4. Hvilken GPT-versjon bruker MachineTranslation.com?
MachineTranslation.com kjører nåværende modeller fra GPT-5-generasjonen (GPT-5.4 og GPT-5.5, avhengig av abonnementsnivå) sammen med mer enn 20 andre AI-modeller på hver oversettelse, i stedet for å basere seg på GPT alene.
5. Hvordan står GPT-5 seg mot andre nåværende AI-modeller for oversettelse?
Modeller fra GPT-5-generasjonen presterer konkurransedyktig, men ikke gjennomgående bedre enn modeller som Claude, Gemini eller DeepSeek. Ulike modeller vinner på ulike språkpar og innholdstyper, og det er grunnen til at MachineTranslation.com tester dem direkte mot hverandre i stedet for å velge én som standard.