November 13, 2026
Qwen vs Gemini for oversettelse og hvorfor retning betyr noe
Du har to modeller og en liste over språkpar, og du må bestemme deg for hvilken modell du skal betro prosjektet. De fleste sammenligninger mellom Qwen og Gemini svarer med én samlet poengsum. Jeg mener at én poengsum skjuler det som avgjør utfallet, nemlig oversettelsesretningen.
Jeg jobber med hvordan vi tester modellene som kjører på MachineTranslation.com, så jeg kan sammenligne Qwen og Gemini på 98 språkpar vurdert på identisk tekst. Gemini fikk høyere poengsum i 68 av disse parene og Qwen i 29, og den gjennomsnittlige forskjellen er 0,08 poeng av 10. Totalene alene forteller deg ikke hvilken modell du bør velge for urdu til engelsk eller for engelsk til haitisk kreol.
Denne artikkelen viser hvor de to modellene ligger tett opptil hverandre og hvor hver av dem leder. Den forteller også hva jeg ikke kan si deg ennå. Datagrunnlaget mitt slutter August 8, 2026, før Google kunngjorde Gemini 4 i oktober, så det beskriver de tidligere versjonene av begge modellene.
Hovedpunkter
- På tvers av 98 språkpar vurdert på identisk tekst (July 12 to August 8, 2026), fikk Gemini høyere poengsum i 68 par, Qwen i 29, og ett par endte likt.
- Den gjennomsnittlige forskjellen er liten, 9,06 for Gemini mot 8,98 for Qwen, og 60 av de 98 parene ligger innenfor 0,1 poeng.
- Ved oversettelse til engelsk leder Qwen med mer enn 0,1 poeng i 7 av 27 par og Gemini i 3; de andre 17 er innenfor 0,1 poeng.
- Ved oversettelse fra engelsk leder Gemini med mer enn 0,1 poeng i 13 av 29 par og Qwen i ingen.
- Dataene slutter før Google kunngjorde Gemini 4 i October 2026, så de beskriver de tidligere versjonene av Gemini og trenger en ny gjennomgang før noen behandler dem som oppdaterte.
Er Qwen eller Gemini best til oversettelse?
Det avhenger av retningen, ettersom de to modellene ligger tett når målspråket er engelsk og Gemini får høyere poengsum i de fleste andre par. På tvers av alle 98 par fikk Gemini høyere poengsum i 68. I resultatene fra MachineTranslation.com fra July 12 to August 8, 2026, hadde Gemini et gjennomsnitt på 9,06 av 10 og Qwen 8,98, en gjennomsnittlig forskjell på 0,08 poeng.
Panelet teller bare segmenter der ChatGPT, Claude, DeepSeek, Gemini og Qwen alle mottok en reell poengsum, slik at hver modell blir vurdert på identisk kildetekst. Hvert språkpar har minst 30 segmenter. Jeg bruker dette panelet fordi det fjerner en vanlig feil, nemlig å sammenligne modeller på ulik tekst.
I antall leder Gemini i 68 par (69%), Qwen i 29 (30%), og ett par står likt. Antall alene overdriver forskjellen, fordi 60 av de 98 parene er innenfor 0,1 poeng. De neste avsnittene deler resultatene etter retning og etter margin.
Hvilke oversettelsesretninger favoriserer hver modell?
Gemini leder når engelsk er kildespråket eller når ingen av språkene er engelsk, og Qwen er på samme nivå eller foran når engelsk er målspråket. Fra engelsk leder Gemini med mer enn 0,1 poeng i 13 av 29 par og Qwen i ingen. Til engelsk leder Qwen med den marginen i 7 av 27 par og Gemini i 3.
| Retning | Par | Gemini foran med mer enn 0,1 | Innenfor 0,1 poeng | Qwen foran med mer enn 0,1 | Gjennomsnittlig differanse |
|---|---|---|---|---|---|
| Til engelsk | 27 | 3 | 17 | 7 | Qwen +0,04 |
| Fra engelsk | 29 | 13 | 16 | 0 | Gemini +0,16 |
| Ingen av sidene engelsk | 42 | 14 | 27 | 1 | Gemini +0,13 |
Til engelsk er 17 av 27 par innenfor 0,1 poeng, Qwen leder i 7, og Gemini leder i 3. Fra engelsk er 16 av 29 par innenfor 0,1 poeng, Gemini leder i 13, og Qwen leder i ingen. Der ingen av språkene er engelsk, er 27 av 42 innenfor 0,1 poeng, Gemini leder i 14, og Qwen leder i 1.
Qwen er innenfor 0,1 poeng fra Gemini eller foran i 24 av de 27 parene til engelsk. Gjennomsnittlig etter retning ligger Qwen foran med omtrent 0,04 poeng til engelsk, mens Gemini ligger foran med omtrent 0,16 poeng fra engelsk og 0,13 poeng mellom to ikke-engelske språk.
Jeg vet ikke hvorfor dette skillet oppstår, og disse dataene kan ikke gi svar på det. Én forklaring jeg ville testet først, er sammensetningen av treningsdata bak hver modell, men jeg har ikke utført den testen. Qwen viser et lignende mønster mot ChatGPT. På det samme utvalget viste vår sammenligning mellom Qwen og ChatGPT at de to var tilnærmet jevne til engelsk, mens ChatGPT ledet i 89 % av de andre parene.
Hvilke språkpar viser de største forskjellene?
De største forskjellene er i Geminis favør. Den leder med 0,51 til 0,95 poeng på russisk til kasakhisk, engelsk til haitisk kreolsk, engelsk til tagalog, spansk til gresk og arabisk til persisk. Qwens største forsprang er mindre, mellom 0,15 og 0,26 poeng, og fire av de fem beste er par til engelsk.
| Språkpar | Gemini-score | Qwen-score | Differanse |
|---|---|---|---|
| Russisk til kasakhisk | 9,27 | 8,32 | Gemini +0,95 |
| Engelsk til haitisk kreol | 9,19 | 8,27 | Gemini +0,92 |
| Engelsk til tagalog | 9,14 | 8,43 | Gemini +0,70 |
| Spansk til gresk | 8,90 | 8,33 | Gemini +0,57 |
| Arabisk til persisk | 8,84 | 8,34 | Gemini +0,51 |
| Urdu til engelsk | 8,56 | 8,81 | Qwen +0,26 |
| Kinesisk til engelsk | 9,00 | 9,19 | Qwen +0,19 |
| Svensk til engelsk | 8,29 | 8,46 | Qwen +0,16 |
| Kinesisk til indonesisk | 9,03 | 9,19 | Qwen +0,16 |
| Burmesisk til engelsk | 8,94 | 9,09 | Qwen +0,15 |
Jeg ville ikke ansett disse som endelige rangeringer. De to største forskjellene, russisk til kasakhisk og engelsk til haitisk kreolsk, er basert på mindre utvalg enn medianparet. Engelsk til tagalog, spansk til gresk og arabisk til persisk er basert på større utvalg, så jeg ville stolt mer på de tre. Jeg ville testet de to forskjellene med små utvalg på nytt før jeg stolte på dem.
Hva betyr en forskjell på 0,1 poeng?
Etter mitt syn er en forskjell på under 0,1 poeng for liten til å kåre en vinner. Av de 98 parene faller 60 innenfor denne marginen, og hvert par blir vurdert ut fra et begrenset antall segmenter. Grensen på 0,1 er min egen arbeidsterskel, og jeg har ikke kjørt en signifikanstest på disse parene.
En poengsum fanger heller ikke opp alle forskjeller. I testene våre av vanlige fraser kjørte vi «sorry» på arabisk gjennom 22 AI-modeller. Både Gemini og Qwen valgte det uformelle آسف. ChatGPT og det kombinerte resultatet valgte det formelle عذرًا. Hver modell fikk en poengsum på 9,5, så de to ordene har ulikt stilnivå, og poengsummen endret seg ikke.
Det er derfor jeg ser marginen og eksemplene på stilnivå i sammenheng. En liten forskjell med en synlig forskjell i stilnivå krever en menneskelig beslutning. En stor forskjell på et tynt utvalg krever en ny test.
Gjør Qwen og Gemini ulike typer feil?
Ja, for i sitattesten vår for VM 2026 tok begge modellene minst ett valg som de andre modellene ikke gjorde, og poengsummene rikket seg knapt. Gemini oversatte en frase fra Mbappé som «with each game» og gjenga et sitat fra Wirtz ord for ord, mens Qwen ga en annen tolkning av et sitat fra Scaloni. Poengsummene for disse tilfellene lå mellom 9,2 og 9,5.
Detaljene stammer fra sitattesten vår for VM. På Mbappés sitat om å se fremover beholdt de andre modellene «match», mens Gemini skrev «with each game», en liten glipp i stilnivå som fikk en poengsum på 9,4. På et sitat fra Wirtz oversatte Gemini en frase ord for ord og endret meningen, også med 9,4. På Scalonis sitat samlet de fleste modellene seg om én tolkning, mens Qwen skrev «that is what matters» og fikk 9,4. På Mbappés taktiske sitat valgte Claude og DeepSeek britisk fotballengelsk, mens Gemini, Qwen og de andre valgte amerikansk engelsk, og Qwen fikk 9,2, lavere enn resten.
Jeg tolker dette som små vaner. Geminis eksempler handler om stilnivå og bokstavelige formuleringer. Qwens handler om hvilken tolkning av en ytring man skal velge. Fire eksempler er for få til å kalles et mønster, men de viser hva slags forskjeller en enkelt poengsum skjuler.
Hvilken Qwen-modell er best til oversettelse?
Jeg kan ikke si det ut fra dataene våre, fordi poengsummene til MachineTranslation.com behandler Qwen som én modell uten en versjonsangivelse. Alibabas Qwen3.8-familie nådde Hugging Face i august 2026, så det finnes nå flere versjoner, og poengsummene i denne artikkelen skiller ikke mellom dem.
Jeg skulle gjerne ha delt dette opp etter versjon, men det kan jeg ikke ennå. Tallet på plattformnivå kan være et gjennomsnitt av mer enn én Qwen-versjon som kjørte i dette tidsrommet. Hvis du velger mellom Qwen-versjoner for et prosjekt, ville jeg sammenlignet dem på et utvalg av din egen tekst.
Hva er noen alternativer til Gemini for oversettelse?
ChatGPT, Claude, DeepSeek, Qwen, Grok og Mistral AI kjører alle på MachineTranslation.com, og det rette alternativet avhenger av språkparet. I poengsummene våre fra 12. juli til 8. august 2026 ligger Qwen innenfor 0,1 poeng fra Gemini eller foran i 24 av 27 par til engelsk. Poengsummene våre for Mistral AI på fransk viser at gjennomsnittet for fransk til engelsk ligger 0,40 poeng over Geminis.
Hvis alternativet ditt er ChatGPT, varierer svaret også etter språkpar. I vår publiserte oversikt for spansk til engelsk vant Gemini 31 % av segmentene og ChatGPT vant 21 %. På fransk vinner ingen av modellene i begge retninger. Fordi valget endrer seg med paret, velger ikke MachineTranslation.com ett enkelt alternativ. Den kjører dem sammen.
Mitt forslag er å ta utgangspunkt i språkparet og retningen, og deretter se på hvilket alternativ som passer.
Hvordan viser MachineTranslation.com hvor Qwen og Gemini er uenige?
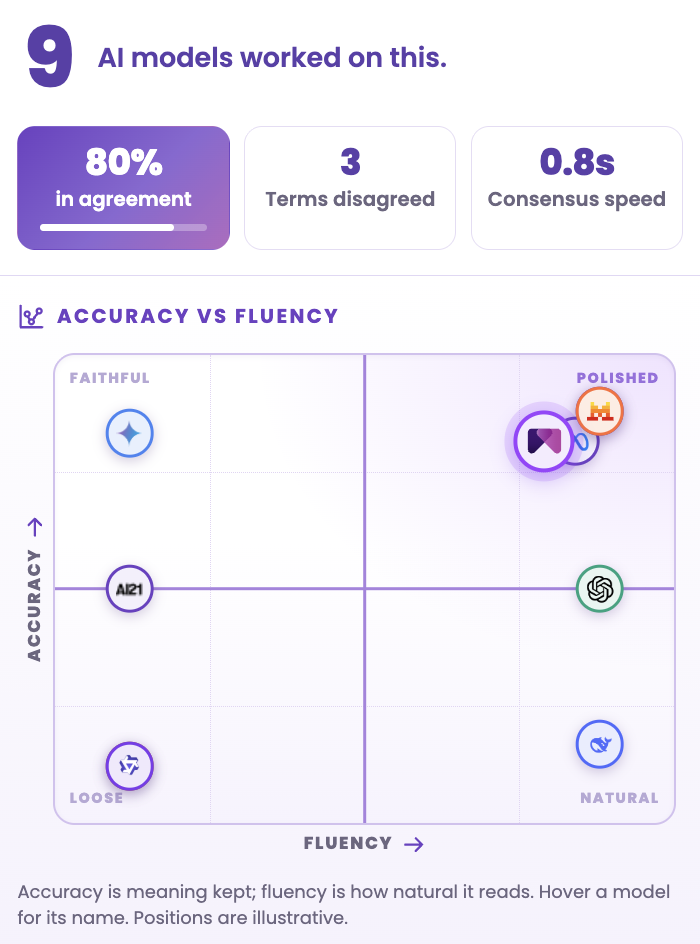
MachineTranslation.com kjører begge modellene på hver oversettelse og viser hvor modellene er enige og hvor de skiller lag. Enighetspanelet rapporterer hvor mange AI-modeller som arbeidet med teksten, andelen som var enige, hvor mange termer det var uenighet om, og hvor raskt konsensusen ble nådd.
Hvor oppdaterte er disse resultatene?
Disse resultatene dekker 12. juli til 8. august 2026, så de beskriver Gemini- og Qwen-versjonene som kjørte da. Google kunngjorde Gemini 4 i oktober 2026. Alibabas Qwen3.8-familie kom i august 2026. Min anbefaling er å kjøre panelet på nytt før du stoler på disse tallene for et nytt prosjekt.
Jeg forventer at metoden med å sammenligne identisk tekst med en feilmargin vil holde stand. Jeg forventer at størrelsen på forskjellene vil endre seg. Jeg ville behandlet ethvert par der lederen endrer seg ved en ny kjøring, som et tegn på at den tidligere forskjellen lå innenfor støyen.
Hvordan ville jeg valgt mellom Qwen og Gemini for et prosjekt?
Min vurdering er å velge ut fra par og retning, og å unngå å velge én gang for et helt prosjekt. I praksis betyr det å behandle en forskjell på under 0,1 poeng som uavgjort og å forvente at den ledende modellen endrer seg mellom parene. Dette er rekkefølgen jeg ville fulgt.
- List opp alle språkpar i prosjektet og merk retningen.
- Check the gap for each pair in this article. Treat a gap under 0,1 points as a tie.
- Where the gap is larger, start with the leading model and test a sample of your own text.
- If your content moves in both directions, expect the leader to change between pairs.
- Check again when either model releases a new version.
Both models run alongside 20 others on every translation in MachineTranslation.com. The version most of them agree on is returned, so the choice does not have to be made once for the whole project. The full set of model results is in our model comparison testing.
Frequently asked questions
1. Is Qwen or Gemini better for translation?
It depends on the direction, because Qwen is within 0,1 points of Gemini or ahead in 24 of 27 pairs into English. Gemini still scored higher in 68 of 98 pairs in MachineTranslation.com's July 12 to August 8, 2026 scores. The average gap is 0,08 points out of 10, so I would choose by pair.
2. Which Qwen model is best for translation?
I cannot say from our data, because MachineTranslation.com's scores treat Qwen as one model without a version tag. Alibaba's Qwen3.8 family reached Hugging Face in August 2026, so several versions now exist. Until the scores separate them, I would compare versions on a sample of your own text before choosing one for a project.
3. What are some alternatives to Gemini for translation?
ChatGPT, Claude, DeepSeek, Qwen, Grok, and Mistral AI all run on MachineTranslation.com. In our July 12 to August 8, 2026 scores, Qwen is within 0,1 points of Gemini or ahead in 24 of 27 pairs into English. Mistral AI's French to English average sat 0,40 points above Gemini's. The right alternative depends on the pair.
4. Is Gemini better than ChatGPT for translation?
It depends on the language pair, because no single AI model wins everywhere. In our published Spanish to English breakdown, Gemini won 31% of segments and ChatGPT won 21%. On French, neither model wins both directions. I would check the pair and the direction you need before choosing between them.
5. Is Gemini accurate for translation?
Ja, fordi Gemini hadde et gjennomsnitt på 9,06 av 10 på tvers av 98 språkpar i MachineTranslation.coms poengsummer fra July 12 to August 8, 2026. Nøyaktigheten varierer fortsatt etter par. Forspranget er størst fra engelsk, og Qwen ligger foran den med mer enn 0,1 poeng på 7 av 27 par til engelsk.