October 2, 2026
Qwen vs Grok: Hvilken AI-modell oversetter best?
Qwen og Grok er begge generelle AI-modeller, ikke oversettelsesspesifikke verktøy, og begge er en del av utvalget av modeller MachineTranslation.com kjører på hver oversettelse. Det har betydning for hvordan man skal lese det som følger. Dette er en titt på hvordan to av plattformens egne modeller presterer mot hverandre, med de reelle forbeholdene som følger med en slik type data, ikke en konkurranse mellom to eksterne utfordrere og selve plattformen.
Hva er Qwen og Grok?
Qwen er Alibabas familie av store språkmodeller, for øyeblikket i sin Qwen3.8-generasjon, og ble lagt til i MachineTranslation.coms modellutvalg som en del av plattformens pågående utvidelse. Grok er xAIs modellserie, for øyeblikket på Grok 4.7 i skrivende stund, etter å ha gått gjennom flere utgivelser siden versjonen denne artikkelen opprinnelig sammenlignet, og ble lagt til plattformen separat. Ingen av modellene ble bygget spesifikt for oversettelse. Begge er generelle systemer som tilfeldigvis håndterer mange språk som en del av en bredere språkkapasitet, noe som er et annet utgangspunkt enn en plattform bygget og testet spesifikt for oversettelseskvalitet.
Hvordan sammenlignes Qwen og Grok på MachineTranslation.coms egne data?
Gjennom de siste 28 dagene med plattformtrafikk scoret Grok i gjennomsnitt høyere enn Qwen: 9.26 av 10 mot 8.87. Groks 10 % dårligst scorende oversettelser hadde fortsatt et snitt på 9.2, mens Qwens 10 % dårligst scorende falt til 7.6, et større gap i den nedre enden enn gjennomsnittet alene antyder.
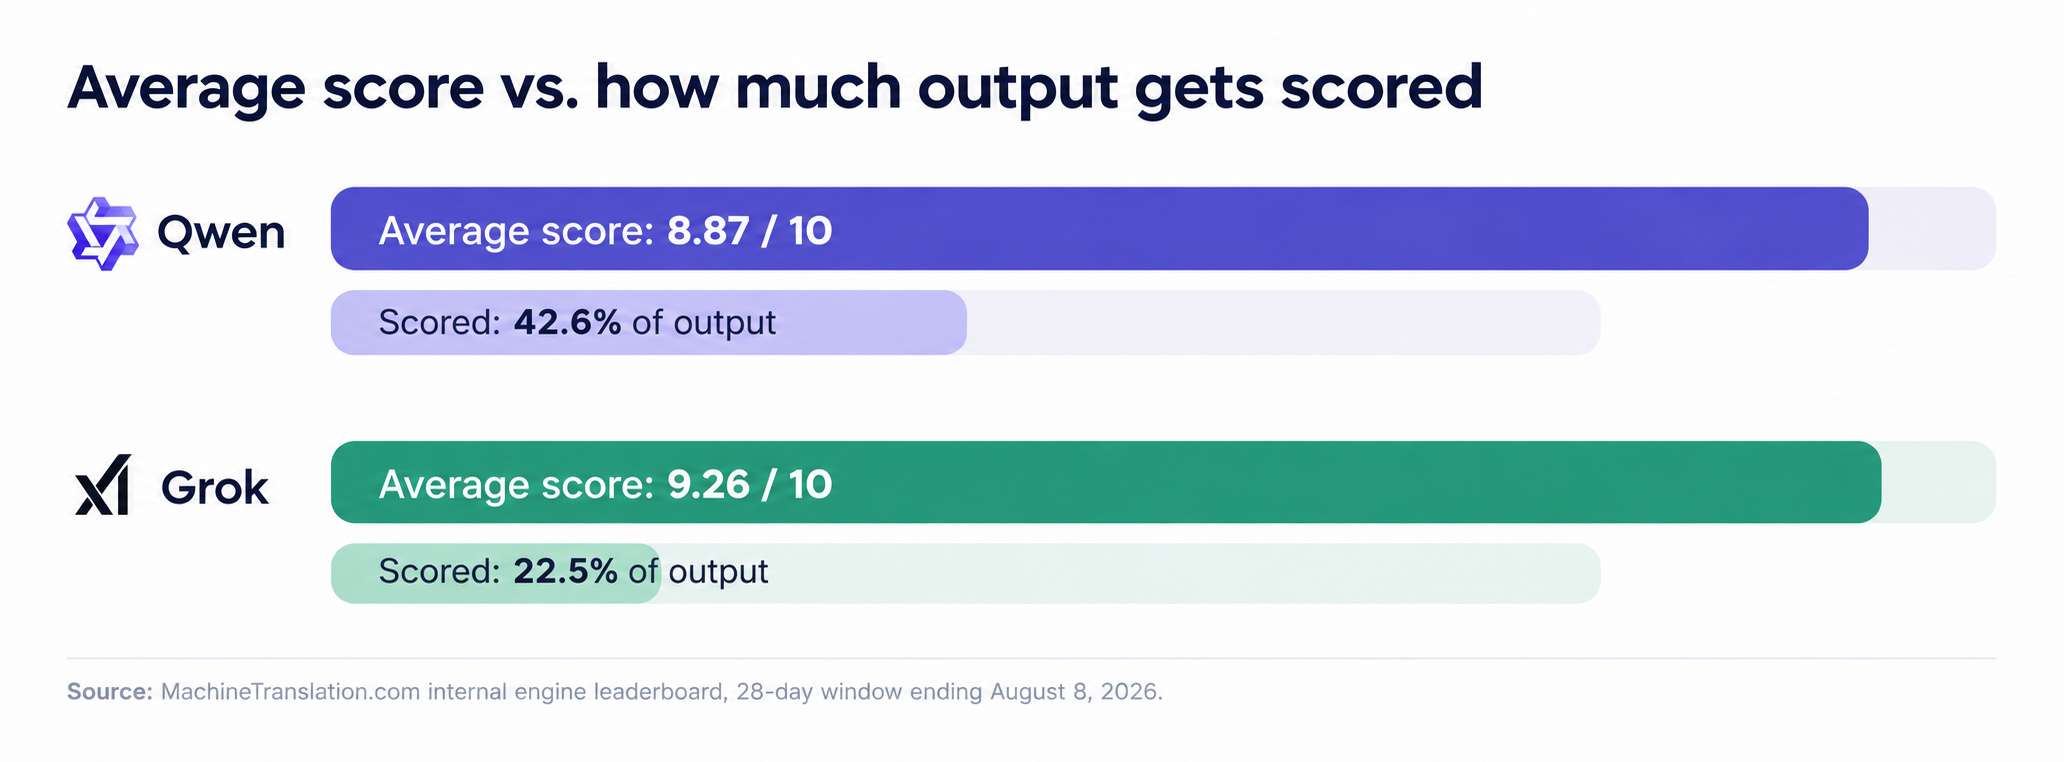
Groks gjennomsnittlige score er høyere, men den hviler på at mindre enn en fjerdedel av utdataene blir scoret, mot nesten halvparten for Qwen. De to søylene forteller forskjellige deler av den samme historien.
| Qwen | Grok | |
|---|---|---|
| Prosentandel av utdata scoret | 42.6% | 22.5% |
| Gjennomsnittlig score | 8.87 / 10 | 9.26 / 10 |
| De nederste 10 % av poengsummene | 7.6 | 9.2 |
Kilde: MachineTranslation.coms interne toppliste for motorer, 28-dagers vindu som avsluttes August 8, 2026.
Betyr Groks høyere poengsum at den er det bedre valget?
Ikke i seg selv. Grok brukes langt sjeldnere på plattformen enn Qwen, og mindre enn en fjerdedel av oversettelsene får i det hele tatt en poengsum, mot nesten halvparten av Qwens. Et mindre, mindre representativt utvalg kan få et gjennomsnitt til å se bedre eller dårligere ut enn det ville gjort over det samme volumet som Qwen håndterer. MachineTranslation.coms egen rapportering av disse dataene behandler poengdekning som en reell begrensning, ikke en fotnote: en motor som bedømmes ut fra en smal andel av trafikken sin, har ikke blitt testet like grundig som en som bedømmes på tvers av nesten halvparten av sine utdata.
Den ærlige tolkningen er at Groks tall er lovende, men tynnere. Qwens er lavere i gjennomsnitt, men hviler på et mye større og mer representativt grunnlag. Ingen av disse faktaene opphever det andre.
Hva med språkdekning?
Verken Qwen eller Grok publiserer en verifisert liste over språkpar der ytelsen faller, og det finnes ingen uavhengig testing for å bekrefte en slik liste. Det som med sikkerhet kan sies, er at ingen av modellene ble bygget rundt oversettelseskvalitet for et spesifikt sett med språk slik en dedikert oversettelsesplattform er. MachineTranslation.com tester og støtter over 270 språk direkte, noe som er en annen type påstand enn en generell modells brede, men utestede flerspråklige kapasitet.
Hvordan MachineTranslation.com faktisk bruker Qwen og Grok
MachineTranslation.com kjører Qwen, Grok og mer enn 20 andre AI-modeller på hver oversettelse, og viser deretter den versjonen disse modellene er mest enige om. Ingen av modellene utelukkes for å score lavere i gjennomsnitt. Å kjøre mange modeller samtidig betyr at man fanger opp tilfellene der en modell med lavere gjennomsnittlig poengsum likevel får en spesifikk setning riktig, noe en modell med høyere poengsum kan bomme på. Qwens ytelse deler seg også etter retning og språkpar på måter som er verdt å vite om før man velger en enkelt modell, noe som dekkes mer inngående i MachineTranslation.coms sammenligning av Qwen vs DeepSeek. For en nærmere titt på hvordan modeller testes direkte mot hverandre, se MachineTranslation.coms fullstendige testing for modellsammenligning.
Ofte stilte spørsmål
1. Er Qwen eller Grok bedre til oversettelse?
På MachineTranslation.com sine egne motordata over 28 dager, scorer Grok i gjennomsnitt høyere enn Qwen, 9,26 mot 8,87 av 10. Men Grok blir vurdert på en mye mindre og mindre representativ andel av utdataene sine, så dette er ikke en ren direkte sammenligning slik en test med matchede segmenter ville vært.
2. Hvorfor har Grok en høyere gjennomsnittsscore, men færre vurderte oversettelser?
Grok brukes sjeldnere på plattformen, og bare omtrent 22,5 % av utdataene blir vurdert, mot 42,6 % for Qwen. Et mindre og mindre representativt utvalg kan blåse opp eller trekke ned et gjennomsnitt, noe som er grunnen til at denne sammenligningen bør leses som retningsgivende, ikke definitiv.
3. Støtter Qwen eller Grok flest språk?
Begge er generelle AI-modeller uten en publisert, verifisert liste over språkspesifikke begrensninger. Ingen av dem er bygget spesifikt for oversettelse, noe som er annerledes enn en plattform som tester og scorer oversettelseskvalitet på tvers av over 270 språk direkte, i stedet for å stole på bred flerspråklig opplæring som en erstatning for målt oversettelsesytelse.
4. Konkurrerer MachineTranslation.com med Qwen og Grok?
Nei. MachineTranslation.com kjører Qwen, Grok og mer enn 20 andre AI-modeller på hver oversettelse, og løfter frem versjonen disse modellene er mest enige om. Den tester og kombinerer modeller som disse, i stedet for å konkurrere mot dem som en egen, separat modell.
5. Hvilken AI-modell anbefaler MachineTranslation.com for oversettelse?
Ingen som standard. Ulike modeller presterer ulikt avhengig av språkpar og innholdstype, og gapet mellom dem kan slå ut i begge retninger avhengig av hva som oversettes. Akkurat den variasjonen er grunnen til at plattformen kjører flere modeller på hver oversettelse i stedet for å velge én som en fast anbefaling.