September 25, 2026
Od GPT-3 do GPT-5: Jak naprawdę zmieniła się jakość tłumaczenia AI
GPT-3, GPT-4 i GPT-5 dzieli pięć lat i kilka generacji architektury, ale przydatne pytanie w kontekście tłumaczeń nie brzmi: „który z nich jest najinteligentniejszy”. Jest ono węższe: co dokładnie zmieniło się w sposobie, w jaki te modele radzą sobie z elementami języka, których nie da się przetłumaczyć słowo w słowo, takimi jak idiomy, wieloznaczność czy rejestr? Poprawa nastąpiła w konkretnych obszarach, w określonych momentach i nie przebiegała w linii prostej od starszych do nowszych wersji.
Co GPT-3 faktycznie oferował w kontekście tłumaczeń
OpenAI wydało GPT-3 w 2020 roku, zanim jeszcze powstał program testowy MachineTranslation.com, więc nic tutaj nie stanowi autorskiego benchmarku. To dobrze udokumentowana historia, a nie wynik wewnętrznych testów. GPT-3 był pierwszym modelem tego typu zdolnym do generowania płynnego, naturalnie brzmiącego tekstu w wielu językach bez treningu ukierunkowanego na konkretne zadania, co czyniło go prawdziwym kamieniem milowym. W przypadku samych tłumaczeń ta sama płynność niosła jednak za sobą realne ryzyko: GPT-3 potrafił wygenerować pewne siebie, poprawnie zbudowane zdanie w języku docelowym, które wciąż było błędne, przy czym nic w wyjściowym tekście nie wskazywało na popełnienie błędu.
Co zmieniło się wraz z nadejściem GPT-4
GPT-4 zadebiutował w marcu 2023 roku i to mniej więcej od tej generacji zaczynają się testy modeli prowadzone przez MachineTranslation.com. Poprawa była zauważalna, ale nierównomierna. Podczas testowania wieloznacznego angielskiego zwrotu „That's sick” w języku japońskim, GPT-4.1-nano był jedynym modelem spośród sześciu testowanych, który zredukował zamierzone podwójne znaczenie frazy do pojedynczej interpretacji, podczas gdy pozostałe pięć zachowało wieloznaczność zamierzoną w oryginalnym sformułowaniu. Większą słabością okazały się idiomy: przy przetłumaczeniu hiszpańskiego idiomu „llevarse el gato al agua” jednocześnie przez pięć wersji GPT, mniejsze GPT-4o-mini i GPT-4.1-nano wygenerowały to samo dosłowne, błędne tłumaczenie, całkowicie gubiąc sens idiomu.
Ten sam schemat powtórzył się w innych przypadkach. Niemiecki idiom „ich verstehe nur Bahnhof”, sprawdzony na ośmiu podwersjach GPT i Claude, został przetłumaczony dosłownie i niepoprawnie konkretnie przez GPT-4o-mini, podczas gdy mniejszy, nowszy model w tym samym teście, GPT-4.1-nano, poradził sobie z nim prawidłowo. Generacja i wielkość modelu nie korelowały ze sobą w żaden spójny sposób – to zjawisko testy wersji modeli na MachineTranslation.com opisują bardziej szczegółowo.
Co GPT-5 zmienił w kwestii tłumaczeń
OpenAI wprowadziło GPT-5 jako zunifikowany system, który w zależności od zadania przekierowuje zapytania między szybkim modelem domyślnym a bardziej zaawansowanym modelem rozumującym, co stanowi zmianę strukturalną w stosunku do jednolitych modeli GPT-4. Własny raport OpenAI GPT-5 System Card wykazuje ogólny wskaźnik błędów merytorycznych modelu o około 45% niższy niż w przypadku GPT-4 i o 80% niższy niż w GPT-3 – ten ogólny wzrost niezawodności uwidacznia się również bezpośrednio w tłumaczeniach. Testy MachineTranslation.com wskazują najwyraźniejszy postęp tam, gdzie modele z ery GPT-4 radziły sobie najgorzej: przy tym samym hiszpańskim idiomie, na którym potknęły się GPT-4o-mini i GPT-4.1-nano, zarówno GPT-5.4-mini, jak i GPT-5.4 podały poprawne, idiomatyczne tłumaczenia, formułując je nieco inaczej, ale w obu przypadkach w pełni rozumiejąc sam idiom.
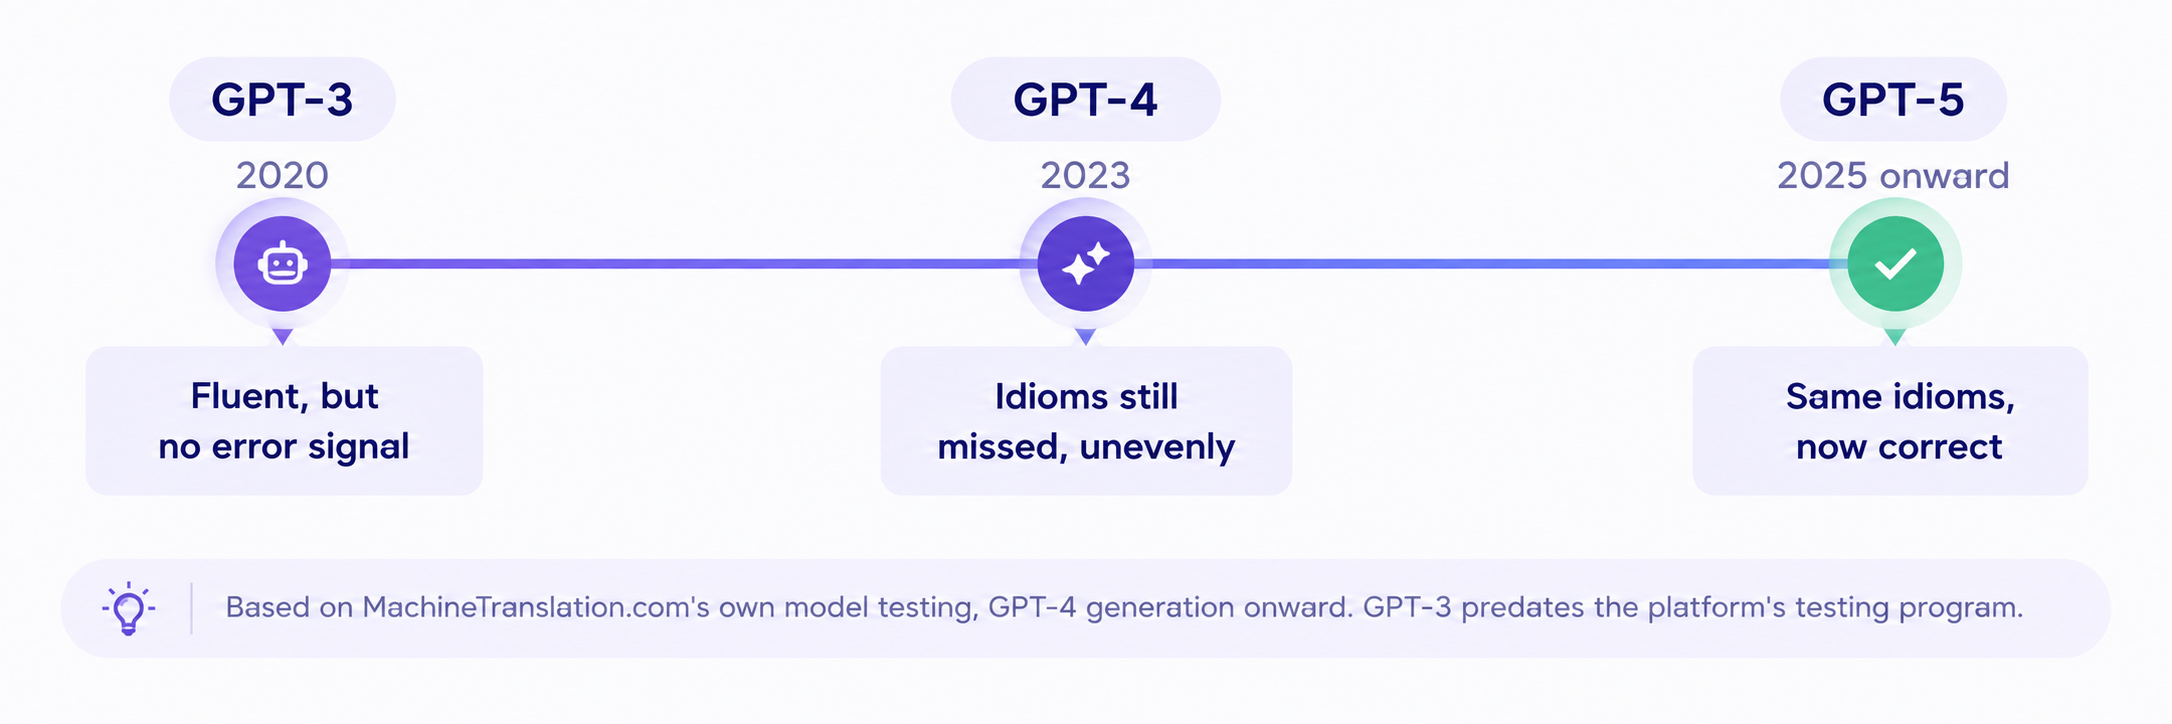
Różnica między generacjami nie była jednostajnym wzrostem. Koncentrowała się niemal w całości wokół języka idiomatycznego i wieloznacznego. W przypadku prostego tekstu modele z ery GPT-4 i GPT-5 uzyskują niemal identyczne wyniki.
| GPT-3 | GPT-4 | GPT-5 | |
|---|---|---|---|
| Premiera | 2020 | Marzec 2023 | 2025, obecnie GPT-5.4/5.5 |
| Dostępny obecnie | Nie, wycofany | Tylko przez API, wycofany z ChatGPT | Tak, obecna generacja |
| Obsługa idiomów | Nietestowane przez MachineTranslation.com (powstał przed programem) | Niespójna; całkowicie nie poradził sobie z kilkoma idiomami | Prawidłowo obsłużył te same idiomy, z którymi GPT-4 sobie nie poradził |
| Standardowy tekst biznesowy | Nietestowane przez MachineTranslation.com | Bardzo dobra, niemal identyczna jak w późniejszych modelach | Bardzo dobra, niemal identyczna jak w GPT-4 |
Ten ostatni punkt ma znaczenie: osobny test standardowego zwrotu biznesowego „please confirm receipt of this document”, przetłumaczonego na język niemiecki, dał niemal identyczne wyniki we wszystkich testowanych modelach, włączając w to GPT-4o-mini oraz modele generacji GPT-5. Różnica pokoleniowa dotyczy przede wszystkim języka przenośnego i wieloznacznego, a nie ogólnej różnicy w jakości.
Czy nowsza generacja GPT zawsze oznacza lepsze tłumaczenie?
Nie. Podczas testu hebrajskiego idiomu na różnych rodzinach modeli, GPT-5.4-mini i GPT-5.4 zaproponowały dwie różne, częściowe interpretacje tej samej frazy i żadna z nich nie była w pełni poprawna, podczas gdy starszy, niepowiązany model był bliższy właściwego znaczenia. Nowszy model nie oznacza automatycznie większej dokładności, a większy lub nowszy model nie jest automatycznie bezpieczniejszym wyborem dla danego zdania.
Jak dziś wypada GPT-5 w tłumaczeniach
Modele GPT-3 i GPT-4 zostały wycofane z ChatGPT; GPT-4 pozostaje dostępny wyłącznie za pośrednictwem API OpenAI dla istniejących integracji. Obecna generacja, GPT-5.4 i GPT-5.5, to rozwiązania wykorzystywane dziś przez MachineTranslation.com – radzą sobie one konkurencyjnie na tle aktualnych modeli innych dostawców, choć nie wypadają jednolicie lepiej w każdej parze językowej. Aby dowiedzieć się więcej o tym, jak poszczególne podwersje GPT wypadają w porównaniu ze sobą oraz z modelami takimi jak Claude i DeepSeek, sprawdź bezpośrednie testy podwersji na MachineTranslation.com, które wnikają głębiej, niż pozwala na to ogólny przegląd generacji.
Co to oznacza, jeśli prowadzisz lokalizację na dużą skalę
Najważniejszy wniosek dla dużego programu lokalizacyjnego nie brzmi: „GPT-5 wygrywa z GPT-3”. Chodzi o to, że konkretna wersja modelu, a nie tylko rodzina modeli, decyduje o tym, czy dany idiom lub wieloznaczne wyrażenie zostanie przetłumaczone poprawnie – i dotyczy to każdej pary językowej, a nie tylko kilku przedstawionych tutaj. Ma to największe znaczenie w treściach, które w dużej mierze opierają się na tonie wypowiedzi i języku figuratywnym, zwłaszcza w tekstach marketingowych i treściach generowanych przez użytkowników, gdzie pojedynczy idiom przetłumaczony dosłownie może zmienić cały sens posta lub reklamy. Program przekładający treści na dziesiątki języków natrafi na tego rodzaju język w każdym z nich. Seria testów podwersji oraz pełne testy porównawcze modeli na MachineTranslation.com omawiają tę kwestię bardziej szczegółowo. Podejście platformy, polegające na jednoczesnym uruchamianiu obecnych modeli GPT wraz z ponad 20 innymi przy każdym tłumaczeniu, istnieje właśnie dlatego, że historia wersji żadnego pojedynczego modelu nie stanowi sama w sobie wystarczająco wiarygodnej gwarancji.
Najczęściej zadawane pytania
1. Jaka jest rzeczywista różnica między GPT-3, GPT-4 i GPT-5 w tłumaczeniach?
GPT-3 radził sobie stosunkowo dobrze z prostym tekstem, ale miał ogromne trudności ze wszystkim, co idiomatyczne lub wieloznaczne. GPT-4 znacznie zmniejszył tę przepaść, jednak wciąż sprowadzał niektóre prawdziwie wieloznaczne sformułowania do jednego znaczenia, zamiast zachować ich dwuznaczność. Późniejsze podwersje GPT-5 poprawnie przetłumaczyły idiomy, które wcześniejsze modele z ery GPT-4 tłumaczyły dosłownie i błędnie.
2. Czy GPT-5 jest w tłumaczeniach zawsze lepszy od GPT-4?
Nie. Testy przeprowadzone przez MachineTranslation.com wykazały przypadki, w których mniejsza, nowsza podwersja radziła sobie lepiej niż większa i starsza, a różnica w jakości między generacjami dotyczy przede wszystkim języka idiomatycznego lub przenośnego, zamiast stanowić ogólną, wszechstronną poprawę.
3. Czy OpenAI nadal oferuje GPT-3 lub GPT-4?
Nie. Oba zostały wycofane z ChatGPT i zastąpione przez nowsze modele z generacji GPT-5. GPT-4 pozostaje dostępny wyłącznie za pośrednictwem API OpenAI dla istniejących integracji, a nie jako opcja konsumencka.
4. Z której wersji GPT korzysta MachineTranslation.com?
MachineTranslation.com korzysta z obecnych modeli generacji GPT-5 (GPT-5.4 i GPT-5.5, w zależności od planu) wraz z ponad 20 innymi modelami AI przy każdym tłumaczeniu, zamiast polegać wyłącznie na GPT.
5. Jak GPT-5 wypada w porównaniu z innymi aktualnymi modelami AI do tłumaczenia?
Modele generacji GPT-5 wypadają konkurencyjnie, ale nie są jednolicie lepsze od modeli takich jak Claude, Gemini czy DeepSeek. Różne modele wygrywają w przypadku różnych par językowych i typów treści, dlatego MachineTranslation.com testuje je bezpośrednio ze sobą, zamiast wybierać jeden jako domyślny.