October 2, 2026
Qwen vs Grok: Który model AI tłumaczy lepiej?
Qwen i Grok to modele AI ogólnego przeznaczenia, a nie narzędzia stricte do tłumaczeń, i oba należą do puli modeli, które MachineTranslation.com wykorzystuje przy każdym tłumaczeniu. Ma to znaczenie dla sposobu, w jaki należy odczytywać to, co poniżej. Jest to spojrzenie na to, jak dwa z modeli samej platformy radzą sobie w bezpośrednim starciu, z rzeczywistymi zastrzeżeniami, które wiążą się z tego rodzaju danymi, a nie na rywalizację między dwoma zewnętrznymi konkurentami a samą platformą.
Czym są Qwen i Grok?
Qwen to rodzina dużych modeli językowych firmy Alibaba, obecnie w generacji Qwen3.8, która została dodana do puli modeli MachineTranslation.com w ramach ciągłego rozwoju platformy. Grok to linia modeli firmy xAI, w momencie pisania tego tekstu dostępna w wersji Grok 4.7, która przeszła przez kilka wydań od wersji pierwotnie porównywanej w tym artykule, i dołączyła do platformy niezależnie. Żaden z tych modeli nie został stworzony specjalnie do tłumaczeń. Oba są systemami ogólnego przeznaczenia, które obsługują wiele języków w ramach szerszych możliwości językowych, co jest innym punktem wyjścia niż w przypadku platformy zbudowanej i testowanej pod kątem jakości samych tłumaczeń.
Jak Qwen i Grok wypadają w porównaniu na własnych danych MachineTranslation.com?
W ciągu ostatnich 28 dni ruchu na platformie, Grok uzyskał średnio wyższy wynik niż Qwen: 9.26 na 10 wobec 8.87. 10% najgorzej ocenianych tłumaczeń modelu Grok nadal osiągało średnią 9.2, podczas gdy 10% najsłabszych tłumaczeń modelu Qwen spadło do 7.6, co stanowi znacznie większą różnicę w dolnym przedziale, niż sugerowałaby to sama średnia.
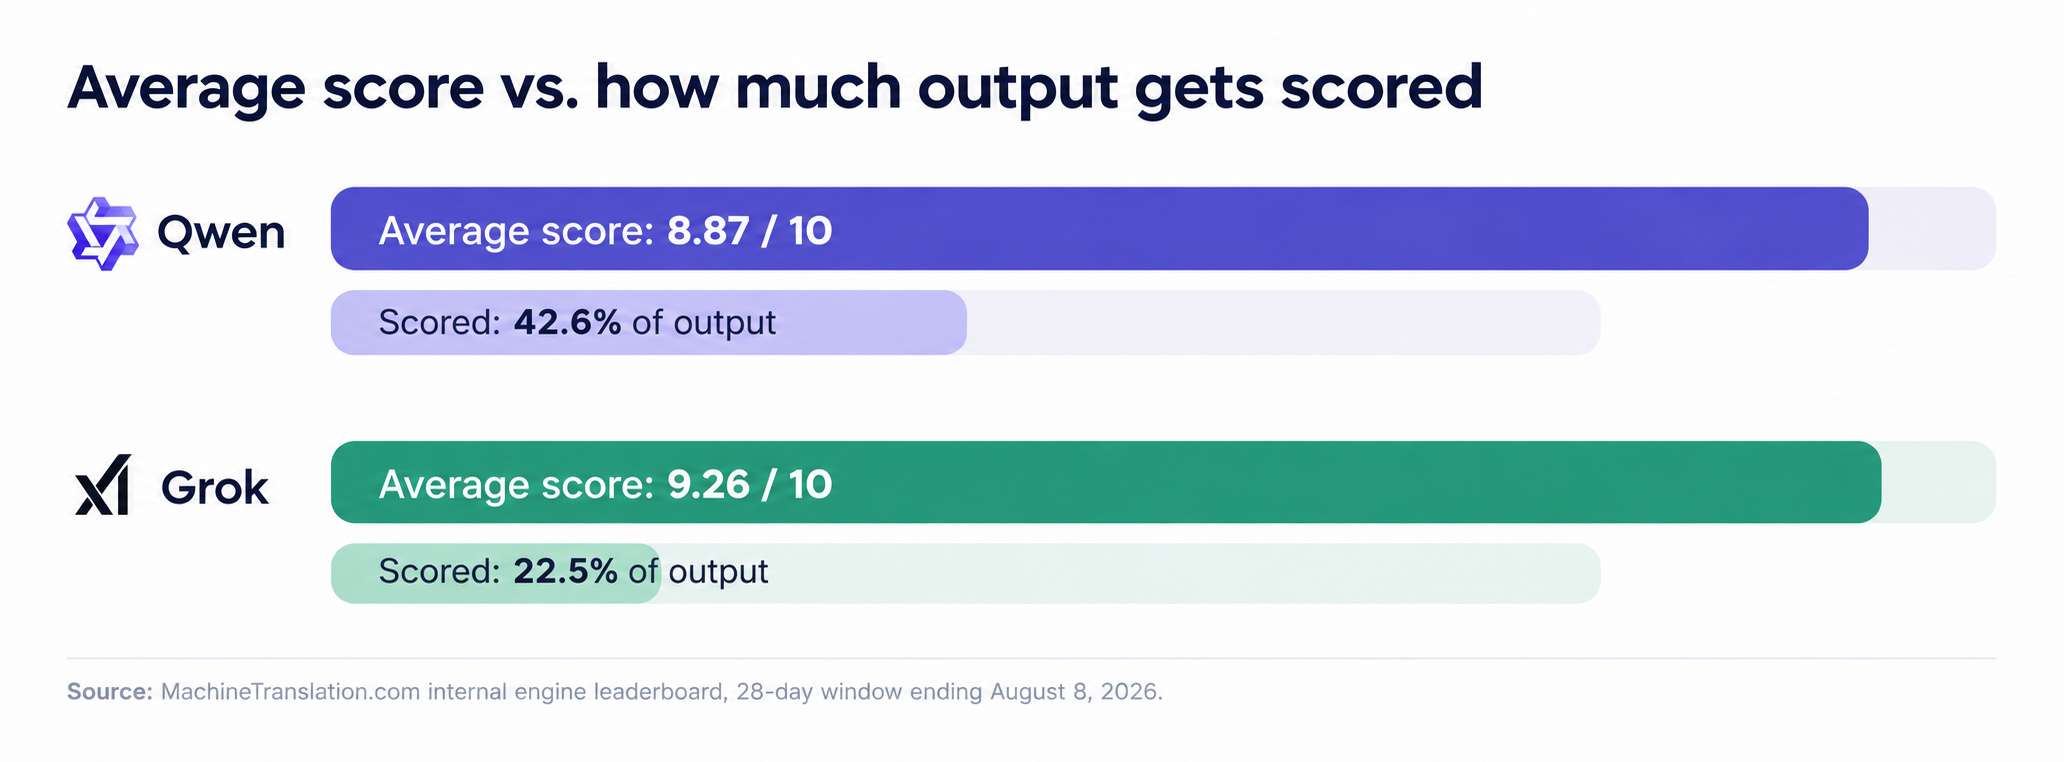
Średni wynik modelu Grok jest wyższy, ale opiera się na ocenie mniej niż jednej czwartej wygenerowanych przez niego tekstów, w porównaniu do prawie połowy w przypadku modelu Qwen. Te dwa słupki opowiadają różne części tej samej historii.
| Qwen | Grok | |
|---|---|---|
| Procent ocenionych wyników | 42.6% | 22.5% |
| Średni wynik | 8.87 / 10 | 9.26 / 10 |
| Najniższe 10% wyników | 7.6 | 9.2 |
Źródło: wewnętrzny ranking silników MachineTranslation.com, 28-dniowy okres kończący się 8 sierpnia 2026 r.
Czy wyższy wynik modelu Grok oznacza, że jest on lepszym wyborem?
Samo w sobie nie. Grok jest używany na platformie znacznie rzadziej niż Qwen, a mniej niż jedna czwarta jego tłumaczeń jest w ogóle oceniana, w porównaniu do prawie połowy w przypadku modelu Qwen. Mniejsza, mniej reprezentatywna próba może sprawić, że średnia będzie wyglądać na lepszą lub gorszą, niż miałoby to miejsce przy takiej samej liczbie tłumaczeń, z jaką ma do czynienia Qwen. Własne raporty MachineTranslation.com dotyczące tych danych traktują zakres pokrycia ocenami jako rzeczywiste ograniczenie, a nie tylko przypis: silnik oceniany na podstawie wąskiego wycinka swojego ruchu nie został przetestowany tak gruntownie, jak ten oceniany na podstawie niemal połowy swoich wyników.
Uczciwa interpretacja jest taka, że wyniki modelu Grok są obiecujące, ale oparte na skromniejszej próbie. Wyniki Qwen są średnio niższe, ale opierają się na znacznie większej, bardziej reprezentatywnej bazie. Żaden z tych faktów nie wyklucza drugiego.
Co z zakresem obsługiwanych języków?
Ani Qwen, ani Grok nie publikują zweryfikowanej listy par językowych, przy których spada ich skuteczność, i nie ma niezależnych testów, które mogłyby to potwierdzić. Z całą pewnością można stwierdzić, że żaden z tych modeli nie został zbudowany z naciskiem na jakość tłumaczeń dla konkretnego zestawu języków, tak jak ma to miejsce w przypadku dedykowanej platformy tłumaczeniowej. MachineTranslation.com bezpośrednio testuje i obsługuje ponad 270 języków, co ma inną wagę niż szerokie, ale nieprzetestowane możliwości wielojęzyczne modelu ogólnego przeznaczenia.
Jak MachineTranslation.com w rzeczywistości wykorzystuje modele Qwen i Grok
MachineTranslation.com uruchamia Qwen, Grok i ponad 20 innych modeli AI przy każdym tłumaczeniu, a następnie prezentuje wersję, w stosunku do której modele te wykazują największą zgodność. Żaden model nie jest wykluczany z powodu niższej średniej ocen. Uruchomienie wielu modeli jednocześnie pozwala wychwycić sytuacje, w których średnio gorzej oceniany model prawidłowo przetłumaczy konkretne zdanie, podczas gdy ten wyżej oceniany popełni błąd. Wyniki modelu Qwen różnią się także w zależności od kierunku i pary językowej, z czym warto się zapoznać przed podjęciem decyzji o wyborze jednego modelu, co zostało szerzej omówione w porównaniu Qwen vs DeepSeek na MachineTranslation.com. Aby dokładniej zapoznać się z tym, jak modele są testowane bezpośrednio względem siebie, zobacz pełne testy porównawcze modeli na MachineTranslation.com.
Często zadawane pytania
1. Czy do tłumaczeń lepszy jest Qwen, czy Grok?
Według własnych danych MachineTranslation.com dotyczących silników z okresu 28 dni, Grok osiąga średnio wyższe wyniki niż Qwen, 9.26 w porównaniu do 8.87 na 10. Jednak Grok jest oceniany na znacznie mniejszym, mniej reprezentatywnym wycinku swoich wyników, więc nie jest to czyste bezpośrednie porównanie, jak miałoby to miejsce w teście na dopasowanych segmentach.
2. Dlaczego Grok ma wyższy średni wynik, ale mniej ocenionych tłumaczeń?
Grok jest rzadziej używany na platformie i tylko około 22.5% jego wyników podlega ocenie, w porównaniu do 42.6% dla Qwen. Mniejsza, mniej reprezentatywna próba może zawyżyć lub zaniżyć średnią, dlatego to porównanie powinno być traktowane jako orientacyjne, a nie ostateczne.
3. Czy Qwen lub Grok obsługuje więcej języków?
Oba to modele AI ogólnego przeznaczenia, które nie posiadają opublikowanej, zweryfikowanej listy ograniczeń specyficznych dla poszczególnych języków. Żaden z nich nie został stworzony specjalnie do tłumaczeń, co odróżnia je od platformy, która bezpośrednio testuje i ocenia jakość tłumaczeń w ponad 270 językach, zamiast polegać na wszechstronnym, wielojęzycznym treningu jako zastępstwie dla zmierzonej skuteczności tłumaczenia.
4. Czy MachineTranslation.com konkuruje z Qwen i Grok?
Nie. MachineTranslation.com uruchamia Qwen, Grok i ponad 20 innych modeli AI dla każdego tłumaczenia i prezentuje wersję, co do której modele te wykazują największą zgodność. Platforma ta testuje i łączy takie modele, zamiast z nimi konkurować jako odrębny, własny model.
5. Który model AI poleca MachineTranslation.com do tłumaczeń?
Domyślnie żadnego. Różne modele działają inaczej w zależności od pary językowej i typu treści, a przewaga może leżeć po każdej ze stron w zależności od tego, co jest tłumaczone. Właśnie ta zmienność sprawia, że platforma uruchamia wiele modeli dla każdego tłumaczenia, zamiast wybierać jeden jako stałą rekomendację.