September 9, 2026
Qwen vs DeepSeek: Qual modelo de IA traduz melhor?
Execute os mesmos 12,000 segmentos de tradução no Qwen e no DeepSeek, e o DeepSeek vence na maioria dos pares de idiomas. Essa não é toda a história. Divida os resultados por direção, e um padrão específico aparece: O Qwen reduz a maior parte da diferença e, às vezes, assume a liderança, especificamente quando o idioma de destino é o inglês. Ao traduzir do inglês para qualquer outro idioma, o DeepSeek vence quase sempre.
Essa divisão importa mais do que um único vencedor geral se você estiver traduzindo conteúdo em dezenas de idiomas em vez de apenas um par de idiomas.
O que são Qwen e DeepSeek?
O Qwen é a família de grandes modelos de linguagem da Alibaba. A geração atual é o Qwen3.8, lançado em agosto de 2026: O Qwen3.8-Max é o modelo principal fechado, disponível apenas por API, com 2.4 trilhões de parâmetros, enquanto o Qwen3.8-27B é um modelo menor de pesos abertos lançado sob a Apache 2.0 alguns dias depois, voltado para equipes que desejam realizar auto-hospedagem.
O DeepSeek é um laboratório de IA chinês conhecido por modelos de mistura de especialistas que igualam o desempenho de fronteira a uma fração do custo de inferência. Sua geração atual, DeepSeek V4, foi lançada em abril de 2026 em duas variantes: V4 Pro (1.6 trilhão de parâmetros totais, cerca de 49 bilhões ativos por token) para trabalhos focados em qualidade, e V4 Flash (284 bilhões no total, cerca de 13 bilhões ativos) para cargas de trabalho sensíveis à latência. Ambos são distribuídos como pesos abertos sob licença MIT.
Como o Qwen e o DeepSeek realmente se comparam em tradução, não apenas em benchmarks?
A maioria das comparações entre Qwen e DeepSeek cita benchmarks de uso geral: programação, matemática, raciocínio. Nenhum deles mede a qualidade da tradução diretamente, e executar cada modelo em textos de origem diferentes torna impossível isolar qualquer lacuna de precisão daquilo que o próprio texto exigia.
O próprio tráfego de tradução do MachineTranslation.com nos últimos 28 dias oferece uma resposta mais clara, porque ambos os modelos traduziram o mesmo texto de origem. Em 98 pares de idiomas e mais de 12.000 segmentos correspondentes, o DeepSeek obteve pontuação mais alta em 83 pares; o Qwen obteve pontuação mais alta em 15. Ao limitar isso aos 27 pares em que o idioma de destino é o inglês, a diferença diminui drasticamente: O DeepSeek vence em 63% deles (17 de 27), e o Qwen vence em 37% (10 de 27). Nos 71 pares restantes, em que o inglês não é o destino, o DeepSeek vence em 92% (66 de 71).
Taxa de vitória por direção de tradução (98 pares de idiomas, texto idêntico)
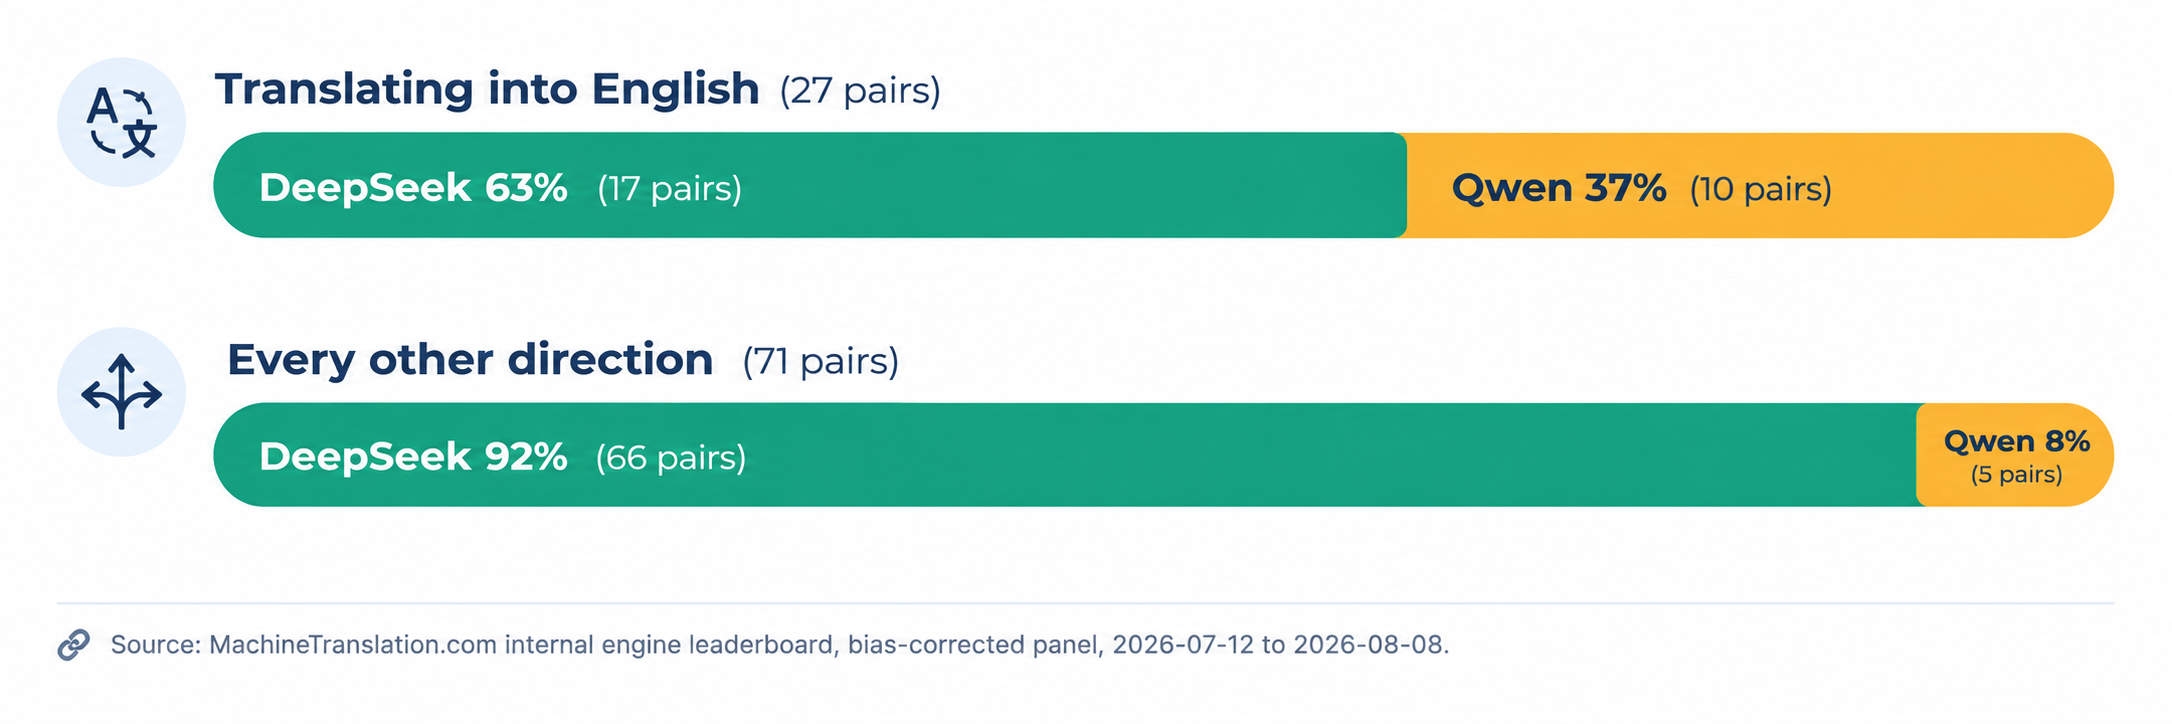
O DeepSeek vence na grande maioria dos pares de idiomas no geral. A janela competitiva do Qwen é estreita, mas real: traduzir para o inglês, onde ele leva mais de um terço dos pares. Dados: Placar interno de mecanismos do MachineTranslation.com, painel corrigido de viés, 12 de julho a 8 de agosto de 2026.
A média ponderada em todos os segmentos correspondentes coloca o DeepSeek em 9.13 de 10 e o Qwen em 8.98. Essa é uma diferença real, mas não está distribuída de maneira uniforme, o que é a informação mais útil de se saber se o seu conteúdo se move em mais de uma direção. Esta é a mesma abordagem de confronto direto que o MachineTranslation.com usa em todo o seu teste de comparação de modelos completo, não apenas para este par específico.
Os números agregados também se sustentam em casos de teste individuais. Ao testar a frase em francês "Elle est directrice adjointe du département commercial", o DeepSeek e o Qwen convergiram para a mesma tradução em inglês, "deputy director of commercial department". Você pode verificar esse resultado de teste ao vivo diretamente. Ao testar "as soon as possible" traduzido para o espanhol, o DeepSeek rompeu com o consenso de quatro modelos com "esté hecho" em vez de "se haga", o que é um caso de divergência real que reflete uma distinção gramatical de processo versus resultado, não um erro.
Por que o Qwen se sai melhor traduzindo especificamente para o inglês?
Os dados não explicam o porquê, apenas onde. Alguns dos pares mais fortes do Qwen para o inglês são tâmil, chinês, polonês, italiano e hebraico, que são idiomas de origem com corpora de treinamento em inglês grandes e bem documentados, geralmente disponíveis para desenvolvedores de modelos. Fora dessa direção única, a vantagem do DeepSeek se mantém em quase todos os lugares: a partir do inglês e também entre pares de idiomas que não incluem o inglês.
O que isso descarta é tratar qualquer um dos modelos como um padrão universal. Uma equipe que traduzisse listagens de produtos de espanhol para seis idiomas e esperasse o mesmo ranking de desempenho que viu ao traduzir um tíquete de suporte em chinês para o inglês estaria aplicando a lição errada da direção errada, que é a mesma assimetria observada na análise de modelos de espanhol para inglês do MachineTranslation.com , onde os modelos líderes não são os mesmos que lideram na direção oposta.
O Qwen e o DeepSeek são gratuitos e de código aberto?
O licenciamento se divide de forma diferente para cada um. O DeepSeek licencia tanto o V4 Pro quanto o V4 Flash sob a licença MIT, um dos termos de código aberto mais permissivos disponíveis, de modo que ambos são gratuitos para auto-hospedagem sem restrições. O Qwen está dividido: O Qwen3.8-27B é distribuído sob a licença Apache 2.0 e é gratuito para auto-hospedagem, mas o modelo principal, Qwen3.8-Max, permanece fechado, disponível apenas via API e sob a licença personalizada da própria Alibaba.
Na prática, isso significa que existe uma opção de pesos totalmente abertos e licenciada sob MIT do lado do DeepSeek em ambos os níveis de qualidade. Do lado do Qwen, optar por pesos abertos significa abrir mão do modelo principal.
Quanto custa para rodar o Qwen e o DeepSeek em escala?
Após o corte permanente de preços do DeepSeek em maio de 2026, suas tarifas de API publicadas atualmente são de $0.435 per million input tokens (cache miss) and $0.87 por milhão de tokens de saída para o V4 Pro, com o V4 Flash tendo um preço menor para sua camada otimizada para latência.
Para equipes que auto-hospedam qualquer um dos modelos em vez de usar uma API hospedada, a comparação de custos muda totalmente para a infraestrutura de GPU e se torna uma função da contagem de parâmetros e da eficiência de parâmetros ativos, em vez de uma tarifa por token.
Algum dos modelos é seguro o suficiente para conteúdo jurídico, médico ou regulamentado?
Nenhum dos modelos publica certificações de segurança específicas para tradução, e as avaliações de segurança de uso geral não testam os modos de falha que importam em conteúdos regulamentados: uma dosagem traduzida incorretamente, uma cláusula de responsabilidade alterada, um termo jurídico inconsistente. Os próprios testes do MachineTranslation.com encontraram exatamente esse tipo de divergência entre modelos em linguagem jurídica e médica, incluindo casos em que os modelos usaram termos jurídicos diferentes com escopos diferentes , apesar de ambos terem obtido boas pontuações em métricas de qualidade gerais.
Para contratos, documentos de imigração ou conteúdo clínico, esse é o motivo para associar a saída de qualquer um dos modelos a uma etapa de verificação humana em vez de confiar cegamente no resultado de uma única IA, independentemente de qual modelo o gerou.
O que isso significa se você estiver localizando para muitos idiomas ao mesmo tempo?
Uma comparação baseada em apenas um par de idiomas não diz quase nada sobre o par de número quarenta. A divisão "para o inglês/a partir do inglês" documentada aqui se manteve em uma amostra de 98 pares especificamente porque foi testada nessa escala: um único teste de inglês para espanhol, que é o que a maioria das comparações entre Qwen e DeepSeek realiza, teria mostrado o DeepSeek confortavelmente à frente e não diria nada sobre o que acontece quando tâmil, polonês ou hebraico entram no fluxo.
Esse é o argumento prático para não prender, por padrão, um grande programa de localização ao resultado de um único modelo. O MachineTranslation.com executa tanto o Qwen quanto o DeepSeek, juntamente com mais de 20 outros modelos, em cada tradução e apresenta a versão em que esses modelos mais concordam, para que uma implantação em 68 idiomas não dependa de qual modelo por acaso venceu no único par que alguém testou primeiro. Você pode verificar exatamente quais modelos concordaram ou divergiram em qualquer tradução na análise de modelos por tradução que a plataforma exibe para cada resultado.
Cada tradução é verificada em relação a uma gama mais ampla de modelos do que o Qwen ou o DeepSeek sozinhos podem oferecer, o que é a resposta direta para o que acontece quando seu conteúdo deixa de se mover em apenas uma direção.
Perguntas frequentes
1. O Qwen ou o DeepSeek é melhor para tradução?
Em 98 pares de idiomas testados com textos de origem idênticos, o DeepSeek obteve pontuações mais altas em 83 deles. As vitórias do Qwen se concentram em uma direção específica: a tradução para o inglês, na qual ele vence cerca de um terço das vezes. Em todas as outras direções, o DeepSeek vence mais de 90% das vezes.
2. O Qwen é gratuito para usar?
O Qwen3.8-27B possui pesos abertos sob a licença Apache 2.0 e é gratuito para auto-hospedagem. O modelo principal Qwen3.8-Max é fechado e está disponível apenas por meio da API paga da Alibaba Cloud.
3. O DeepSeek é gratuito para usar?
Sim. Tanto o DeepSeek V4 Pro quanto o V4 Flash são fornecidos com pesos abertos sob licença MIT, de modo que você pode auto-hospedar qualquer um deles sem custo de licenciamento. O DeepSeek também oferece uma API paga para equipes que não querem gerenciar sua própria infraestrutura.
4. Qual é mais rápido, Qwen ou DeepSeek?
O DeepSeek V4 Flash foi desenvolvido especificamente para baixa latência, com 13 bilhões de parâmetros ativos por token versus os 49 bilhões do V4 Pro. A opção equivalente mais leve do Qwen, o Qwen3.8-27B, é densa em vez de mistura de especialistas, o que geralmente a torna mais lenta por token em uma qualidade comparável.
5. Posso usar o Qwen e o DeepSeek juntos para tradução?
Sim. O MachineTranslation.com executa ambos os modelos, além de mais de 20 outros, em cada tradução e apresenta a versão na qual eles mais concordam, para que você não fique preso escolhendo um modelo e esperando que ele seja a opção mais forte para aquele par de idiomas específico.
6. Qual é a diferença entre o licenciamento do Qwen e do DeepSeek?
O DeepSeek licencia ambas as variantes do V4 sob a MIT, uma das licenças de código aberto mais permissivas disponíveis. O Qwen divide sua linha de modelos: modelos menores, como o Qwen3.8-27B, são distribuídos sob a Apache 2.0, mas o carro-chefe Qwen3.8-Max permanece fechado sob uma licença personalizada.