October 2, 2026
Qwen vs Grok: Qual modelo de IA traduz melhor?
Qwen e Grok são ambos modelos de IA de uso geral, não ferramentas específicas de tradução, e ambos fazem parte do conjunto de modelos que o MachineTranslation.com executa em cada tradução. Isso é importante para entender o que vem a seguir. Esta é uma análise de como dois dos modelos da própria plataforma se saem um contra o outro, com as ressalvas reais que vêm com esse tipo de dados, e não uma competição entre dois desafiantes externos e a própria plataforma.
O que são Qwen e Grok?
Qwen é a família de grandes modelos de linguagem do Alibaba, atualmente em sua geração Qwen3.8, e foi adicionada ao conjunto de modelos do MachineTranslation.com como parte da expansão contínua da plataforma. Grok é a linha de modelos da xAI, atualmente no Grok 4.7 no momento da redação deste artigo, tendo passado por vários lançamentos desde a versão que este artigo comparou originalmente, e se juntou à plataforma separadamente. Nenhum dos modelos foi construído especificamente para tradução. Ambos são sistemas de uso geral que, por acaso, lidam com muitos idiomas como parte de uma capacidade de linguagem mais ampla, o que é um ponto de partida diferente de uma plataforma construída e testada especificamente em torno da qualidade da tradução.
Como o Qwen e o Grok se comparam nos próprios dados do MachineTranslation.com?
Nos últimos 28 dias de tráfego da plataforma, o Grok obteve uma pontuação média mais alta que o Qwen: 9.26 de 10 contra 8.87. Os 10% das traduções com as piores pontuações do Grok ainda tiveram uma média de 9.2, enquanto os 10% piores do Qwen caíram para 7.6, uma diferença maior na extremidade inferior do que a média por si só sugere.
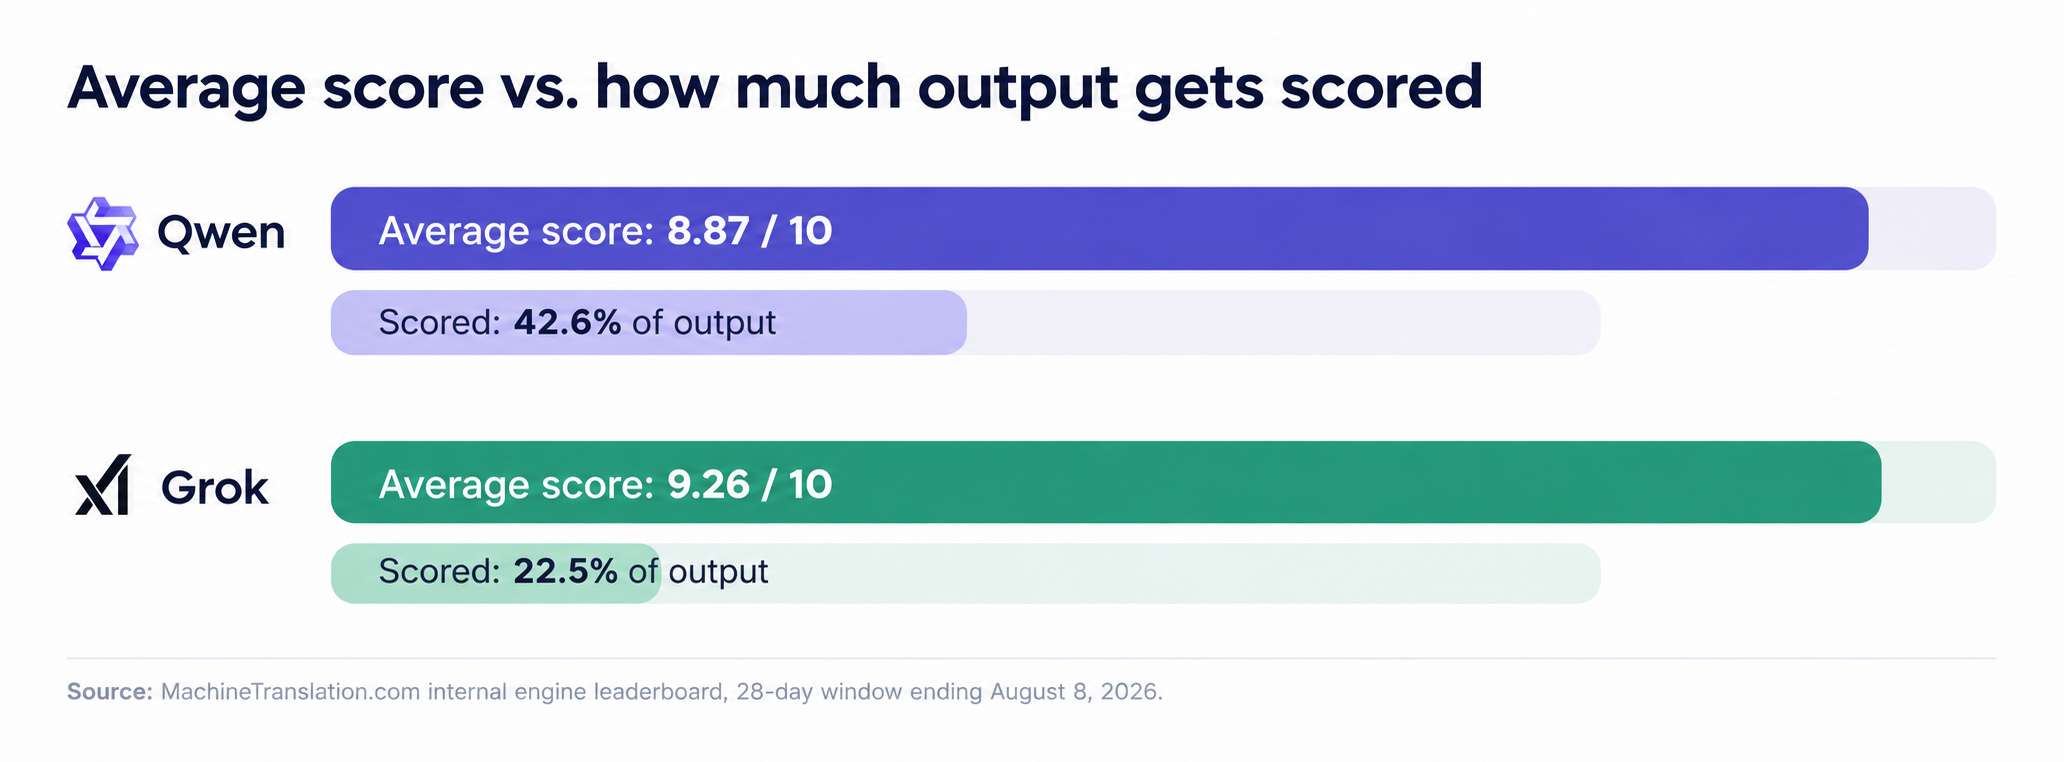
A pontuação média do Grok é mais alta, mas se baseia na pontuação de menos de um quarto de sua produção, contra quase metade do Qwen. As duas barras contam partes diferentes da mesma história.
| Qwen | Grok | |
|---|---|---|
| Porcentagem da produção pontuada | 42.6% | 22.5% |
| Pontuação média | 8.87 / 10 | 9.26 / 10 |
| 10% das pontuações mais baixas | 7.6 | 9.2 |
Fonte: Ranking interno de motores do MachineTranslation.com, janela de 28 dias terminando em August 8, 2026.
A pontuação mais alta do Grok significa que ele é a melhor escolha?
Não por si só. O Grok é usado com muito menos frequência na plataforma do que o Qwen, e menos de um quarto das suas traduções recebem alguma pontuação, contra quase metade das do Qwen. Uma amostra menor e menos representativa pode fazer uma média parecer melhor ou pior do que seria no mesmo volume que o Qwen vê. Os próprios relatórios do MachineTranslation.com sobre esses dados tratam a cobertura de pontuação como uma limitação real, não uma nota de rodapé: um motor avaliado em uma fatia estreita do seu tráfego não foi testado tão minuciosamente quanto um avaliado em quase metade do seu volume de saída.
A leitura honesta é que os números do Grok são promissores, mas mais escassos. Os do Qwen são menores em média, mas se apoiam em uma base muito maior e mais representativa. Nenhum dos fatos anula o outro.
E quanto à cobertura de idiomas?
Nem o Qwen nem o Grok publicam uma lista verificada de pares de idiomas nos quais o desempenho cai, e não existe nenhum teste independente para confirmar uma. O que se pode dizer com confiança é que nenhum dos modelos foi construído em torno da qualidade de tradução em um conjunto específico de idiomas da mesma forma que uma plataforma de tradução dedicada. O MachineTranslation.com testa e tem suporte direto a mais de 270 idiomas, o que é um tipo de afirmação diferente da capacidade multilíngue ampla, porém não testada, de um modelo de uso geral.
Como o MachineTranslation.com realmente usa o Qwen e o Grok
O MachineTranslation.com roda o Qwen, o Grok e mais de 20 outros modelos de IA em cada tradução, e então apresenta a versão com a qual esses modelos mais concordam. Nenhum modelo é excluído por obter uma pontuação média menor. Rodar muitos modelos ao mesmo tempo significa capturar os casos em que um modelo com pontuação média menor ainda acerta uma frase específica que um modelo com pontuação maior erra. O desempenho do Qwen também se divide por direção e paridade de maneiras que vale a pena saber antes de escolher um único modelo, o que é abordado com mais profundidade na comparação Qwen vs DeepSeek do MachineTranslation.com. Para um olhar mais atento sobre como os modelos são testados diretamente uns contra os outros, veja o teste completo de comparação de modelos do MachineTranslation.com.
Perguntas frequentes
1. O Qwen ou o Grok é melhor para tradução?
Nos próprios dados de 28 dias dos motores do MachineTranslation.com, o Grok tem uma pontuação média mais alta que o Qwen, 9.26 contra 8.87 de 10. Mas o Grok é avaliado em uma fatia muito menor e menos representativa de seus resultados, então este não é um confronto direto limpo como seria um teste de segmentos correspondentes.
2. Por que o Grok tem uma pontuação média mais alta, mas menos traduções avaliadas?
O Grok é usado com menos frequência na plataforma e apenas cerca de 22.5% de seus resultados são avaliados, contra 42.6% do Qwen. Uma amostra menor e menos representativa pode inflar ou subestimar uma média, e é por isso que essa comparação deve ser lida como direcional, não definitiva.
3. O Qwen ou o Grok suporta mais idiomas?
Ambos são modelos de IA de uso geral sem uma lista publicada e verificada de limitações específicas de idiomas. Nenhum deles foi desenvolvido especificamente para tradução, o que é diferente de uma plataforma que testa e pontua diretamente a qualidade da tradução em mais de 270 idiomas, em vez de depender de um amplo treinamento multilíngue como substituto para o desempenho medido de tradução.
4. O MachineTranslation.com compete com o Qwen e o Grok?
Não. O MachineTranslation.com executa o Qwen, o Grok e mais de 20 outros modelos de IA em cada tradução e apresenta a versão com a qual esses modelos mais concordam. Ele testa e combina modelos como esses em vez de competir com eles como um modelo próprio separado.
5. Qual modelo de IA o MachineTranslation.com recomenda para tradução?
Nenhum por padrão. Modelos diferentes têm desempenhos diferentes por par de idiomas e tipo de conteúdo, e a diferença entre eles pode ir em qualquer direção dependendo do que está sendo traduzido. Essa variação é exatamente o motivo pelo qual a plataforma executa vários modelos em cada tradução em vez de escolher um como uma recomendação permanente.