October 9, 2026
Qwen vs ChatGPT: Qual modelo de IA traduz melhor?
A atual geração do ChatGPT e o Qwen fazem parte do conjunto de modelos que o MachineTranslation.com executa em cada tradução, e não dois concorrentes externos sendo avaliados em relação à própria plataforma. Ao processar o mesmo texto em ambos com segmentos idênticos, o ChatGPT vence a maior parte dos pares de idiomas no geral. Ao dividir os resultados por direção, o cenário se estreita nitidamente em um ponto específico: a tradução para o inglês, onde os dois estão praticamente empatados.
Existe alguma IA melhor do que o ChatGPT para tradução?
O interesse geral por alternativas ao ChatGPT cresceu à medida que os modelos concorrentes melhoraram, embora os motivos variem amplamente conforme o caso de uso e não haja uma explicação única. Especificamente para tradução, a pergunta mais útil é qual modelo realmente apresenta melhor desempenho em um determinado par de idiomas — uma questão testável, em vez de uma questão de opinião.
Ao longo dos últimos 28 dias de tráfego do MachineTranslation.com, ambos os modelos traduziram textos de origem idênticos em 98 pares de idiomas. O ChatGPT obteve pontuações mais altas em 77 desses pares; o Qwen obteve pontuações mais altas em 21. A média ponderada entre os resultados comparados coloca o ChatGPT com 9.10 de 10 e o Qwen com 8.98, uma diferença real, mas modesta na média, que oculta uma divisão muito mais acentuada quando a direção é levada em consideração.
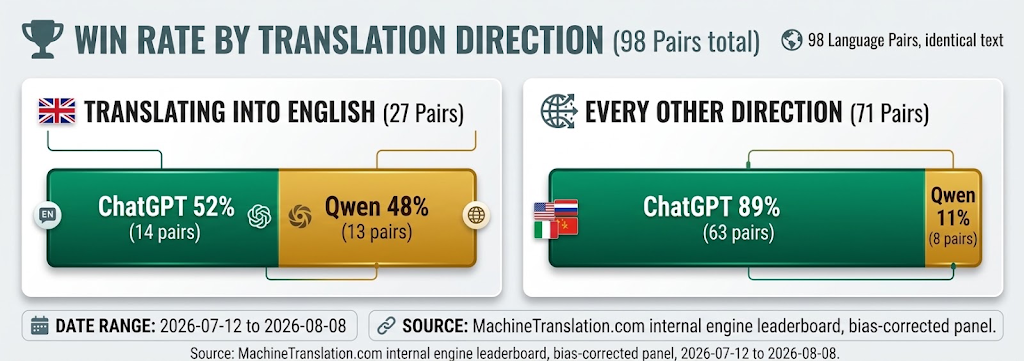
Para o inglês, os dois modelos estão quase empatados. Em todas as outras direções, o ChatGPT vence a grande maioria dos pares testados.
| ChatGPT | Qwen | |
|---|---|---|
| Porcentagem de resultados avaliados | 54.76% | 42.6% |
| Pontuação média | 8.89 / 10 | 8.87 / 10 |
| 10% inferior das pontuações | 7.8 | 7.6 |
| Taxa de vitória, para o inglês | 52% | 48% |
| Taxa de vitória, em todas as outras direções | 89% | 11% |
Por que a diferença quase desaparece ao traduzir para o inglês?
Os dados mostram onde ocorre a divisão, não o porquê. O que está claro é que a competitividade do Qwen não é distribuída uniformemente. De 27 pares em que o idioma de destino é o inglês, o Qwen vence 13, praticamente cara ou coroa. Dos 71 pares restantes, tanto traduzindo a partir do inglês quanto entre dois idiomas diferentes do inglês, o ChatGPT vence 63, ou 89% deles. Uma equipe que presumir que o desempenho do Qwen para o inglês se estende à tradução a partir do inglês ou entre pares de outros idiomas estaria tirando a lição errada da direção errada.
A Qwen é uma empresa chinesa, e isso importa para a tradução?
O Qwen é desenvolvido pela Alibaba Cloud, sediada na China. Por si só, isso não muda a qualidade com que o modelo traduz uma determinada frase; os dados acima refletem a qualidade real do resultado, independentemente de onde o modelo é desenvolvido. Onde isso pode importar é no tratamento de dados: empresas que traduzem conteúdo regulamentado ou confidencial (contratos, registros médicos, informações pessoais) devem tratar a questão de onde um provedor de IA processa e armazena esse conteúdo como um item real de devida diligência, separado da qualidade da tradução em si. Isso se aplica a qualquer provedor de IA, não especificamente ao Qwen, e é parte do motivo pelo qual o MachineTranslation.com publica diretamente suas próprias práticas de segurança e tratamento de dados, em vez de deixar a questão sem resposta.
Algum dos modelos é mais confiável para tradução jurídica e empresarial?
Não de forma consistente, e a divergência nem sempre se resume a qual modelo obtém a maior pontuação. Os testes do MachineTranslation.com com a linguagem real de contratos revelaram dois casos distintos que vale a pena conhecer antes de confiar em qualquer um dos modelos para textos jurídicos. A linguagem idiomática às vezes toma o caminho oposto: um teste comparativo direto à parte constatou que o ChatGPT traduziu uma expressão idiomática alemã de forma literal e incorreta, enquanto o Qwen identificou o significado idiomático correto — um lembrete de que a liderança geral de qualquer um dos modelos nos dados agregados não se confirma frase por frase.
| Caso de teste | ChatGPT | Qwen |
|---|---|---|
| "At-will employment" para o alemão | Formulação utilizável e funcional | Recorreu a um conceito jurídico não relacionado |
| Cláusula de limitação de responsabilidade para o espanhol | "que surjan de" | "derivados de" (diferença que altera o escopo) |
| "Ich verstehe nur Bahnhof" (expressão idiomática alemã) | Traduzido literalmente, incorreto | Significado idiomático correto |
Nenhum dos modelos vence de forma consistente nesses três casos: a pontuação agregada de um único modelo não prevê seu comportamento em nenhum termo ou frase específica. É também por isso que textos jurídicos e contratuais se beneficiam de uma etapa de verificação humana, independentemente de qual modelo gerou o primeiro rascunho.
E quanto à cobertura de idiomas?
Nem o ChatGPT nem o Qwen publicam uma lista verificada e confirmada de forma independente de pares de idiomas em que a qualidade da tradução cai. Ambos são modelos de uso geral com amplo treinamento multilíngue, o que é uma afirmação diferente de um desempenho de tradução medido em um conjunto específico de idiomas. O MachineTranslation.com testa e avalia a qualidade da tradução em mais de 330 idiomas diretamente, em vez de depender da capacidade linguística geral de um modelo como indicador de quão bem ele realmente traduz.
O que você não deve colar no ChatGPT ou no Qwen para tradução corporativa?
Nem o ChatGPT nem o Qwen foram criados como plataformas de tradução dedicadas, e colar conteúdo corporativo confidencial diretamente em uma interface de chat de uso geral traz as mesmas dúvidas sobre tratamento de dados que colá-lo em qualquer outra ferramenta de IA de consumo: onde a entrada é processada, se ela é retida e quem pode acessá-la. Contratos, prontuários médicos, documentos de imigração e demonstrações financeiras são exatamente o tipo de conteúdo em que vale a pena responder a essa pergunta antes de traduzir, e não depois. Esse é um motivo legítimo pelo qual uma plataforma de tradução dedicada, com práticas de tratamento de dados publicadas e verificáveis, é uma proposta diferente de uma interface de chat de uso geral, independentemente do modelo que esteja por trás de qualquer uma delas.
Como o MachineTranslation.com realmente usa ambos os modelos
O MachineTranslation.com executa o ChatGPT, o Qwen e mais de 20 outros modelos de IA em cada tradução e, em seguida, apresenta a versão com a qual esses modelos mais concordam. Considerando a nitidez com que o desempenho do Qwen e do ChatGPT diverge dependendo da direção da tradução, escolher um modelo como padrão fixo significaria errar em uma parcela previsível de pares de idiomas. O mesmo padrão dependente da direção aparece na comparação Qwen vs DeepSeek do MachineTranslation.com. Para ter uma visão completa de como os modelos atuais são testados uns contra os outros, confira os testes completos de comparação de modelos do MachineTranslation.com.
Perguntas frequentes
1. O Qwen ou o ChatGPT é melhor para tradução?
Em 98 pares de idiomas testados com um texto de origem idêntico, o ChatGPT obteve pontuações mais altas em 77 deles. O ponto mais forte do Qwen é a tradução para o inglês, onde os dois estão praticamente empatados. Em todas as outras direções, o ChatGPT vence na grande maioria dos pares; portanto, a resposta honesta depende bastante da direção em que o conteúdo está sendo traduzido.
2. O ChatGPT ou o Qwen oferece suporte a mais idiomas?
Ambos são modelos de IA de uso geral sem uma lista verificada e publicada de limitações específicas de idiomas. Nenhum dos dois publica dados de cobertura de pares de idiomas confirmados de forma independente, o que difere de uma plataforma que testa e avalia a qualidade da tradução em mais de 330 idiomas diretamente, em vez de depender de afirmações gerais sobre treinamento multilíngue.
3. O Qwen ou o ChatGPT é melhor para tradução jurídica e corporativa?
Nenhum dos dois é comprovadamente melhor em todos os cenários. Ao testar um termo de direito trabalhista alemão, o DeepSeek e o ChatGPT produziram formulações funcionais e utilizáveis, enquanto o Claude e o Qwen recorreram a um conceito jurídico não relacionado, mostrando que a divergência ocorre por termo e contexto, e não por qual modelo é genericamente mais forte.
4. O MachineTranslation.com compete com o ChatGPT e o Qwen?
Não. O MachineTranslation.com executa o ChatGPT, o Qwen e mais de 20 outros modelos de IA em cada tradução e apresenta a versão com a qual esses modelos mais concordam. Ele testa e combina modelos como esses, em vez de atuar como um modelo separado e concorrente.
5. Qual modelo devo escolher para um grande projeto de localização?
Nenhum dos dois, isoladamente, é uma opção padrão segura quando o conteúdo envolve muitos idiomas em ambas as direções. A divisão específica por direção documentada aqui significa que um modelo com bom desempenho ao traduzir para o inglês pode ter um desempenho muito diferente ao traduzir a partir dele, abrangendo dezenas de pares de idiomas ao mesmo tempo.
6. Qual modelo Qwen é o melhor para tradução?
Essa informação ainda não está disponível. O monitoramento do MachineTranslation.com atualmente registra o Qwen como um único mecanismo sem uma tag de versão do modelo, ao contrário de outros provedores; portanto, não existem dados de qualidade por subversão para apresentar. Assim que isso for corrigido, um detalhamento real entre o Qwen3.8-Max e o Qwen3.8-27B será possível; por enquanto, trata-se de uma lacuna real, e não apenas de um detalhe não mensurado.