May 8, 2026
Grok vs. Claude для перевода: что показывают бенчмарки (2026)
Grok (xAI) и Claude (Anthropic) оба являются эффективными инструментами перевода на базе ИИ, но они обладают структурно разными сильными сторонами. Для большинства общих задач перевода вы не заметите существенной разницы между ними. Для двух конкретных сценариев (перевода контента о недавних событиях и перевода официальных документов, требующих точности) разница реальна и обусловлена тем, как создавалась каждая модель.
В этой статье рассматривается, что каждая модель на самом деле предлагает для перевода, какое место им отводят независимые бенчмарки и что использовать, когда результатов работы любой из моделей самих по себе недостаточно.
Как Grok и Claude соотносятся по качеству перевода?
Краткий ответ: Claude лидирует в независимых профессиональных бенчмарках перевода. Особое преимущество Grok заключается в доступе к знаниям в реальном времени, а не в общем качестве перевода.
Во внутренних бенчмарках MachineTranslation.com Claude (уровня 3.5 Sonnet) набирает 93.8 из 100 по качеству перевода — точность, терминология и стиль в совокупности. Grok не входит в топ-14 решений в Intento's State of Translation Automation 2025, в котором оценивались 46 MT-движков и LLM в 11 языковых парах. Claude Opus 4 и Claude Sonnet 3.7 оба входят в топ-14. Источник: Внутренние бенчмарки MachineTranslation.com; Intento State of Translation Automation 2025.
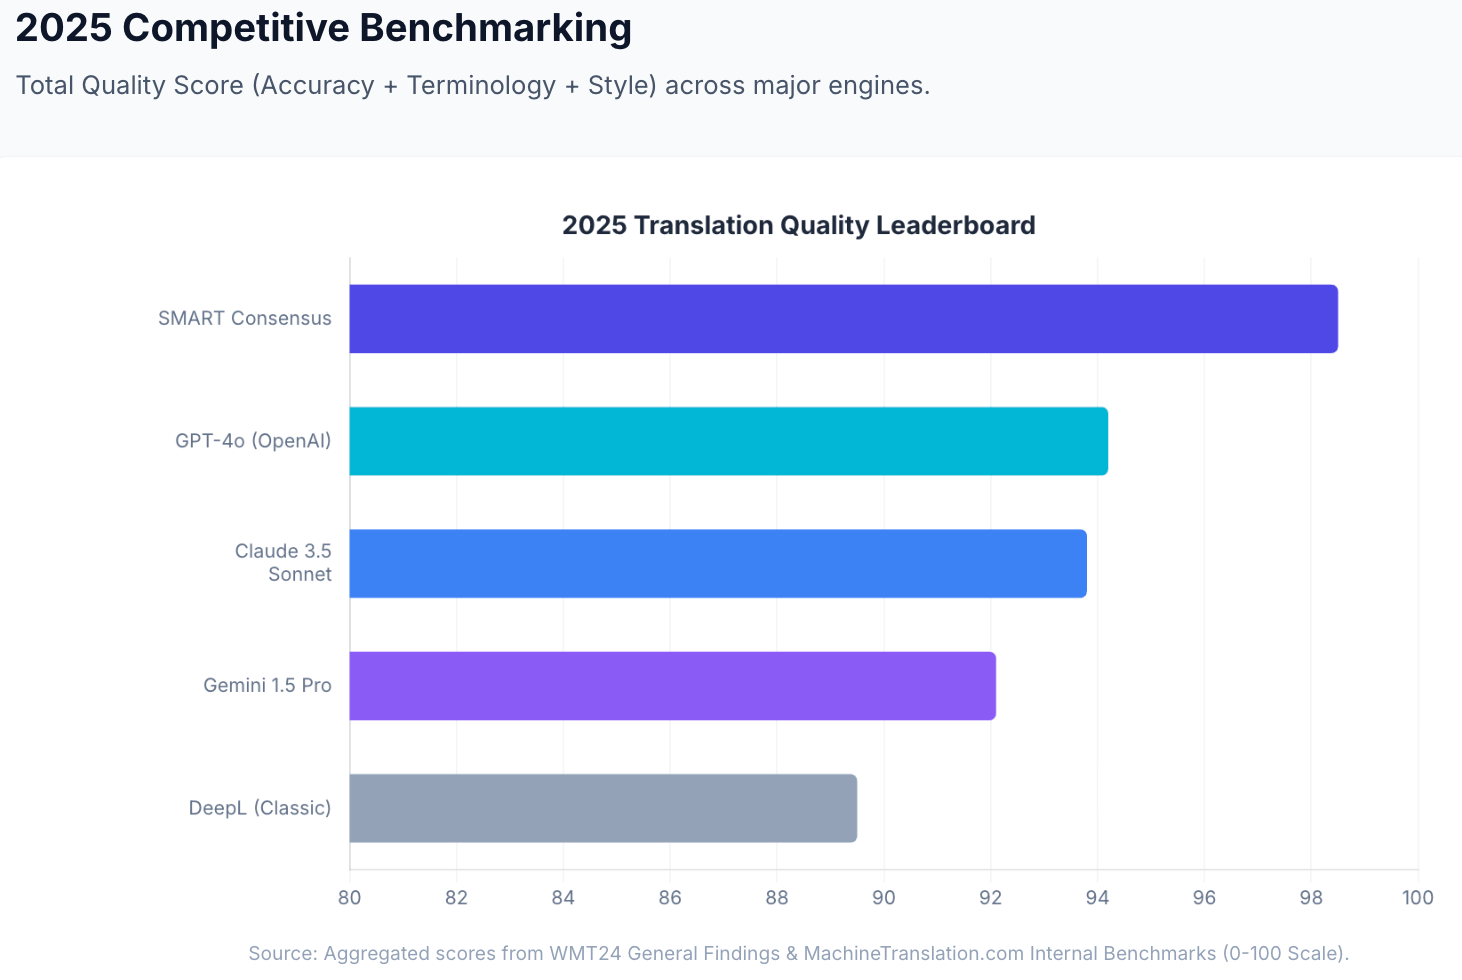
На WMT24 (главном независимом соревновании по бенчмаркингу в переводческой индустрии), Claude 3.5 занял первое место в 9 из 11 языковых пар, опередив GPT-4 и специализированные движки нейронного машинного перевода. В слепом исследовании Lokalise 2025 года, проведенном профессиональными переводчиками, 78% переводов Claude 3.5 были оценены как «хорошие» — это самый высокий результат среди всех протестированных LLM.
Grok не оценивался в WMT24 или в независимой LQA-оценке Intento на сопоставимом уровне. The Slator Pro Guide (2025) включает Grok в число LLM общего назначения, используемых для перевода в профессиональной среде, наряду с GPT и Claude, но не ставит его выше ни одной из них.
| Бенчмарк | Grok | Claude |
|---|---|---|
| Внутренняя оценка качества MachineTranslation.com | Не измерялось на уровне бенчмарка | 93.8/100 (уровень 3.5 Sonnet) |
| Топ-14 решений Intento 2025 | Нет в списке | Claude Opus 4 и Sonnet 3.7 оба внесены в список |
| Языковые пары WMT24 | Не оценивалось | 1-е место в 9/11 языковых пар |
| Слепое исследование Lokalise 2025 | Не оценивалось | 78% «хорошо» (наивысший показатель среди всех LLM) |
Источник: Внутренние бенчмарки MachineTranslation.com; Intento State of Translation Automation 2025; WMT24 General MT Findings; Lokalise 2025.
В чем заключается реальное преимущество Grok?
Перевод в реальном времени и перевод текущих событий. Определяющей архитектурной особенностью Grok является его интеграция с данными платформы X (ранее Twitter) и поиском в интернете в реальном времени. В отличие от Claude и большинства других LLMs, которые обучаются на статических наборах данных с фиксированной датой актуальности знаний, Grok интегрирует информацию в реальном времени в свои ответы. Для задач перевода, связанных с недавними событиями, недавно выпущенными продуктами, формирующейся политической терминологией, актуальными новостями или контентом, упоминающим события последних недель, Grok имеет доступ к контексту, которого нет у Claude.
Это особенно важно для: перевода новостных статей о недавних событиях, локализации анонсов продуктов для быстро меняющихся рынков, работы с недавно появившейся терминологией или сленгом, возникшими позже даты обучения других моделей, а также любого контента, смысл которого зависит от знания того, что произошло недавно.
Формирующаяся и развивающаяся терминология. Технические сферы, отрасли и культурные контексты непрерывно порождают новую терминологию. Для задач перевода, связанных с недавно появившимися терминами, новыми нормативными формулировками или новой номенклатурой продуктов, обновленное обучение и поиск в реальном времени Grok дают ему доступ к паттернам использования, которые не охватывают более старые снимки обучающих данных.
Контекстное окно и рассуждение Grok 4.1. Grok 4.1 (по состоянию на конец 2025 года) обладает контекстным окном в 131K токенов и улучшенными способностями к рассуждению, что делает его эффективным при работе со сложными, многоуровневыми документами, где важны взаимосвязи между положениями и логическая связность.
В чем Claude имеет реальное преимущество?
Качество перевода в независимых бенчмарках. Преимущество Claude подтверждено независимой профессиональной оценкой, а не собственными заявлениями. WMT24 поставил Claude 3.5 на первое место в 9 из 11 языковых пар среди всех конкурентов. Слепое исследование Lokalise 2025 года показало, что профессиональные переводчики предпочли результаты Claude 3.5 с показателем «хорошо» в 78% — выше, чем у GPT-4, DeepL и Google Translate в той же оценке. Это слепые оценки: профессиональные переводчики оценивали результаты перевода, не зная, какая модель их сгенерировала.
Конкретные языковые пары согласно Intento 2025. Claude Opus 4 и Sonnet 3.7 входят в категорию «лучших» для переводов с английского на немецкий, с английского на японский, с английского на итальянский, с английского на корейский, с английского на нидерландский, с английского на арабский и с английского на французский по результатам оценки качества перевода (LQA), проведённой специалистами Intento. Для этих пар Claude является более сильным задокументированным выбором из двух.
Точность тона и нюансированное содержание. Профессиональные переводчики в исследовании Lokalise предпочитали результаты работы Claude чаще, чем любой другой LLM — что отражает задокументированное преимущество Claude в сохранении регистра, авторского стиля и контекстуального значения. Для художественного перевода, юридических документов, официальной переписки и маркетинговых текстов, где то, как сказано, имеет не меньшее значение, чем то, что сказано, Claude стабильно демонстрирует отличные результаты в независимых оценках.
Связность длинных текстов. Claude 4.6 Sonnet поддерживает контекстное окно в 200K токенов, при этом Claude Opus 4.6 поддерживает 1M токенов в бета-версии. Для длинных официальных документов (контрактов, технических руководств, отчетов о клинических исследованиях) Claude может обработать весь документ за один проход, сохраняя единообразие терминологии на протяжении всего текста. Документы, обработанные фрагментами, демонстрируют на 28% более высокий уровень терминологической несогласованности по сравнению с обработкой документов целиком. Источник: Внутренние данные MachineTranslation.com.
Как они соотносятся по поддержке языков и стоимости?
Поддержка языков: И Grok 4.1, и Claude 4.6 поддерживают перевод на большинство основных языков мира. Claude прошел независимую оценку на европейских и восточноазиатских языковых парах с высокими результатами. Мультиязычная поддержка Grok улучшалась от версии к версии. Для малоресурсных языков качество обеих моделей снижается — проверка человеком целесообразна для контента на малоресурсных языковых парах независимо от того, какая модель используется.
Цены:
| Тариф | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Пользовательский (в месяц) | SuperGrok: $30/месяц | Claude Pro: $20/месяц |
| Вход API (за 1 млн токенов) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| Выход API (за 1 млн токенов) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Бесплатный тариф | Да (с ограничением частоты запросов через X/Grok.com) | Да (с ограничением частоты запросов через claude.ai) |
На пользовательском уровне, Claude Pro ($20/month) is cheaper than SuperGrok ($30/месяц). На уровне API Grok 4.1 имеет небольшое преимущество по стоимости перед Claude Sonnet 4.6 для рабочих процессов перевода с большим объемом входных данных.
Что лучше для конкретных типов контента?
| Тип контента | Рекомендуемая модель | Причина |
|---|---|---|
| Последние новости / текущие события | Grok | Доступ к данным в реальном времени; моделям со статическим обучением не хватает актуального контекста |
| Новая терминология / запуск новых продуктов | Grok | Интеграция с живым поиском фиксирует недавние особенности употребления |
| Официальные юридические документы | Claude | Независимая оценка WMT24 и Lokalise 2025; точность передачи тона |
| Медицинский / клинический контент | Claude | Позиции в независимых бенчмарках; сохранение языкового регистра |
| Маркетинговые тексты / креативный контент | Claude | Предпочтение в слепом исследовании Lokalise 2025; нюансы тональности |
| Техническая документация (длинная) | Claude | Окно контекста 200K-1M; согласованность терминологии по всей длине текста |
| Социальные сети / разговорный контент | Любая | Обе хорошо справляются с высокоресурсными разговорными парами |
| Интеграция для разработчиков / через API | Любая | Обе предлагают доступ к API; Grok немного дешевле по входным токенам |
Что использовать, когда одной модели недостаточно
И Grok, и Claude — это одномодельные инструменты. Каждая отдельная AI-модель (независимо от того, насколько она продвинута) допускает ошибки, которые не может обнаружить в собственном выводе. Свободный, уверенный перевод как от Grok, так и от Claude все еще может быть семантически неверным, и без перекрестной проверки узнать об этом невозможно.
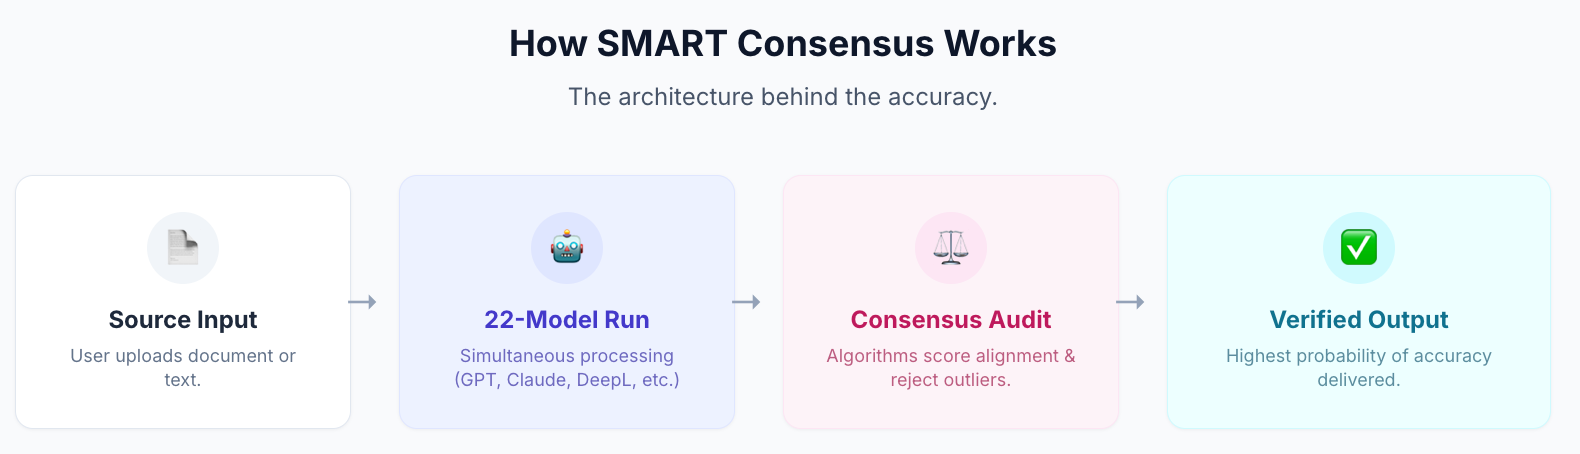
И Grok, и Claude входят в число 22 моделей в системе SMART от MachineTranslation.com. SMART запускает все 22 модели одновременно (включая Grok и Claude) и возвращает результат, с которым согласно большинство.
Что это значит для вопроса Grok против Claude: Сила Grok в режиме реального времени и контекстуальная глубина Claude способствуют достижению одного и того же консенсуса. Когда они согласны, это согласие является сильным сигналом качества.
Во внутренних бенчмарках MachineTranslation.com отдельные модели высшего уровня набирают 93-94 балла из 100 по качеству перевода. Консенсусный результат SMART достигает 98.5/100. Источник: Внутренние бенчмарки MachineTranslation.com и выводы WMT24 по общему машинному переводу.
Пользователи, перешедшие с перевода на базе одного движка на SMART, тратили на 27% меньше времени на проверку и исправление результатов. Источник: Внутренние данные MachineTranslation.com.
Для критически важного контента (юридических документов, нормативных документов, медицинских инструкций) Human Verification передает консенсус SMART сертифицированному профессиональному рецензенту в рамках той же платформы. Без внешних агентств. 100% точность гарантирована.
Переводите с помощью Grok, Claude и 20 других моделей на MachineTranslation.com — бесплатно, регистрация не требуется.
Часто задаваемые вопросы
1. Grok лучше, чем Claude, для перевода?
Для большинства стандартных задач перевода Claude лидирует в независимых бенчмарках: первое место в 9 из 11 языковых пар на WMT24, 78% оценок «хорошо» в слепом исследовании Lokalise 2025 года и 93.8/100 во внутренних бенчмарках качества MachineTranslation.com. Особое преимущество Grok заключается в работе с контентом, требующим знания текущих событий: доступ к данным в реальном времени дает ему контекст, которого нет у статически обученных моделей, включая Claude. Для последних новостей, новой терминологии и актуального контента Grok — более сильный выбор.
2. В чем преимущество Grok перед Claude для перевода?
Grok интегрирует данные в реальном времени из X (ранее Twitter) и поиск в интернете в реальном времени. В отличие от Claude и большинства других LLM, обученных на статических наборах данных, Grok может получать доступ к информации о недавних событиях, недавно появившейся терминологии и текущем контексте при генерации переводов. Это делает его особенно эффективным при переводе новостного контента, недавно выпущенных продуктов и любых материалов, смысл которых зависит от событий или языковых паттернов последних нескольких недель.
3. В чем преимущество Claude перед Grok для перевода?
Преимущество Claude подтверждено независимой профессиональной оценкой. Claude 3.5 занял первое место в 9 из 11 языковых пар на WMT24, а профессиональные переводчики в слепом исследовании Lokalise 2025 года предпочли его результаты с оценкой «хорошо» в 78% случаев — это самый высокий показатель среди всех протестированных LLM. Claude также входит в топ-14 решений Intento для нескольких языковых пар по результатам человеческой оценки LQA, в то время как Grok — нет. Для официальных, профессиональных и высокоответственных задач перевода положение Claude в независимых бенчмарках является задокументированным отличительным фактором.
4. Что лучше для юридического перевода, Grok или Claude?
Claude — более предпочтительный выбор для юридического перевода на основе независимой оценки. Claude 3.5 занял первое место в большинстве высокоресурсных европейских языковых пар на WMT24 и получил наивысшие оценки предпочтений от профессиональных переводчиков в ходе слепого исследования. Для юридического контента, требующего заверенной точности, ни одной из моделей по отдельности недостаточно — функция Human Verification от MachineTranslation.com обеспечивает 100% точность от сертифицированного профессионального рецензента на той же платформе, без привлечения сторонних подрядчиков.
5. Доступны ли Grok и Claude на MachineTranslation.com?
Да. Оба входят в число 22 моделей в системе SMART от MachineTranslation.com. Каждый перевод SMART одновременно запускает Grok, Claude и 20 других моделей, возвращая результат, одобренный большинством. Вместо того чтобы выбирать между ними, вы получаете консенсус всех ИИ-моделей.
6. Как Grok и Claude соотносятся по цене?
На потребительском уровне Claude Pro стоит $20/month versus SuperGrok at $30 в месяц. На уровне API, Grok 4.1 немного дешевле по входным токенам ($2/M vs. $3/M для Claude Sonnet 4.6) и выходным ($10/M vs. $15/M). Бесплатный тариф MachineTranslation.com включает обе модели в рамках консенсуса SMART из 22 моделей, регистрация не требуется.
7. Какая ИИ-модель лучше всего подходит для перевода новостных статей?
Для перевода новостных статей Grok имеет структурное преимущество: его интеграция данных в реальном времени означает, что он обладает актуальным контекстом описываемых событий, которого может не хватать статически обученным моделям. Для перевода общих новостей, где актуальность не критична, показатели Claude в бенчмарках выше. Для перевода больших объемов новостей, где важны как актуальность, так и точность, SMART от MachineTranslation.com запускает обе модели и возвращает их согласованный результат.