October 2, 2026
Qwen vs Grok: Koji AI model bolje prevodi?
Qwen i Grok su AI modeli opšte namene, a ne alati specifični za prevođenje, i oba su deo skupa modela koje MachineTranslation.com pokreće za svaki prevod. To je važno za razumevanje onoga što sledi. Ovo je pregled toga kako se dva sopstvena modela platforme pokazuju jedan protiv drugog, uz stvarne ograde koje prate takvu vrstu podataka, a ne takmičenje između dva spoljna izazivača i same platforme.
Šta su Qwen i Grok?
Qwen je Alibabina porodica velikih jezičkih modela, trenutno u svojoj Qwen3.8 generaciji, i dodata je u skup modela na MachineTranslation.com kao deo kontinuiranog širenja platforme. Grok je linija modela kompanije xAI, koja je u trenutku pisanja ovog teksta trenutno na verziji Grok 4.7, prošavši kroz nekoliko izdanja od verzije koju je ovaj članak prvobitno upoređivao, i platformi se pridružila odvojeno. Nijedan model nije napravljen specifično za prevođenje. Oba su sistemi opšte namene koji slučajno rukuju mnogim jezicima kao delom šire jezičke sposobnosti, što je drugačija polazna tačka od platforme izgrađene i testirane specifično za kvalitet prevoda.
Kako se Qwen i Grok porede na sopstvenim podacima platforme MachineTranslation.com?
Tokom poslednjih 28 dana saobraćaja na platformi, Grok je u proseku postigao bolji rezultat od modela Qwen: 9.26 od 10 u poređenju sa 8.87. Grokovih 10% najlošije ocenjenih prevoda i dalje je imalo prosek od 9.2, dok je Qwenovih najlošijih 10% palo na 7.6, što je veći jaz na donjoj granici nego što bi sam prosek sugerisao.
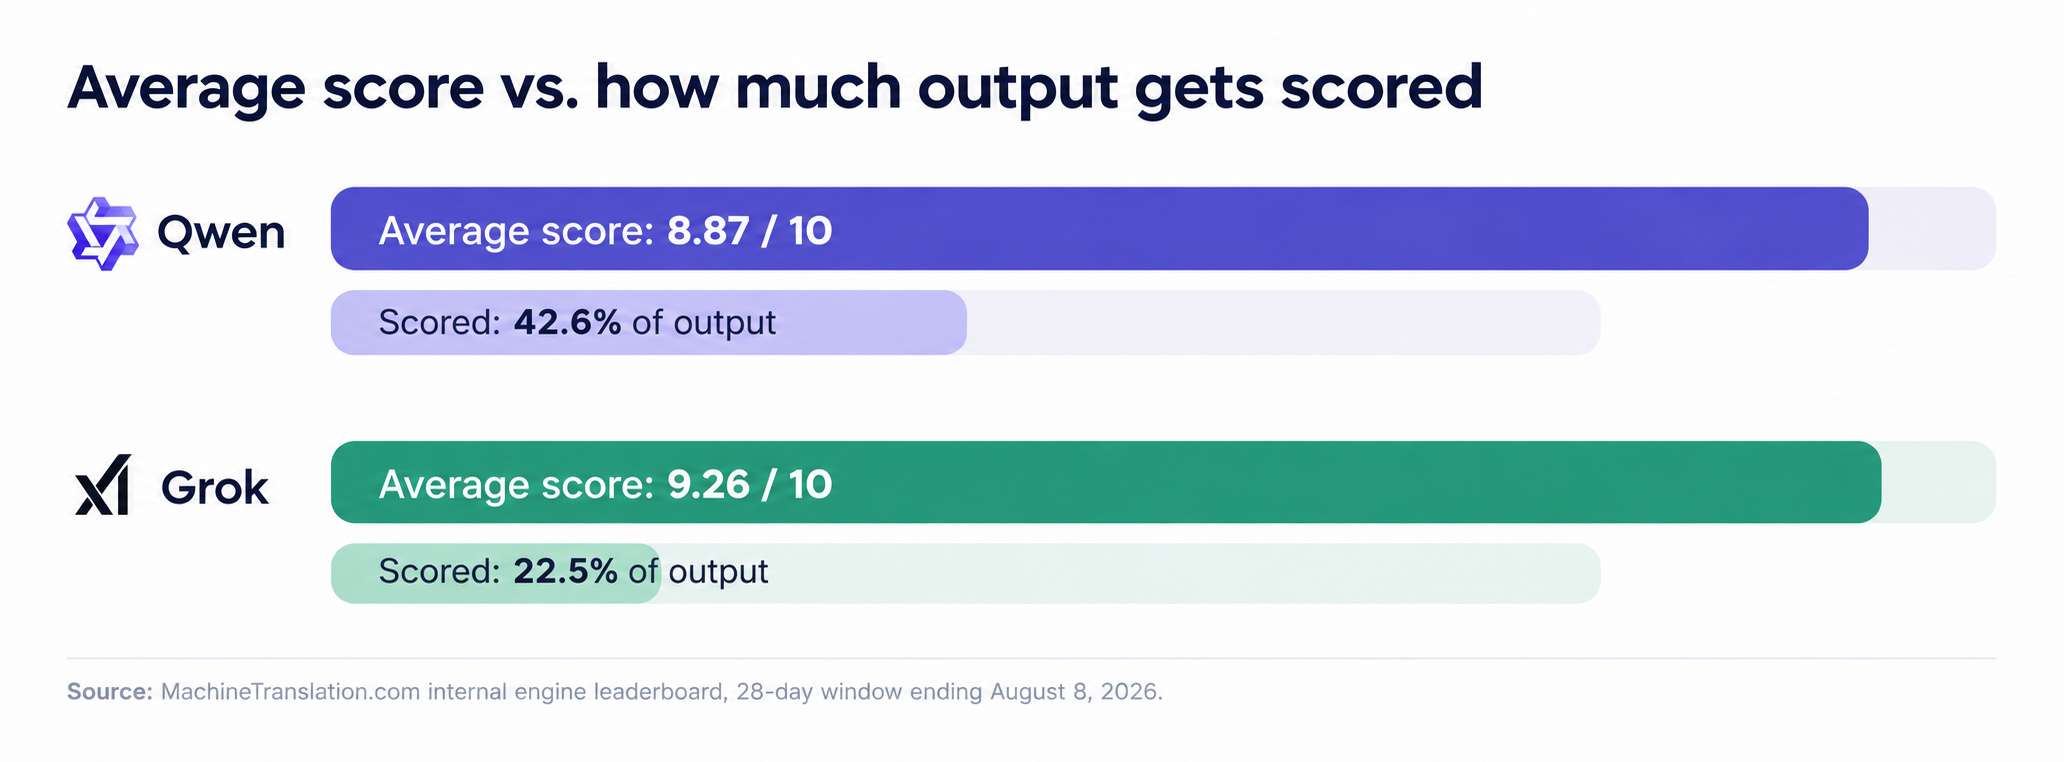
Grokov prosečan rezultat je viši, ali se zasniva na ocenjivanju manje od četvrtine njegovog izlaza, u poređenju sa skoro polovinom za Qwen. Ova dva stupca pričaju različite delove iste priče.
| Qwen | Grok | |
|---|---|---|
| Procenat ocenjenog izlaza | 42.6% | 22.5% |
| Prosečna ocena | 8.87 / 10 | 9.26 / 10 |
| Najnižih 10% ocena | 7.6 | 9.2 |
Izvor: Interna rang-lista endžina na MachineTranslation.com, 28-dnevni period koji se završava 8. avgusta 2026.
Da li to što Grok ima višu ocenu znači da je on bolji izbor?
Samo po sebi, ne. Grok se na platformi koristi mnogo ređe nego Qwen, i manje od četvrtine njegovih prevoda uopšte dobije ocenu, u poređenju sa skoro polovinom onih koje napravi Qwen. Manji, manje reprezentativan uzorak može učiniti da prosek izgleda bolje ili lošije nego što bi to bio na istom obimu koji ima Qwen. Izveštavanje same platforme MachineTranslation.com o ovim podacima tretira pokrivenost ocenjivanjem kao pravo ograničenje, a ne kao fusnotu: endžin koji je ocenjen na uskom segmentu svog saobraćaja nije testiran tako temeljno kao onaj koji je ocenjen na skoro polovini svojih rezultata.
Iskreno tumačenje je da su brojke za Grok obećavajuće, ali oskudnije. Brojke za Qwen su u proseku niže, ali počivaju na mnogo većoj, reprezentativnijoj osnovi. Nijedna od ovih činjenica ne poništava onu drugu.
Šta je sa jezičkom pokrivenošću?
Ni Qwen ni Grok ne objavljuju proverenu listu jezičkih parova kod kojih performanse opadaju, a ne postoji ni nezavisno testiranje koje bi je potvrdilo. Ono što se sa sigurnošću može reći jeste da nijedan model nije izgrađen oko kvaliteta prevoda na određenom skupu jezika na način na koji to jeste namenska platforma za prevođenje. MachineTranslation.com direktno testira i podržava preko 270 jezika, što je drugačija vrsta tvrdnje u odnosu na široku, ali netestiranu višejezičnu sposobnost modela opšte namene.
Kako MachineTranslation.com zapravo koristi Qwen i Grok
MachineTranslation.com pokreće Qwen, Grok i više od 20 drugih AI modela za svaki prevod, a zatim izdvaja verziju oko koje se ti modeli najviše slažu. Nijedan model nije isključen zato što u proseku ima nižu ocenu. Pokretanje više modela odjednom znači hvatanje slučajeva u kojima model sa nižom prosečnom ocenom ipak tačno prevede određenu rečenicu koju model sa višom ocenom promaši. Performanse modela Qwen se takođe razlikuju u zavisnosti od smera i jezičkog para na načine koje je korisno znati pre nego što odaberete samo jedan model, što je detaljnije obrađeno u poređenju modela Qwen i DeepSeek na MachineTranslation.com. Za detaljniji pregled toga kako se modeli direktno testiraju jedni protiv drugih, pogledajte kompletno testiranje i poređenje modela na platformi MachineTranslation.com.
Često postavljana pitanja
1. Da li je za prevođenje bolji Qwen ili Grok?
Na osnovu sopstvenih 28-dnevnih podataka o mehanizmima na MachineTranslation.com, Grok u proseku ostvaruje višu ocenu od Qwen-a, 9.26 u odnosu na 8.87 od 10. Međutim, Grok se ocenjuje na mnogo manjem, manje reprezentativnom delu svog izlaza, tako da ovo nije čisto direktno poređenje kao što bi to bio test uparenih segmenata.
2. Zašto Grok ima višu prosečnu ocenu, ali manje ocenjenih prevoda?
Grok se ređe koristi na platformi i samo oko 22.5% njegovog izlaza se ocenjuje, naspram 42.6% za Qwen. Manji, manje reprezentativan uzorak može veštački povećati ili umanjiti prosek, zbog čega bi ovo poređenje trebalo shvatiti kao orijentaciono, a ne definitivno.
3. Da li Qwen ili Grok podržava više jezika?
Oba su AI modeli opšte namene bez objavljene, verifikovane liste ograničenja specifičnih za jezike. Nijedan od njih nije napravljen isključivo za prevođenje, što se razlikuje od platforme koja direktno testira i ocenjuje kvalitet prevoda na 270+ jezika, umesto da se oslanja na široko višejezično obučavanje kao zamenu za izmerene performanse prevođenja.
4. Da li je MachineTranslation.com konkurencija Qwen-u i Grok-u?
Ne. MachineTranslation.com pokreće Qwen, Grok i više od 20 drugih AI modela za svaki prevod i prikazuje verziju oko koje se ti modeli najviše slažu. On testira i kombinuje ovakve modele umesto da se takmiči sa njima kao zaseban, sopstveni model.
5. Koji AI model MachineTranslation.com preporučuje za prevođenje?
Nijedan podrazumevano. Različiti modeli ostvaruju različite rezultate prema jezičkom paru i vrsti sadržaja, a razlika između njih može ići u bilo kom smeru u zavisnosti od toga šta se prevodi. Ta varijacija je upravo razlog zašto platforma pokreće više modela za svaki prevod, umesto da izabere jedan kao trajnu preporuku.