September 25, 2026
Från GPT-3 till GPT-5: Hur kvaliteten på AI-översättning faktiskt förändrades
Det skiljer fem år och flera arkitekturgenerationer mellan GPT-3, GPT-4 och GPT-5, men den relevanta frågan för översättning är inte ”vilken är smartast”. Den är snävare: vad förändrades egentligen i hur dessa modeller hanterar de delar av ett språk som inte kan översättas ord för ord, sådant som idiom, flertydighet och stilnivå? Förbättringen skedde på specifika områden, vid specifika tidpunkter, och den följde inte en rak linje från äldre till nyare.
Vad GPT-3 faktiskt erbjöd för översättning
OpenAI släppte GPT-3 år 2020, innan MachineTranslation.com:s eget testprogram fanns, så ingenting här är ett proprietärt prestandatest. Det är väldokumenterad historia, inte ett internt testresultat. GPT-3 var den första modellen i sitt slag som kunde producera flytande, mänskligt klingande text på flera språk utan uppgiftsspecifik träning, vilket gjorde den till en verklig milstolpe. För översättning i synnerhet skapade samma flyt en reell risk: GPT-3 kunde generera en självsäker, välformulerad mening på målspråket som ändå var felaktig, utan att något i resultatet signalerade att ett misstag hade skett.
Vad som förändrades när GPT-4 kom
GPT-4 lanserades i March 2023, och MachineTranslation.com:s egna modelltester tar vid runt denna generation. Förbättringen var påtaglig men ojämn. Vid testning av den mångtydiga engelska frasen ”That's sick” på japanska var GPT-4.1-nano den enda av sex testade modeller som reducerade frasens medvetna dubbeltydighet till en enda tolkning, medan de övriga fem bevarade den tvetydighet som originalfrasen avsåg. Idiom var en större svaghet: när det spanska idiomet ”llevarse el gato al agua” kördes genom fem GPT-versioner samtidigt gav både de mindre GPT-4o-mini och GPT-4.1-nano samma ordagranna, felaktiga översättning och missade idiomet helt.
Samma mönster visade sig på andra håll. Ett tyskt idiom, ”ich verstehe nur Bahnhof”, som kördes genom åtta underversioner av GPT och Claude, översattes ordagrant och felaktigt av just GPT-4o-mini, medan en mindre, nyare modell i samma test, GPT-4.1-nano, klarade det. Generation och modellstorlek motsvarade inte varandra på något konsekvent sätt, ett mönster som MachineTranslation.com:s tester av modellversioner behandlar mer ingående.
Vad GPT-5 förändrade för översättning
OpenAI introducerade GPT-5 som ett enhetligt system som dirigerar mellan en snabb standardmodell och en djupare resonerande modell beroende på uppgift, en strukturell förändring från GPT-4:s enmodellskonstruktion. OpenAI:s eget GPT-5 System Card rapporterar att modellens övergripande faktamässiga felfrekvens är ungefär 45% lägre än GPT-4:s och 80% lägre än GPT-3:s, en generell tillförlitlighetsvinst som visar sig specifikt även för översättning. MachineTranslation.com:s tester visar de tydligaste framstegen där modellerna från GPT-4-eran hade det som svårast: på samma spanska idiom som GPT-4o-mini och GPT-4.1-nano misslyckades med landade både GPT-5.4-mini och GPT-5.4 på korrekta, idiomatiska översättningar, där båda formulerade sig något annorlunda men båda förstod själva idiomet.
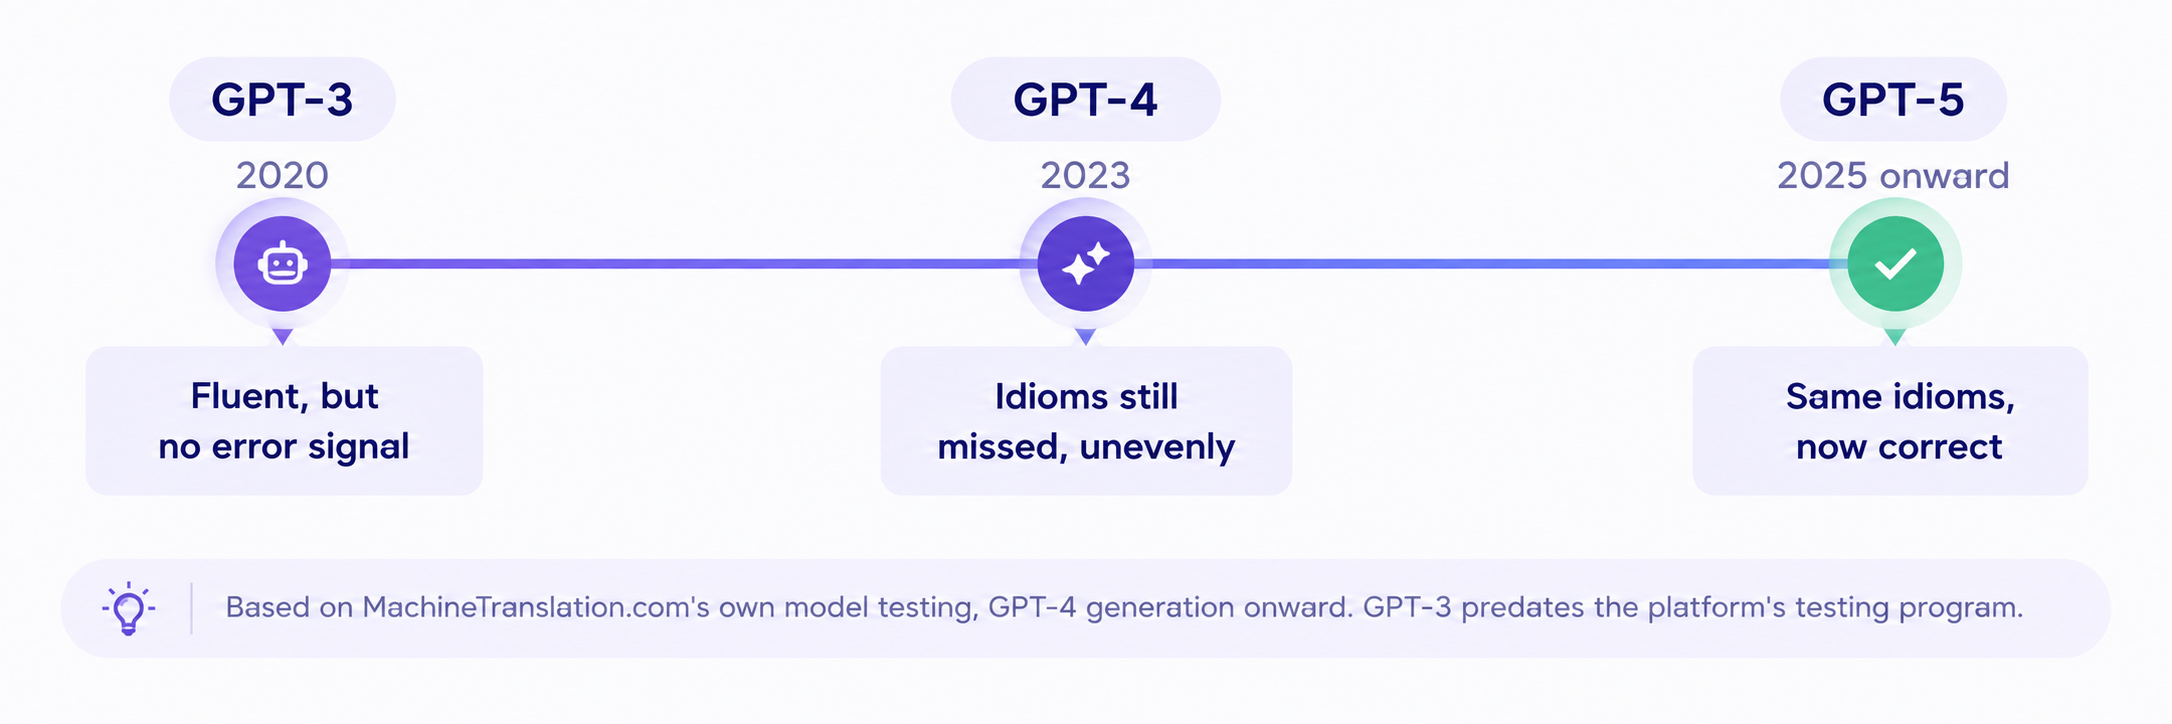
Klyftan mellan generationerna var inte en jämn uppförsbacke. Den var nästan helt koncentrerad till idiomatiskt och tvetydigt språk. På okomplicerad text presterar modeller från GPT-4-eran och GPT-5-eran nästintill identiskt.
| GPT-3 | GPT-4 | GPT-5 | |
|---|---|---|---|
| Lanserades | 2020 | March 2023 | 2025, nu på GPT-5.4/5.5 |
| Tillgänglig idag | Nej, avvecklad | Endast API, avvecklad från ChatGPT | Ja, nuvarande generation |
| Hantering av idiom | Inte testad av MachineTranslation.com (föregick programmet) | Inkonsekvent; missade flera idiom helt | Hanterade de idiom som GPT-4 missade korrekt |
| Standardiserad affärstext | Inte testad av MachineTranslation.com | Stark, nästintill identisk med senare modeller | Stark, nästintill identisk med GPT-4 |
Den sista punkten har betydelse: ett separat test av en vanlig affärsfras, "please confirm receipt of this document", översatt till tyska, gav nästintill identiska resultat för alla testade modeller, inklusive GPT-4o-mini och modeller från GPT-5-generationen. Generationsklyftan gäller specifikt bildligt och tvetydigt språk, inte en generell kvalitetsskillnad.
Innebär en nyare GPT-generation alltid bättre översättning?
Nej. Vid testning av ett hebreiskt idiom över olika modellfamiljer landade GPT-5.4-mini och GPT-5.4 på två olika, ofullständiga tolkningar av samma fras, ingen av dem helt korrekt, medan en äldre, orelaterad modell kom närmare. En nyare modell är inte automatiskt mer exakt, och en större eller nyare modell är inte automatiskt det säkrare valet för en given mening.
Var GPT-5 står inom översättning idag
GPT-3 och GPT-4 har båda tagits ur bruk i ChatGPT; GPT-4 är endast tillgänglig via OpenAI:s API för befintliga integrationer. Den nuvarande generationen, GPT-5.4 och GPT-5.5, är vad MachineTranslation.com kör idag, och den presterar konkurrenskraftigt mot aktuella modeller från andra leverantörer, även om den inte är entydigt bättre på alla språkpar. För en närmare titt på hur aktuella GPT-underversioner står sig mot varandra och mot modeller som Claude och DeepSeek, se MachineTranslation.com:s direkta jämförelsetester av underversioner, som går djupare än vad en generationsöversikt kan göra.
Vad detta innebär om du lokaliserar i stor skala
Den upptäckt som har störst betydelse för ett omfattande lokaliseringsprogram är inte att ”GPT-5 slår GPT-3”. Det är att modellversionen, inte bara modellfamiljen, avgör om ett specifikt idiom eller en tvetydig fras översätts korrekt, och det gäller för alla språkpar, inte bara för det fåtal som visas här. Detta är viktigast för innehåll som i grunden bygger på ton och bildligt språk, särskilt marknadsföringstexter och användargenererat innehåll, där ett enda idiom som översätts bokstavligt kan förändra hela innebörden i ett inlägg eller en annons. Ett program som översätter innehåll till dussintals språk kommer att stöta på exakt denna typ av språk i vart och ett av dem. MachineTranslation.com:s testserie av underversioner och fullständiga modelljämförelsetester behandlar detta mer ingående. Plattformens tillvägagångssätt, att köra aktuella GPT-modeller parallellt med fler än 20 andra vid varje översättning, finns specifikt för att ingen enskild modells versionshistorik i sig är en tillräckligt tillförlitlig garanti.
Vanliga frågor
1. Vad är den egentliga skillnaden mellan GPT-3, GPT-4 och GPT-5 för översättning?
GPT-3 hanterade okomplicerad text rimligt väl, men hade stora problem med allt som var idiomatiskt eller tvetydigt. GPT-4 minskade den klyftan avsevärt, men reducerade ändå vissa genuint tvetydiga fraser till en enda betydelse istället för att bevara tvetydigheten. GPT-5:s senare underversioner hanterade idiom korrekt som tidigare modeller från GPT-4-eran översatte bokstavligt och felaktigt.
2. Är GPT-5 alltid bättre än GPT-4 på översättning?
Nej. MachineTranslation.com:s egna tester har visat fall där en mindre, nyare underversion presterade bättre än en större, äldre, och kvalitetsskillnaden mellan generationerna tenderar att vara specifik för idiomatiskt eller bildligt språk snarare än en generell förbättring över hela linjen.
3. Erbjuder OpenAI fortfarande GPT-3 eller GPT-4?
Nej. Båda har tagits ur bruk i ChatGPT och ersatts av nyare modeller från GPT-5-generationen. GPT-4 förblir endast tillgänglig via OpenAI:s API för befintliga integrationer, inte som ett aktuellt alternativ för konsumenter.
4. Vilken GPT-version använder MachineTranslation.com?
MachineTranslation.com kör aktuella modeller från GPT-5-generationen (GPT-5.4 och GPT-5.5, beroende på abonnemangsnivå) parallellt med fler än 20 andra AI-modeller vid varje översättning, snarare än att förlita sig enbart på GPT.
5. Hur står sig GPT-5 jämfört med andra aktuella AI-modeller för översättning?
Modeller från GPT-5-generationen presterar konkurrenskraftigt men inte genomgående bättre än modeller som Claude, Gemini eller DeepSeek. Olika modeller vinner på olika språkpar och innehållstyper, vilket är anledningen till att MachineTranslation.com testar dem direkt mot varandra i stället för att välja en som standard.