May 8, 2026
Grok dhidi ya Claude kwa ajili ya tafsiri: kile ambacho vipimo vya utendaji vinaonyesha (2026)
Grok (xAI) na Claude (Anthropic) zote mbili ni zana zenye uwezo za tafsiri za AI, lakini zina nguvu tofauti kimuundo. Kwa kazi nyingi za tafsiri ya jumla, hautaona tofauti kubwa kati yao. Kwa mazingira mawili mahususi (kutafsiri maudhui kuhusu matukio ya hivi karibuni, na kutafsiri nyaraka rasmi zinazohitaji usahihi), tofauti hiyo ni halisi na inatokana na jinsi kila model ilivyoundwa.
Makala hii inaeleza kile ambacho kila model inatoa hasa kwa ajili ya tafsiri, ambapo benchmarks huru zinaziweka, na nini cha kutumia wakati matokeo ya model yoyote pekee hayatoshi.
Je, Grok na Claude zinalinganaje katika ubora wa tafsiri?
Jibu fupi: Claude inaongoza katika vigezo huru vya ulinganishaji vya tafsiri ya kitaalamu. Faida mahususi ya Grok ni ufikiaji wa maarifa wa wakati halisi, na si ubora wa jumla wa tafsiri.
Katika vigezo vya ndani vya MachineTranslation.com, Claude (daraja la 3.5 Sonnet) hupata alama 93.8 kati ya 100 kwenye ubora wa tafsiri — usahihi, istilahi, na mtindo kwa pamoja. Grok haionekani kwenye suluhisho 14 bora katika State of Translation Automation 2025 ya Intento, ambayo ilitathmini injini 46 za MT na LLMs katika jozi 11 za lugha. Claude Opus 4 na Claude Sonnet 3.7 zote mbili zinaonekana kwenye 14 bora. Chanzo: Vigezo vya ndani vya utendaji vya MachineTranslation.com; Intento State of Translation Automation 2025.
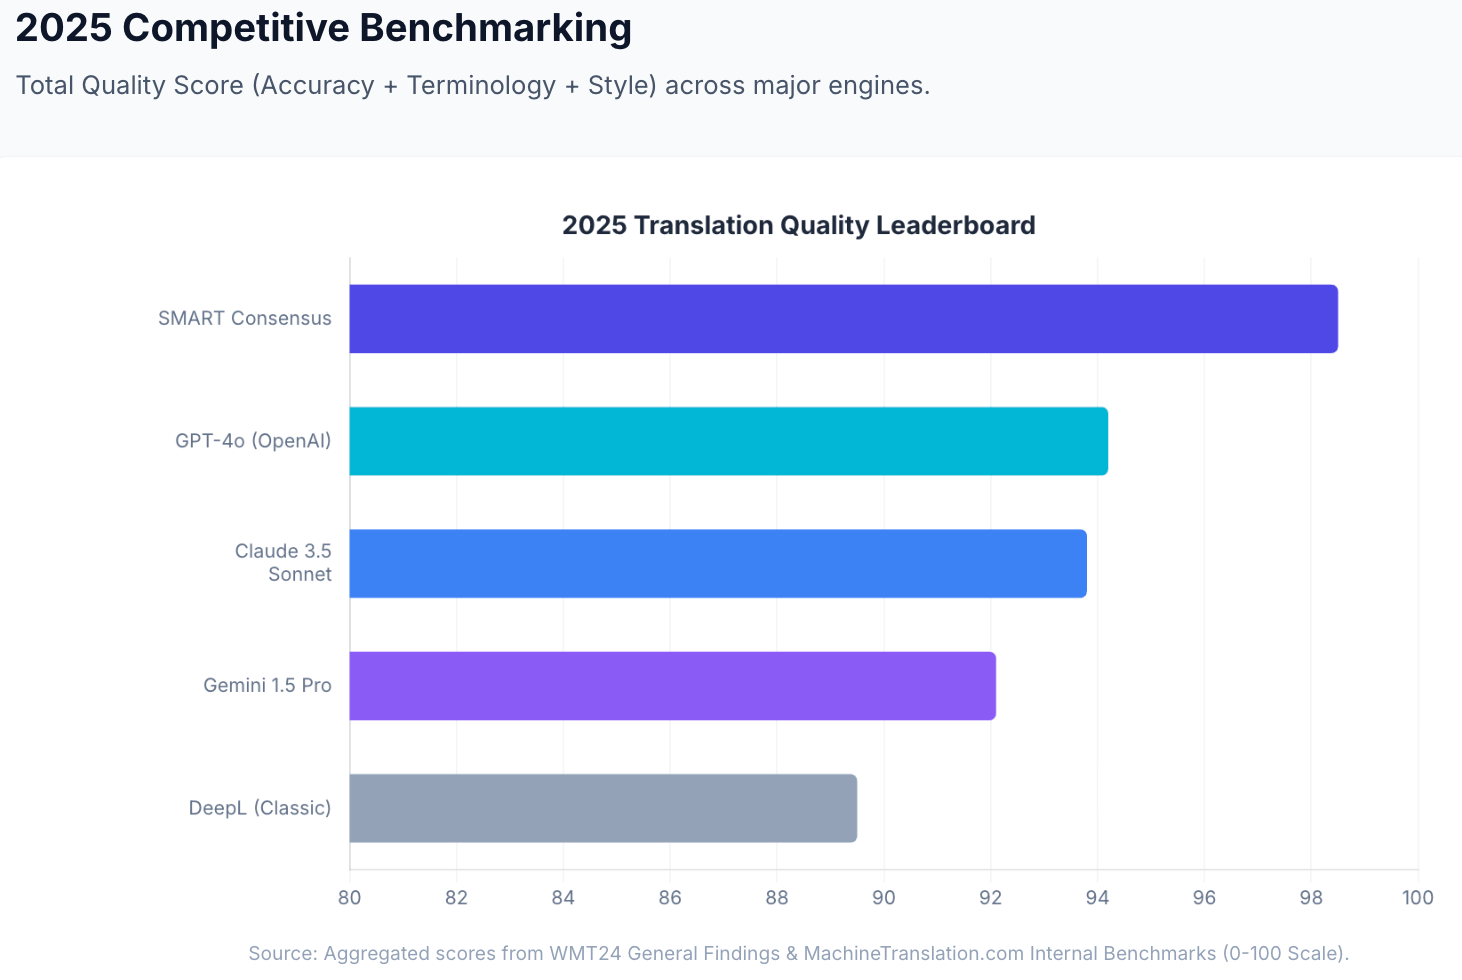
Katika WMT24 (mashindano makuu huru ya vigezo vya utendaji katika sekta ya tafsiri), Claude 3.5 ilishika nafasi ya kwanza katika jozi 9 kati ya 11 za lugha, mbele ya GPT-4 na injini maalum za neural MT. Katika utafiti wa upofu wa Lokalise wa 2025 uliofanywa na watafsiri wa kitaalamu, 78% ya tafsiri za Claude 3.5 zilitathminiwa kuwa nzuri — ya juu zaidi kati ya LLM yoyote iliyofanyiwa majaribio.
Grok haijatathminiwa katika WMT24 au tathmini huru ya LQA ya Intento katika kiwango kinacholingana. Slator Pro Guide (2025) inataja Grok kama mojawapo ya LLMs za madhumuni ya jumla zinazotumiwa kwa tafsiri katika mazingira ya kitaalamu, pamoja na GPT na Claude, lakini haiiweki juu ya yoyote kati ya hizo.
| Benchmark | Grok | Claude |
|---|---|---|
| Alama ya ubora wa ndani ya MachineTranslation.com | Haijapimwa katika kiwango cha benchmark | 93.8/100 (daraja la 3.5 Sonnet) |
| Suluhisho 14 bora za Intento 2025 | Haijaorodheshwa | Claude Opus 4, Sonnet 3.7 zote zimeorodheshwa |
| Jozi za lugha za WMT24 | Haijatathminiwa | Ya 1 katika jozi 9/11 za lugha |
| Utafiti wa upofu wa Lokalise 2025 | Haijatathminiwa | 78% nzuri (ya juu zaidi kuliko LLM yoyote) |
Chanzo: Vigezo vya ndani vya MachineTranslation.com; Hali ya Uendeshaji Kiotomatiki wa Tafsiri ya Intento 2025; Matokeo ya Jumla ya MT ya WMT24; Lokalise 2025.
Ni wapi ambapo Grok ina faida ya kweli?
Tafsiri ya muda halisi na ya matukio ya sasa. Sifa inayobainisha usanifu wa Grok ni kuunganishwa kwake na data ya jukwaa la X (zamani Twitter) na utafutaji wa moja kwa moja wa intaneti. Tofauti na Claude na LLMs nyingine nyingi, ambazo zimefunzwa kwenye seti tuli za data zenye ukomo maalum wa maarifa, Grok hujumuisha taarifa za wakati halisi katika matokeo yake. Kwa kazi za tafsiri zinazohusisha matukio ya hivi karibuni, bidhaa zilizozinduliwa hivi karibuni, istilahi za kisiasa zinazoibuka, habari za sasa, au maudhui yanayorejelea mambo yaliyotokea katika wiki chache zilizopita, Grok ana uwezo wa kufikia muktadha ambao Claude hana.
Hili ni muhimu hasa kwa: kutafsiri makala za habari kuhusu matukio ya hivi karibuni, kutohoa matangazo ya bidhaa kwa ajili ya masoko yanayobadilika haraka, kushughulikia istilahi mpya zilizobuniwa au lugha ya mitaani inayokuja baada ya data ya mafunzo ya miundo mingine, na maudhui yoyote ambayo maana yake inategemea kujua kilichotokea hivi karibuni.
Istilahi zinazoibuka na zinazobadilika. Nyanja za kiufundi, viwanda, na miktadha ya kitamaduni huendelea kuzalisha istilahi mpya. Kwa kazi za tafsiri zinazohusisha maneno yaliyobuniwa hivi karibuni, lugha mpya ya udhibiti, au istilahi mpya za bidhaa, mafunzo yaliyosasishwa ya Grok na utafutaji wa muda halisi huipa uwezo wa kufikia mifumo ya matumizi ambayo snapshots za zamani za data ya mafunzo hazizinasi.
context window na reasoning ya Grok 4.1. Grok 4.1 (kufikia mwishoni mwa 2025) ina context window ya token 131K na uwezo ulioboreshwa wa kufikiri kwa mantiki, na kuifanya iwe na uwezo kwenye nyaraka tata zenye tabaka nyingi ambapo uhusiano wa vifungu na mshikamano wa kimantiki ni muhimu.
Ni wapi ambapo Claude ina faida ya kweli?
Ubora wa tafsiri kwenye benchmarks huru. Faida ya Claude imethibitishwa na tathmini huru ya kitaalamu badala ya madai ya kujiripoti. WMT24 iliweka Claude 3.5 katika nafasi ya kwanza kwenye jozi 9 kati ya 11 za lugha dhidi ya washindani wote. Utafiti wa upofu wa Lokalise wa 2025 uligundua kuwa watafsiri wa kitaalamu walipendelea matokeo ya Claude 3.5 kwa kiwango cha nzuri cha 78% — juu zaidi kuliko GPT-4, DeepL, na Google Translate katika tathmini hiyo hiyo. Hizi ni tathmini za upofu: watafsiri wa kitaalamu walitathmini matokeo bila kujua ni modeli gani iliyoyazalisha.
Jozi mahususi za lugha kulingana na Intento 2025. Claude Opus 4 na Sonnet 3.7 zinaonekana katika kitengo cha bora kwa Kiingereza hadi Kijerumani, Kiingereza hadi Kijapani, Kiingereza hadi Kiitaliano, Kiingereza hadi Kikorea, Kiingereza hadi Kiholanzi, Kiingereza hadi Kiarabu, na Kiingereza hadi Kifaransa katika tathmini ya kibinadamu ya LQA ya Intento. Kwa jozi hizi, Claude ndiye chaguo thabiti zaidi lililoandikwa kati ya mbili hizo.
Usahihi wa toni na maudhui yenye nuances. Watafsiri wa kitaalamu katika utafiti wa Lokalise walipendelea matokeo ya Claude kwa kiwango cha juu zaidi kuliko LLM yoyote — ikionyesha uwezo uliothibitishwa wa Claude katika kuhifadhi rejista, sauti ya mwandishi, na maana ya muktadha. Kwa tafsiri ya kifasihi, nyaraka za kisheria, mawasiliano rasmi, na nakala za masoko ambapo jinsi jambo linavyosemwa ni muhimu sawa na kile kinachosemwa, Claude hufanya vizuri mara kwa mara katika tathmini huru.
Ushikamano wa nyaraka ndefu. Claude 4.6 Sonnet inaunga mkono context window ya token 200K, huku Claude Opus 4.6 ikiunga mkono token 1M kwenye beta. Kwa nyaraka ndefu rasmi (mikataba, miongozo ya kiufundi, ripoti za majaribio ya kliniki), Claude anaweza kuchakata waraka mzima kwa mkupuo mmoja, akidumisha uthabiti wa istilahi kote. Nyaraka zilizochakatwa kwa vipande zinaonyesha kiwango cha juu cha 28% cha kutofautiana kwa istilahi ikilinganishwa na uchakataji wa hati nzima. Chanzo: Data ya ndani ya MachineTranslation.com.
Je, zinalingana vipi kuhusu usaidizi wa lugha na bei?
Usaidizi wa lugha: Zote mbili Grok 4.1 na Claude 4.6 zinasaidia tafsiri katika lugha nyingi kuu duniani. Claude imetathminiwa kwa kujitegemea katika jozi za lugha za Ulaya na Asia Mashariki na kupata matokeo thabiti. Usaidizi wa lugha nyingi wa Grok umeimarika katika matoleo yanayofuatana. Kwa lugha zenye rasilimali chache, mifano yote miwili hupungua ubora — ukaguzi wa kibinadamu unafaa kwa maudhui katika jozi za lugha zenye rasilimali chache bila kujali ni mfano gani unaotumiwa.
Bei:
| Mpango | Grok (xAI) | Claude (Anthropic) |
|---|---|---|
| Mtumiaji (kila mwezi) | SuperGrok: $30/mwezi | Claude Pro: $20/mwezi |
| Ingizo la API (kwa kila tokeni M) | Grok 4.1: $2 | Sonnet 4.6: $3 |
| Matokeo ya API (kwa kila tokeni M) | Grok 4.1: $10 | Sonnet 4.6: $15 |
| Kiwango cha bila malipo | Ndiyo (kikomo cha kasi kupitia X/Grok.com) | Ndiyo (kikomo cha kasi kupitia claude.ai) |
Katika kiwango cha mtumiaji, Claude Pro ($20/month) is cheaper than SuperGrok ($30/mwezi). Katika kiwango cha API, Grok 4.1 ina unafuu kidogo wa gharama kuliko Claude Sonnet 4.6 kwa michakato ya tafsiri yenye uingizaji mkubwa wa data.
Ipi ni bora kwa aina maalum za maudhui?
| Aina ya maudhui | Modeli inayopendekezwa | Sababu |
|---|---|---|
| Habari za hivi karibuni / matukio ya sasa | Grok | Ufikiaji wa data wa wakati halisi; modeli zilizofundishwa kwa data tuli hukosa muktadha wa sasa |
| Istilahi zinazoibuka / uzinduzi wa bidhaa mpya | Grok | Ujumuishaji wa utafutaji wa moja kwa moja unanasa mifumo ya hivi karibuni ya matumizi |
| Nyaraka rasmi za kisheria | Claude | Tathmini huru ya WMT24 na Lokalise 2025; usahihi wa toni |
| Maudhui ya matibabu / kliniki | Claude | Hadhi ya kigezo huru; uhifadhi wa sajili |
| Nakala ya uuzaji / maudhui ya ubunifu | Claude | Upendeleo wa utafiti wa upofu wa Lokalise 2025; hila za toni |
| Nyaraka za kiufundi (ndefu) | Claude | Dirisha la muktadha la 200K-1M; uthabiti wa istilahi katika urefu wote |
| Mitandao ya kijamii / maudhui ya mazungumzo | Yoyote | Zote mbili hushughulikia vizuri jozi za mazungumzo zenye rasilimali nyingi |
| Msanidi programu / ujumuishaji wa API | Yoyote | Zote mbili zinatoa ufikiaji wa API; Grok ni ya bei nafuu kidogo kwenye tokeni za uingizaji |
Nini cha kutumia wakati model moja haitoshi
Zote mbili Grok na Claude ni zana za model moja. Kila modeli ya AI pekee (bila kujali jinsi ilivyo na uwezo) huzalisha makosa ambayo haiwezi kuyatambua katika matokeo yake yenyewe. Tafsiri fasaha na ya kujiamini kutoka kwa ama Grok au Claude bado inaweza kuwa na makosa ya kimaana, na bila uhakiki mtambuka hakuna njia ya kujua.
Zote mbili Grok na Claude ni miongoni mwa modeli 22 katika mfumo wa SMART wa MachineTranslation.com. SMART inaendesha modeli zote 22 kwa wakati mmoja (ikiwa ni pamoja na Grok na Claude) na inatoa matokeo ambayo wengi wanakubaliana nayo.
Hii ina maana gani kwa swali la Grok dhidi ya Claude: Nguvu ya muda halisi ya Grok na kina cha muktadha cha Claude vyote viwili vinachangia kwenye mwafaka ule ule. Wanapokubaliana, makubaliano hayo ni ishara dhabiti ya ubora.
Katika vigezo vya ndani vya MachineTranslation.com, modeli binafsi za kiwango cha juu hupata alama 93-94 kati ya 100 kwenye ubora wa tafsiri. Matokeo ya makubaliano ya SMART yanafikia 98.5/100. Chanzo: Vigezo vya ndani vya utendaji vya MachineTranslation.com na Matokeo ya Jumla ya Tafsiri ya Mashine ya WMT24.
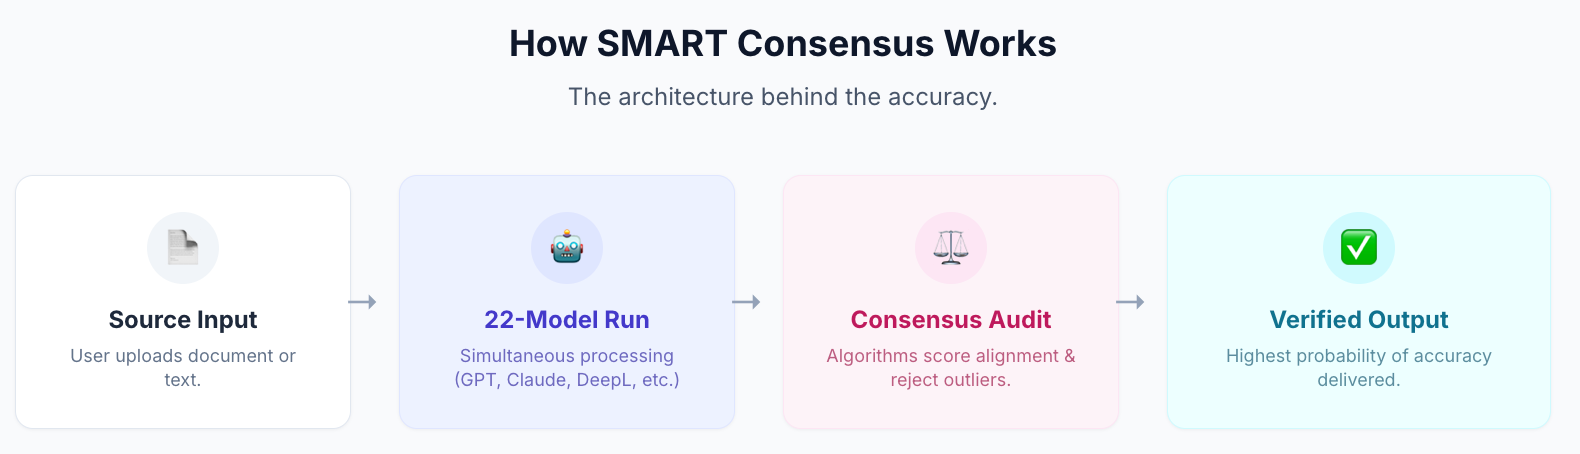
Watumiaji waliobadilisha kutoka tafsiri ya injini moja kwenda SMART walitumia muda mchache zaidi kwa 27% kuthibitisha na kusahihisha matokeo. Chanzo: MachineTranslation.com data ya ndani.
Kwa maudhui yenye athari kubwa (nyaraka za kisheria, nyaraka za udhibiti, maelekezo ya matibabu), Uthibitishaji wa Kibinadamu hupandisha muafaka wa SMART hadi kwa mkaguzi wa kitaalamu aliyeidhinishwa ndani ya jukwaa lile lile. Hakuna wakala wa nje. Usahihi wa 100% umehakikishwa.
Tafsiri ukitumia Grok, Claude, na mifano mingine 20 kwenye MachineTranslation.com — bila malipo, hakuna usajili unaohitajika.
Maswali yanayoulizwa mara kwa mara
1. Je, Grok ni bora kuliko Claude kwa tafsiri?
Kwa kazi nyingi za kawaida za tafsiri, Claude inaongoza kwenye vigezo huru vya tathmini: ikishika nafasi ya kwanza katika jozi 9 kati ya 11 za lugha kwenye WMT24, ukadiriaji wa 78% wa nzuri katika utafiti wa siri wa Lokalise wa 2025, na 93.8/100 katika vigezo vya ndani vya ubora vya MachineTranslation.com. Faida mahususi ya Grok ni kwa maudhui yanayohitaji maarifa ya matukio ya sasa, ufikiaji wake wa data wa wakati halisi unaipa muktadha ambao mifano iliyofundishwa kwa data tuli ikijumuisha Claude haina. Kwa habari za hivi karibuni, istilahi zinazoibuka, na maudhui yanayotegemea wakati, Grok ni chaguo thabiti zaidi.
2. Ni nini faida ya Grok dhidi ya Claude kwa ajili ya tafsiri?
Grok inaunganisha data ya muda halisi kutoka X (zamani Twitter) na utafutaji wa mtandao wa moja kwa moja. Tofauti na Claude na LLMs nyingine nyingi zilizofundishwa kwenye seti za data tuli, Grok inaweza kupata taarifa kuhusu matukio ya hivi karibuni, istilahi mpya zilizobuniwa, na muktadha wa sasa wakati wa kuzalisha tafsiri. Hii inaifanya kuwa imara zaidi hasa kwa kutafsiri maudhui ya habari, bidhaa zilizotolewa hivi karibuni, na nyenzo yoyote ambapo maana inategemea matukio au mifumo ya lugha ya wiki chache zilizopita.
3. Je, ni nini ubora wa Claude dhidi ya Grok katika kutafsiri?
Ubora wa Claude umerekodiwa kupitia tathmini huru ya kitaalamu. Claude 3.5 ilishika nafasi ya kwanza katika jozi 9 kati ya 11 za lugha kwenye WMT24, na watafsiri wa kitaalamu katika utafiti wa upofu wa 2025 wa Lokalise walipendelea matokeo yake kwa kiwango cha 78% cha nzuri — cha juu zaidi kati ya LLM yoyote iliyofanyiwa majaribio. Claude pia inaonekana katika suluhisho 14 bora za Intento kwenye jozi mbalimbali za lugha katika tathmini ya kibinadamu ya LQA, wakati Grok haionekani. Kwa kazi za tafsiri rasmi, za kitaalamu, na zenye umuhimu mkubwa, hadhi ya Claude katika vipimo huru vya ulinganishi ndicho kigezo cha utofautishaji kilichothibitishwa.
4. Ipi ni bora kwa tafsiri ya kisheria, Grok au Claude?
Claude ndilo chaguo thabiti zaidi kwa tafsiri ya kisheria kulingana na tathmini huru. Claude 3.5 ilishika nafasi ya kwanza katika jozi nyingi za lugha za Ulaya zenye rasilimali nyingi kwenye WMT24 na ilipokea makadirio ya juu zaidi ya upendeleo ya utafiti wa upofu kutoka kwa watafsiri wa kitaalamu. Kwa maudhui ya kisheria yanayohitaji usahihi uliothibitishwa, hakuna modeli pekee inayotosha — Uhakiki wa Kibinadamu wa MachineTranslation.com unatoa usahihi wa 100% kutoka kwa mkaguzi wa kitaalamu aliyeidhinishwa ndani ya jukwaa lile lile, hakuna mtoa huduma wa nje anayehitajika.
5. Je, Grok na Claude zote mbili zinapatikana kwenye MachineTranslation.com?
Ndiyo. Zote mbili ni miongoni mwa modeli 22 katika mfumo wa SMART wa MachineTranslation.com. Kila tafsiri ya SMART huendesha Grok, Claude, na mifano mingine 20 kwa wakati mmoja, ikirejesha matokeo ambayo wengi wanakubaliana nayo. Badala ya kuchagua kati yao, unapokea mwafaka wa miundo yote ya AI.
6. Je, Grok na Claude wanalinganaje kuhusu bei?
Katika kiwango cha watumiaji, Claude Pro inagharimu $20/month versus SuperGrok at $30/mwezi. Katika kiwango cha API, Grok 4.1 ni ya bei nafuu kidogo kwenye input tokens ($2/M vs. $3/M kwa Claude Sonnet 4.6) na kwenye output ($10/M vs. $15/M). Mpango wa bure wa MachineTranslation.com unajumuisha modeli zote mbili kama sehemu ya mwafaka wa modeli 22 wa SMART, bila kuhitaji kujisajili.
7. Ni modeli gani ya AI iliyo bora zaidi kwa kutafsiri makala za habari?
Kwa kutafsiri makala za habari, Grok ina faida ya kimuundo: uunganishaji wake wa data wa wakati halisi unamaanisha kuwa ina muktadha wa sasa kuhusu matukio yanayoelezewa, ambao modeli zilizofundishwa kwa data tuli zinaweza kukosa. Kwa tafsiri ya habari za jumla ambapo usasa si muhimu sana, utendaji wa benchmark wa Claude ni thabiti zaidi. Kwa tafsiri ya habari ya kiasi kikubwa ambapo upya na usahihi vyote ni muhimu, SMART ya MachineTranslation.com huendesha miundo yote miwili na kurudisha matokeo ya muafaka wao.