September 9, 2026
Qwen vs DeepSeek: Vilken AI-modell översätter bäst?
Kör samma 12,000 översättningssegment genom Qwen och DeepSeek, och DeepSeek vinner i majoriteten av språkparen. Det är inte hela historien. Dela upp resultaten efter riktning, så framträder ett specifikt mönster: Qwen minskar det mesta av klyftan, och tar ibland ledningen, särskilt när målspråket är engelska. Vid översättning från engelska till något annat språk vinner DeepSeek nästan varje gång.
Den uppdelningen spelar större roll än en enda total vinnare om du översätter innehåll till dussintals språk snarare än bara ett språkpar.
Vad är Qwen och DeepSeek?
Qwen är Alibabas familj av stora språkmodeller. Den nuvarande generationen är Qwen3.8, som släpptes i augusti 2026: Qwen3.8-Max är det stängda flaggskeppet med enbart API-åtkomst och 2.4 biljoner parametrar, medan Qwen3.8-27B är en mindre modell med öppna vikter som släpptes under Apache 2.0 några dagar senare, riktad till team som vill hosta själva.
DeepSeek är ett kinesiskt AI-laboratorium känt för mixture-of-experts-modeller som matchar prestanda i absolut framkant till en bråkdel av inferenskostnaden. Dess nuvarande generation, DeepSeek V4, lanserades i april 2026 i två varianter: V4 Pro (1.6 biljoner totala parametrar, cirka 49 miljarder aktiva per token) för kvalitetsfokuserat arbete, och V4 Flash (284 miljarder totalt, cirka 13 miljarder aktiva) för latenskänsliga arbetsbelastningar. Båda levereras som MIT-licensierade öppna vikter.
Hur står sig Qwen och DeepSeek egentligen mot varandra vid översättning, och inte bara i benchmarktester?
De flesta jämförelser mellan Qwen och DeepSeek hänvisar till generella benchmarktester: kodning, matematik, resonemang. Inget av dessa mäter översättningskvalitet direkt, och att köra respektive modell på olika källtexter gör det omöjligt att isolera eventuella skillnader i noggrannhet från vad själva texten krävde.
MachineTranslation.com:s egen översättningstrafik under de senaste 28 dagarna ger ett tydligare svar, eftersom båda modellerna översatte exakt samma källtext. Över 98 språkpar och mer än 12 000 matchade segment fick DeepSeek högre poäng i 83 par; Qwen fick högre poäng i 15. Om man snävar ner det till de 27 par där målspråket är engelska krymper klyftan kraftigt: DeepSeek vinner 63% av dem (17 av 27), Qwen vinner 37% (10 av 27). Över de återstående 71 paren, där engelska inte är målspråket, vinner DeepSeek 92% (66 av 71).
Vinstfrekvens per översättningsriktning (98 språkpar, identisk text)
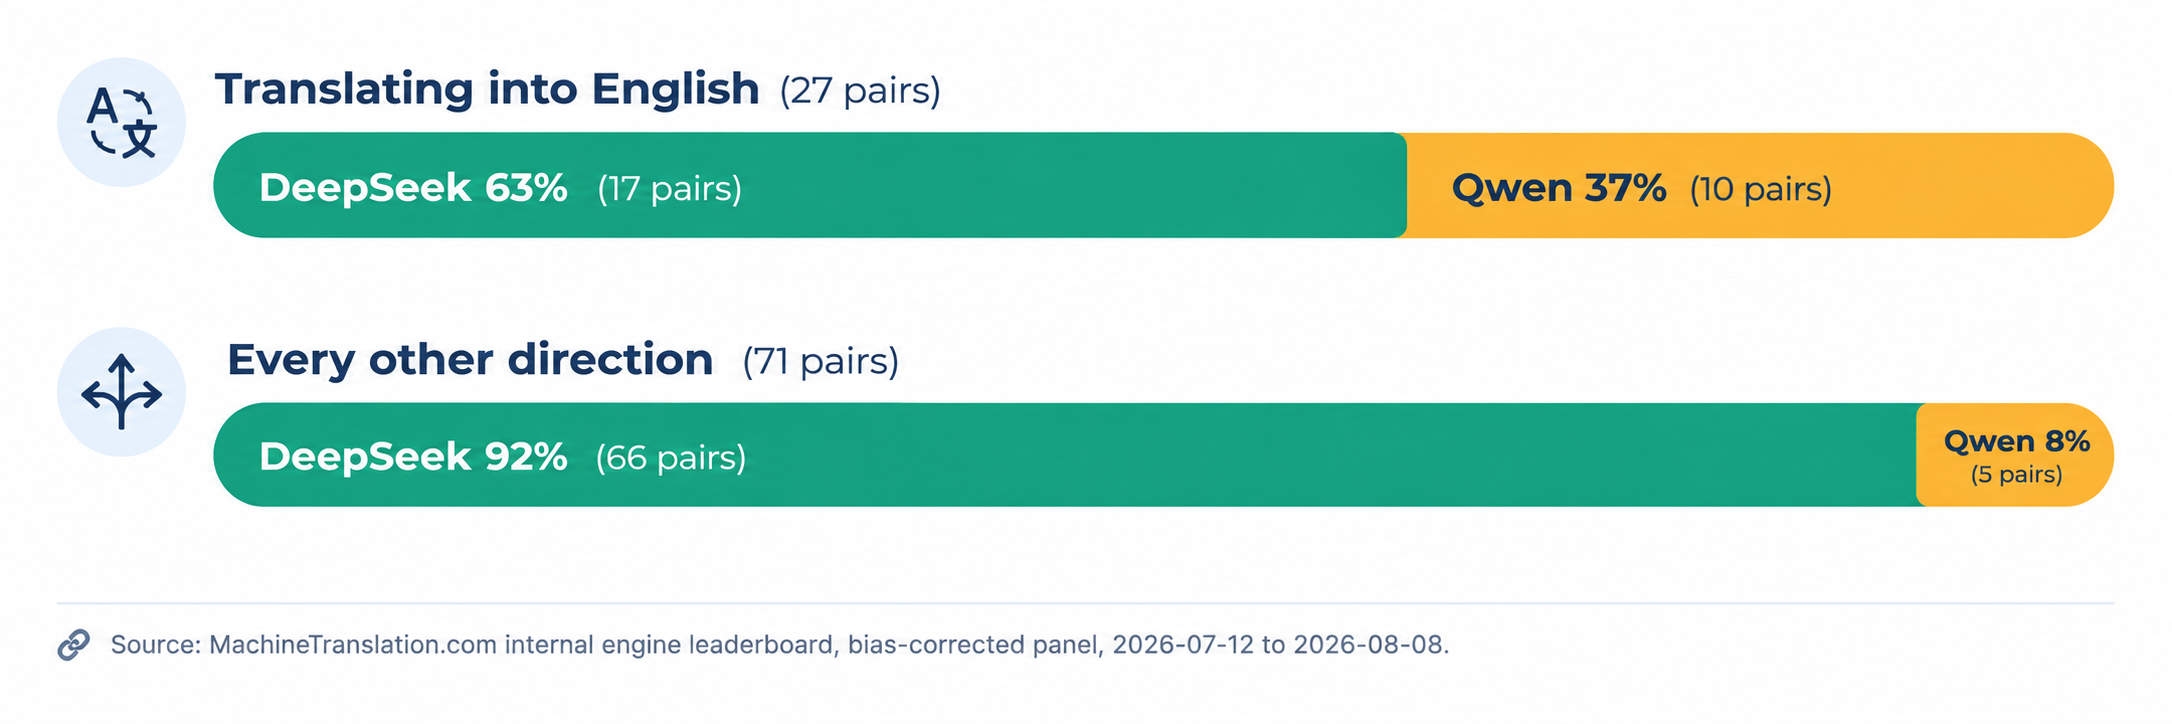
DeepSeek vinner den stora majoriteten av språkparen totalt sett. Qwens konkurrensfönster är smalt men reellt: vid översättning till engelska, där den tar hem mer än en tredjedel av paren. Data: MachineTranslation.com:s interna motor-topplista, bias-korrigerad panel, July 12 to August 8, 2026.
Det viktade genomsnittet över varje matchat segment placerar DeepSeek på 9.13 av 10 och Qwen på 8.98. Det är en reell klyfta, men den är inte jämnt fördelad, vilket är mer användbart att veta om ditt innehåll rör sig i mer än en riktning. Detta är samma direktjämförande metod som MachineTranslation.com använder i sina fullständiga modelljämförelsetester, inte bara för just detta par.
De sammanställda siffrorna står sig även i enskilda testfall. Vid testning av den franska frasen ”Elle est directrice adjointe du département commercial” enades DeepSeek och Qwen om samma engelska översättning, ”deputy director of commercial department”. Du kan kontrollera det live-testresultatet direkt. Vid testning av ”as soon as possible” översatt till spanska avvek DeepSeek från konsensus bland de fyra modellerna med ”esté hecho” istället för ”se haga”, vilket är ett reellt avvikelsefall som återspeglar en grammatisk skillnad mellan process och resultat, inte ett misstag.
Varför presterar Qwen bättre specifikt vid översättning till engelska?
Data förklarar inte varför, bara var. Några av Qwens starkaste par till engelska är tamil, kinesiska, polska, italienska och hebreiska, vilket är källspråk med stora, väldokumenterade engelskspråkiga träningskorpusar som i allmänhet är tillgängliga för modellutvecklare. Utanför den specifika riktningen kvarstår DeepSeeks fördel nästan överallt: både från engelska och mellan icke-engelska språkpar.
Vad detta utesluter är att behandla någon av modellerna som en universell standard. Ett team som översätter produktbeskrivningar från spanska till sex språk och förväntar sig samma prestandarankning som de såg när de översatte ett kinesiskt supportärende till engelska, skulle tillämpa fel läxa från fel riktning – vilket är samma asymmetri som visas i MachineTranslation.coms modelluppdelning för spanska till engelska, där de ledande modellerna inte är desamma som leder i den omvända riktningen.
Är Qwen och DeepSeek gratis och med öppen källkod?
Licensieringen skiljer sig åt för respektive modell. DeepSeek licensierar både V4 Pro och V4 Flash under MIT, ett av de mest tillåtande licensvillkoren för öppen källkod som finns, så båda är gratis att drifta själv utan begränsningar. Qwen är uppdelad: Qwen3.8-27B levereras under Apache 2.0 och är gratis att drifta själv, men flaggskeppet Qwen3.8-Max förblir stängt, endast tillgängligt via API, och under Alibabas egen anpassade licens.
I praktiken innebär det att det finns ett alternativ med helt öppna vikter (open-weight) och MIT-licens på DeepSeeks sida på båda kvalitetsnivåerna. På Qwen-sidan innebär det att man går miste om flaggskeppsmodellen om man vill ha öppna vikter.
Vad kostar det att köra Qwen och DeepSeek i stor skala?
Efter DeepSeeks permanenta prissänkning i maj 2026 är dess nuvarande publicerade API-priser $0.435 per million input tokens (cache miss) and $0.87 per miljon utdatatokens för V4 Pro, med V4 Flash prissatt lägre för sin latensoptimerade nivå.
För team som själva driftar någon av modellerna istället för att använda ett hostat API, skiftar kostnadsjämförelsen helt till GPU-infrastruktur och blir en funktion av parameterantal och aktiv parametereffektivitet snarare än ett pris per token.
Är någon av modellerna tillräckligt säker för juridiskt, medicinskt eller reglerat innehåll?
Ingen av modellerna publicerar översättningsspecifika säkerhetscertifieringar, och allmänna säkerhetsbenchmarks testar inte för de feltyper som är viktiga i reglerat innehåll: en felöversatt dosering, en ändrad ansvarsklausul eller en inkonsekvent juridisk term. MachineTranslation.coms egna tester har funnit exakt den här typen av avvikelser mellan modeller i juridiskt och medicinskt språk, inklusive fall där modellerna använde olika juridiska termer med olika räckvidd trots att båda fick höga poäng i allmänna kvalitetsmätningar.
När det gäller kontrakt, immigrationsdokument eller kliniskt innehåll talar detta för att para ihop båda modellernas utdata med ett mänskligt verifieringssteg snarare än att lita blint på ett enda AI-resultat, oavsett vilken modell som genererade det.
Vad innebär detta om du lokaliserar till många språk samtidigt?
En jämförelse som bygger på ett enda språkpar säger dig nästan ingenting om språkpar nummer fyrtio. Uppdelningen till engelska/från engelska som dokumenteras här gällde för ett urval på 98 par specifikt eftersom det testades i den skalan: ett enskilt test från engelska till spanska, vilket är vad de flesta jämförelser mellan Qwen och DeepSeek kör, skulle ha visat att DeepSeek låg bekvämt före och inte sagt någonting om vad som händer när tamil, polska eller hebreiska kommer in i bilden.
Det är det praktiska argumentet för att inte låsa ett stort lokaliseringsprogram till en modells utdata som standard. MachineTranslation.com kör både Qwen och DeepSeek, tillsammans med mer än 20 andra modeller, på varje översättning och lyfter fram den version som dessa modeller är mest överens om, så att en utrullning på 68 språk inte är beroende av vilken modell som råkade vinna det enda par som någon testade först. Du kan se exakt vilka modeller som var överens eller skilde sig åt för en given översättning i den modelluppdelning per översättning som plattformen visar för varje resultat.
Varje översättning kontrolleras mot ett bredare urval av modeller än vad antingen Qwen eller DeepSeek ensamma kan erbjuda, vilket är det direkta svaret på vad som händer när ditt innehåll slutar att bara röra sig i en riktning.
Vanliga frågor
1. Är Qwen eller DeepSeek bäst för översättning?
Av 98 testspråkpar med identisk källtext fick DeepSeek högre poäng i 83 av dem. Qwens vinster koncentreras till en specifik riktning: översättning till engelska, där den vinner ungefär en tredjedel av gångerna. I alla andra riktningar vinner DeepSeek mer än 90% av gångerna.
2. Är Qwen gratis att använda?
Qwen3.8-27B har öppna vikter under Apache 2.0 och är gratis att drifta själv. Flaggskeppet Qwen3.8-Max är stängt och endast tillgängligt via Alibaba Clouds betalda API.
3. Är DeepSeek gratis att använda?
Ja. Både DeepSeek V4 Pro och V4 Flash levereras med MIT-licensierade öppna vikter, så du kan self-hosta båda utan någon licenskostnad. DeepSeek erbjuder även ett betalt API för team som inte vill hantera sin egen infrastruktur.
4. Vilken är snabbare, Qwen eller DeepSeek?
DeepSeek V4 Flash är byggd specifikt för låg latens, med 13 miljarder aktiva parametrar per token jämfört med V4 Pros 49 miljarder. Qwens motsvarande lättare alternativ, Qwen3.8-27B, är dense snarare än mixture-of-experts, vilket generellt gör den långsammare per token vid jämförbar kvalitet.
5. Kan jag använda Qwen och DeepSeek tillsammans för översättning?
Ja. MachineTranslation.com kör båda modellerna, plus över 20 andra, för varje översättning och lyfter fram den version som de är mest överens om, så du slipper fastna vid att välja en modell och hoppas att den är det starkare valet för just det språkparet.
6. Vad är skillnaden mellan Qwen och DeepSeeks licensiering?
DeepSeek licensierar båda V4-varianterna under MIT, en av de mest tillåtande open source-licenserna som finns. Qwen delar upp sitt utbud: mindre modeller som Qwen3.8-27B levereras under Apache 2.0, men flaggskeppet Qwen3.8-Max förblir stängd under en anpassad licens.